
Creación de una red neuronal para detectar bocinas de tren

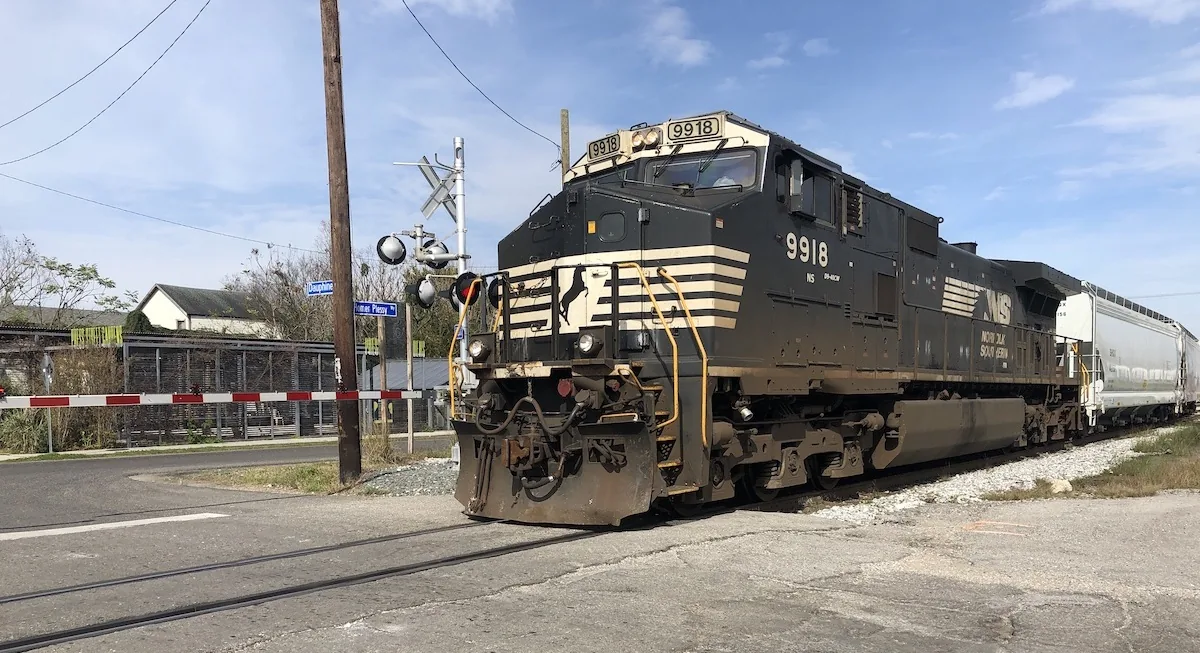
El sospechoso en cuestión
Resulta que vivo cerca de una vía de tren, y ese tren toca la bocina bastante a lo largo del día y de la noche. Además, las vías atraviesan el barrio por cinco o seis calles sin barreras automáticas que impidan el paso. Por eso, antes de cruzar cada calle, el tren está obligado a hacer sonar la bocina durante un buen rato. Como ejercicio terapéutico, decidí intentar detectar y cuantificar ese comportamiento. También esperaba poder comprobar en tiempo real si el tren está bloqueando la calle, algo bastante molesto cuando uno va con prisa y se queda atrapado detrás del tren. Esta entrada cuenta mi proyecto de fin de semana para lograrlo.
Resumen
Tras un fin de semana de programación, conseguí un detector de bocinas de tren preciso, funcionando en vivo con un micrófono colocado fuera de mi ventana. Puede obtener el código para entrenar la red en GitHub.
También publico las detecciones en directo aquí: BywaterTrain.com
Red neuronal
No tengo experiencia en clasificación de audio, así que hice unas búsquedas rápidas en Google con la esperanza de que alguien ya hubiera resuelto un problema parecido. Mi restricción era que el modelo fuera lo bastante rápido para procesar audio en vivo desde el micrófono. Como no tenía muchos datos etiquetados, buscaba una red del tipo «ImageNet del audio» que pudiera ajustar (fine-tuning) con un conjunto de datos muy pequeño. Yamnet, de Google, parecía cumplir varios de esos requisitos, así que me decidí por ella.
Yamnet
Según Google: «YAMNet es una red profunda preentrenada que predice 521 clases de eventos de audio a partir del corpus AudioSet-YouTube, y emplea la arquitectura de convoluciones separables en profundidad Mobilenet_v1». Que use Mobilenet_v1 significa que probablemente es lo bastante rápida, y que esté preentrenada con un conjunto de datos grande es aún mejor.
El conjunto de datos AudioSet-YouTube de Google es interesante por sí mismo. Creado a partir del audio de clips de YouTube, se puede descargar como archivos .csv que apuntan al momento exacto dentro del video de YouTube, o como un vector de características de 128 bits generado por su arquitectura de estilo VGG (véase aquí).
El conjunto de datos ya contenía varias categorías relacionadas con trenes, pero la precisión que daba con mis datos no era suficiente, así que decidí ajustar una red adicional sobre la salida de Yamnet.
Si sus datos pertenecen a alguna de las 521 clases, tal vez pueda usar directamente la salida de Yamnet sin tener que entrenar nada.
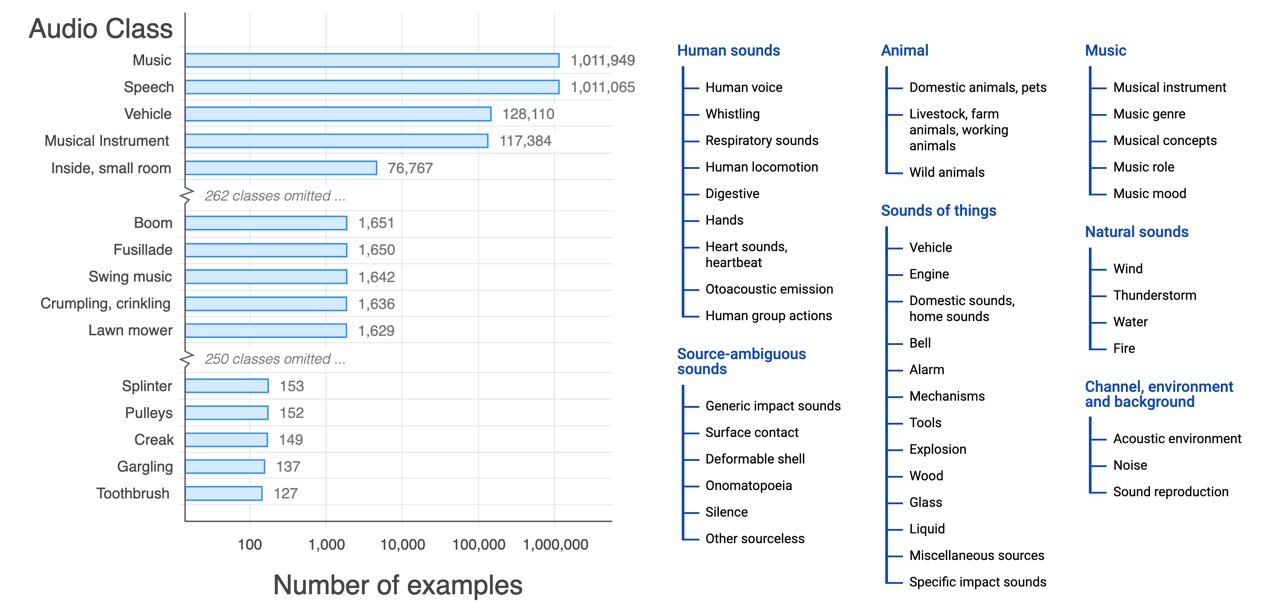
Conjunto de datos de audio de YouTube
Creación de los datos de entrenamiento
Grabé clips de audio cortos con el micrófono de mi computadora y los etiqueté como positivos (bocina de tren) o negativos (todo lo demás). Terminé con unos 200 clips cortos en total, lo cual no es mucho, pero pareció funcionar bien para el ajuste fino.
El modelo Yamnet procesa el audio en ventanas de 0,96 segundos, así que dividí mis grabaciones en fragmentos de esa duración. Cada fragmento lo pasé por Yamnet para obtener el vector de incrustación (embedding) de 1024 dimensiones, que usé como entrada para entrenar un clasificador sencillo encima.
Resultados
¡El modelo final funciona sorprendentemente bien! Detecta bocinas de tren en tiempo real con gran precisión. Los falsos positivos son poco frecuentes y capta la mayoría de los eventos de bocina a lo largo del día.
Lo he tenido funcionando de forma continua en una Raspberry Pi con un micrófono USB barato, registrando todas las detecciones en una base de datos. Los datos muestran patrones interesantes sobre cuándo pasan los trenes por el barrio.
¡Consulte las detecciones en directo en BywaterTrain.com!
Código
El código de entrenamiento y la arquitectura del modelo están disponibles en GitHub: github.com/laanlabs/train_detector
¡Siéntase libre de adaptar este enfoque para detectar otros sonidos, como alarmas de coches, ruido de obras o cualquier evento sonoro que le interese registrar!
Trabaje con Laan Labs
Desarrollo de visión por computador e IA
Visión por computador y aprendizaje automático a medida, de la prueba de concepto a la producción, en el dispositivo y en la nube.
Descargar este artículo
Obtenga el código fuente en Markdown para leerlo sin conexión