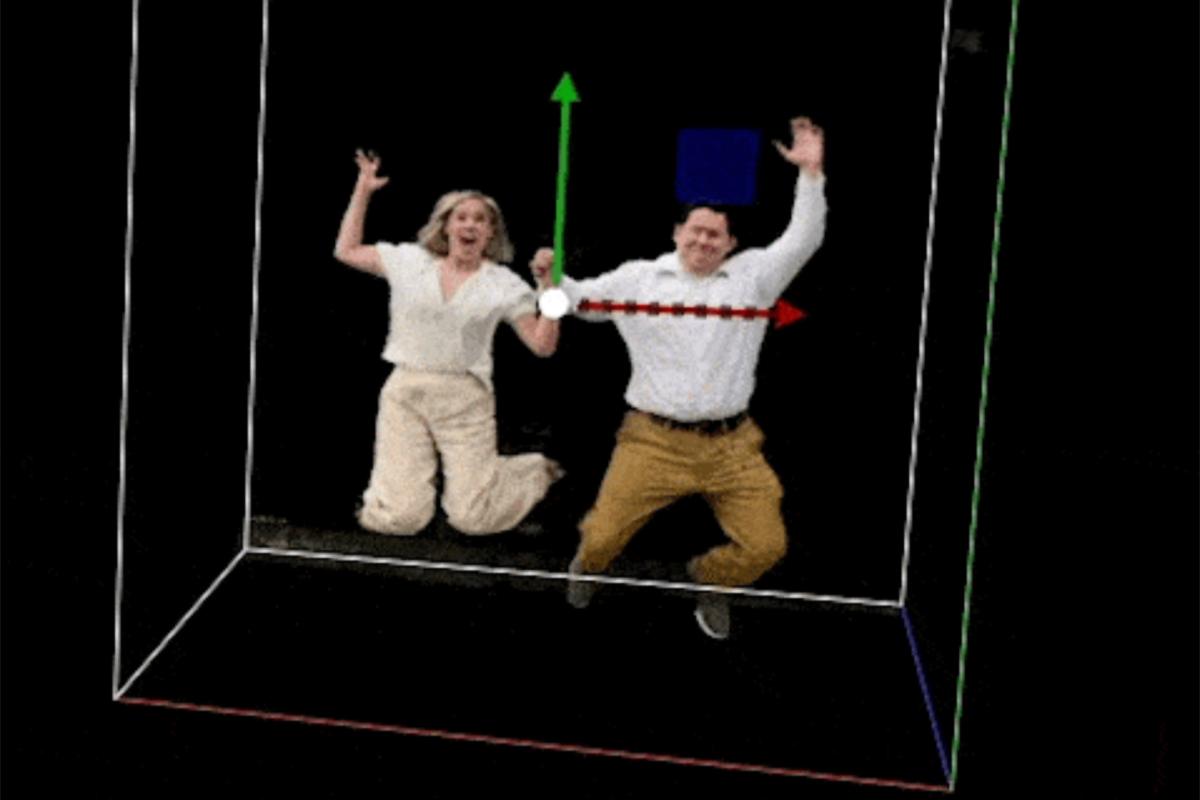
«Bullet Time» en cámara lenta con NeRF

Resumen
Usamos NeRF y 15 iPhones para grabar video volumétrico 3D de «Bullet Time»
Bullet Time con NeRF
Video completo
Descripción general
Mi primo se casaba el mes pasado y hacíamos una sesión de fotos familiar con motivo de la boda. Aproveché la ocasión para retomar una idea con la que llevábamos tiempo experimentando. La idea básica era reunir a un grupo de amigos para capturar una escena desde distintos ángulos con teléfonos móviles. El resultado final sería un fotograma congelado o un video de Bullet Time como los de Matrix.
Cuando jugamos por primera vez con la idea, hace años, los NeRF no existían, así que no teníamos una buena manera de realizar una «síntesis de vistas» de alta calidad. Aquí «síntesis de vistas» significa simplemente renderizar imágenes de una escena desde puntos de vista distintos de aquellos con los que se capturó originalmente.
NeRF
Los NeRF, o campos de radiancia neuronales (Neural Radiance Fields), han irrumpido rápidamente en escena como un nuevo método asombroso para la síntesis de vistas y la reconstrucción 3D.
Los campos de radiancia neuronales son un método para representar y renderizar escenas 3D mediante aprendizaje profundo. La idea principal de los NeRF es usar una red neuronal para predecir la radiancia de una escena en cada punto del espacio 3D. Dado un conjunto de imágenes de entrada de una escena, la red neuronal aprende a predecir la estructura 3D de la escena, así como la reflectancia de las superficies y la iluminación en cada punto. La representación resultante es una función continua que se puede evaluar en cualquier punto del espacio 3D, lo que permite renderizar la escena de forma muy realista desde cualquier punto de vista. Los NeRF pueden producir renders fotorrealistas y de alta calidad de escenas 3D complejas, y tienen el potencial de revolucionar el campo de los gráficos por computadora.
El campo avanza tan deprisa que casi a diario aparecen nuevos enfoques y mejoras.
Puede leer más sobre los NeRF aquí, leer el artículo original aquí o ver algunos renders de NeRF espectaculares en YouTube.
En 2021, NVIDIA lanzó Instant NGP, un conjunto de herramientas de código abierto para crear NeRF rápidamente a partir de imágenes o video. Instant NGP redujo el tiempo de entrenamiento de los NeRF de días a minutos.
El bullet time con NeRF ya se ha hecho antes, y las nuevas extensiones de los NeRF permiten representar escenas dinámicas añadiendo un componente temporal a los modelos NeRF existentes. (Véanse los «NeRF dinámicos», como DNerf)
Dado que era un proyecto paralelo, divertido y rápido, no pude probar los enfoques más recientes y opté por la facilidad de uso y los tiempos de entrenamiento rápidos que ofrece Instant NGP.
Nerfstudio es otro conjunto de herramientas de entrenamiento de NeRF que merece la pena consultar. Incluso admite «DNerf» para escenas dinámicas, pero todavía no he tenido ocasión de probarlo.
La investigación sobre los NeRF avanza tan rápido que dentro de unos meses probablemente habrá métodos mejores y más rápidos para crear algo así.
Captura de los videos
El primer requisito del proyecto es capturar videos en cámara lenta de una escena desde distintos ángulos. Los iPhone más recientes pueden grabar video a 240 fotogramas por segundo con una resolución de 1920x1080, lo cual es suficiente para entrenar el NeRF.
Tras reunir todos nuestros dispositivos de prueba y preguntar a los familiares, conseguimos 15 iPhones. (Aunque lo habitual es que una escena de NeRF use más bien entre 40 y 100 imágenes.)
Después creé una sencilla aplicación con Firebase Realtime Database que me permite iniciar la grabación simultáneamente en todos los teléfonos. Una vez capturados los videos, se subían automáticamente a Google Cloud Storage.
Al pulsar grabar en un teléfono, se inicia la grabación en todos los dispositivos conectados.
Grabación sincronizada en varios teléfonos
La aplicación también muestra el nivel de batería y el estado de subida del video de cada dispositivo:
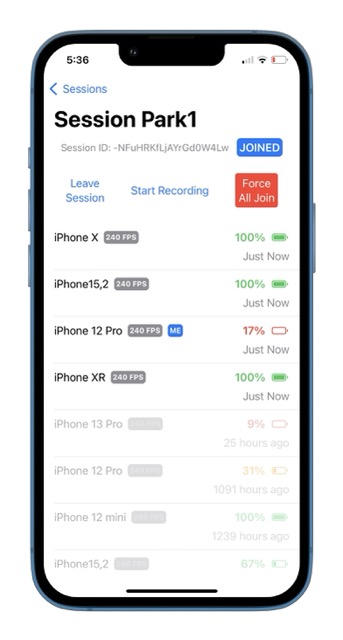
Trípodes para iPhone
Construimos unos trípodes básicos con madera barata y pedimos a algunos familiares que sostuvieran los demás teléfonos:
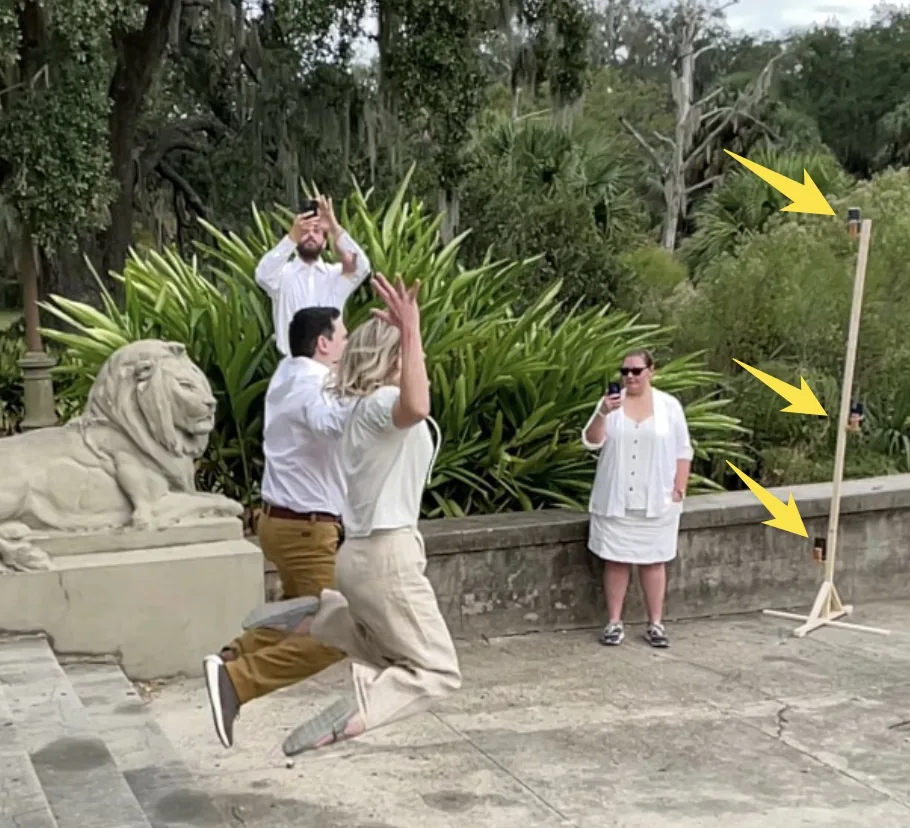
Montaje de captura con trípode
Aquí están algunas de las imágenes capturadas por los distintos teléfonos:
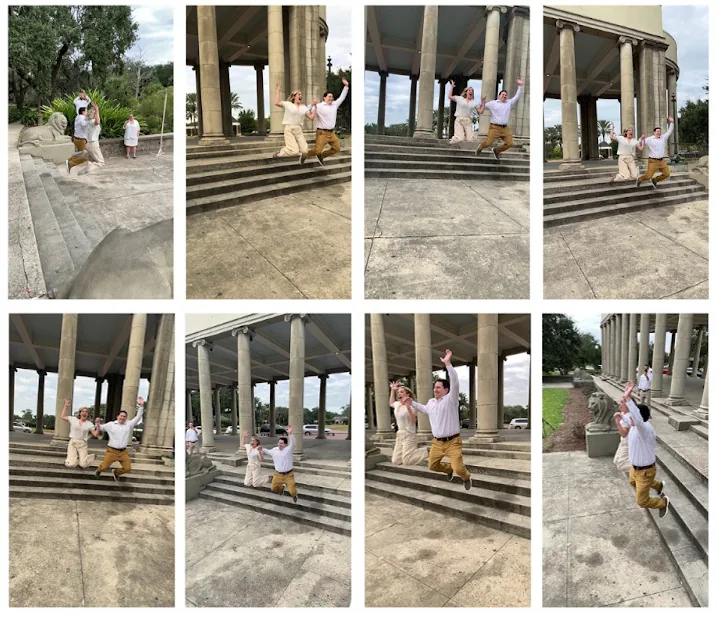
Imágenes de muestra
La aplicación bloqueaba el enfoque y la exposición al grabar, pero no sincronizaba esos valores entre los teléfonos, por lo que se aprecian algunas diferencias de color en las imágenes. Más sobre esto a continuación.
Teníamos una ventana de tiempo bastante corta, de unos 10 minutos, para montar y capturar la escena. Con más tiempo probablemente probaría distintas configuraciones de cámaras para ver cuál funciona mejor.
Sincronización temporal de los videos
Una vez capturados todos los videos, hay que sincronizarlos en el tiempo.
Como desarrollador, quise automatizar este proceso aunque, para hacerlo una sola vez, sincronizar los videos a mano era la opción más rápida.
Acabé escribiendo un pequeño script de Python que hace una correlación cruzada de las pistas de audio para encontrar el mejor desfase temporal entre dos videos.
Para hacerlo más robusto, llevamos dos varillas metálicas que entrechocamos al inicio de la grabación.
Formas de onda de audio de dos videos sin sincronizar:
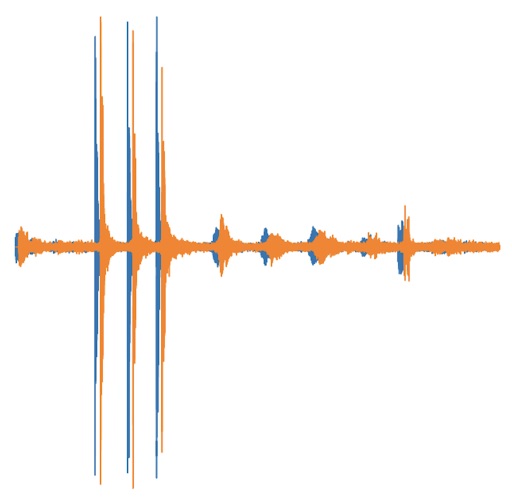
Alineación del audio
La correlación cruzada muestra un pico claro donde las dos señales tienen la máxima alineación:
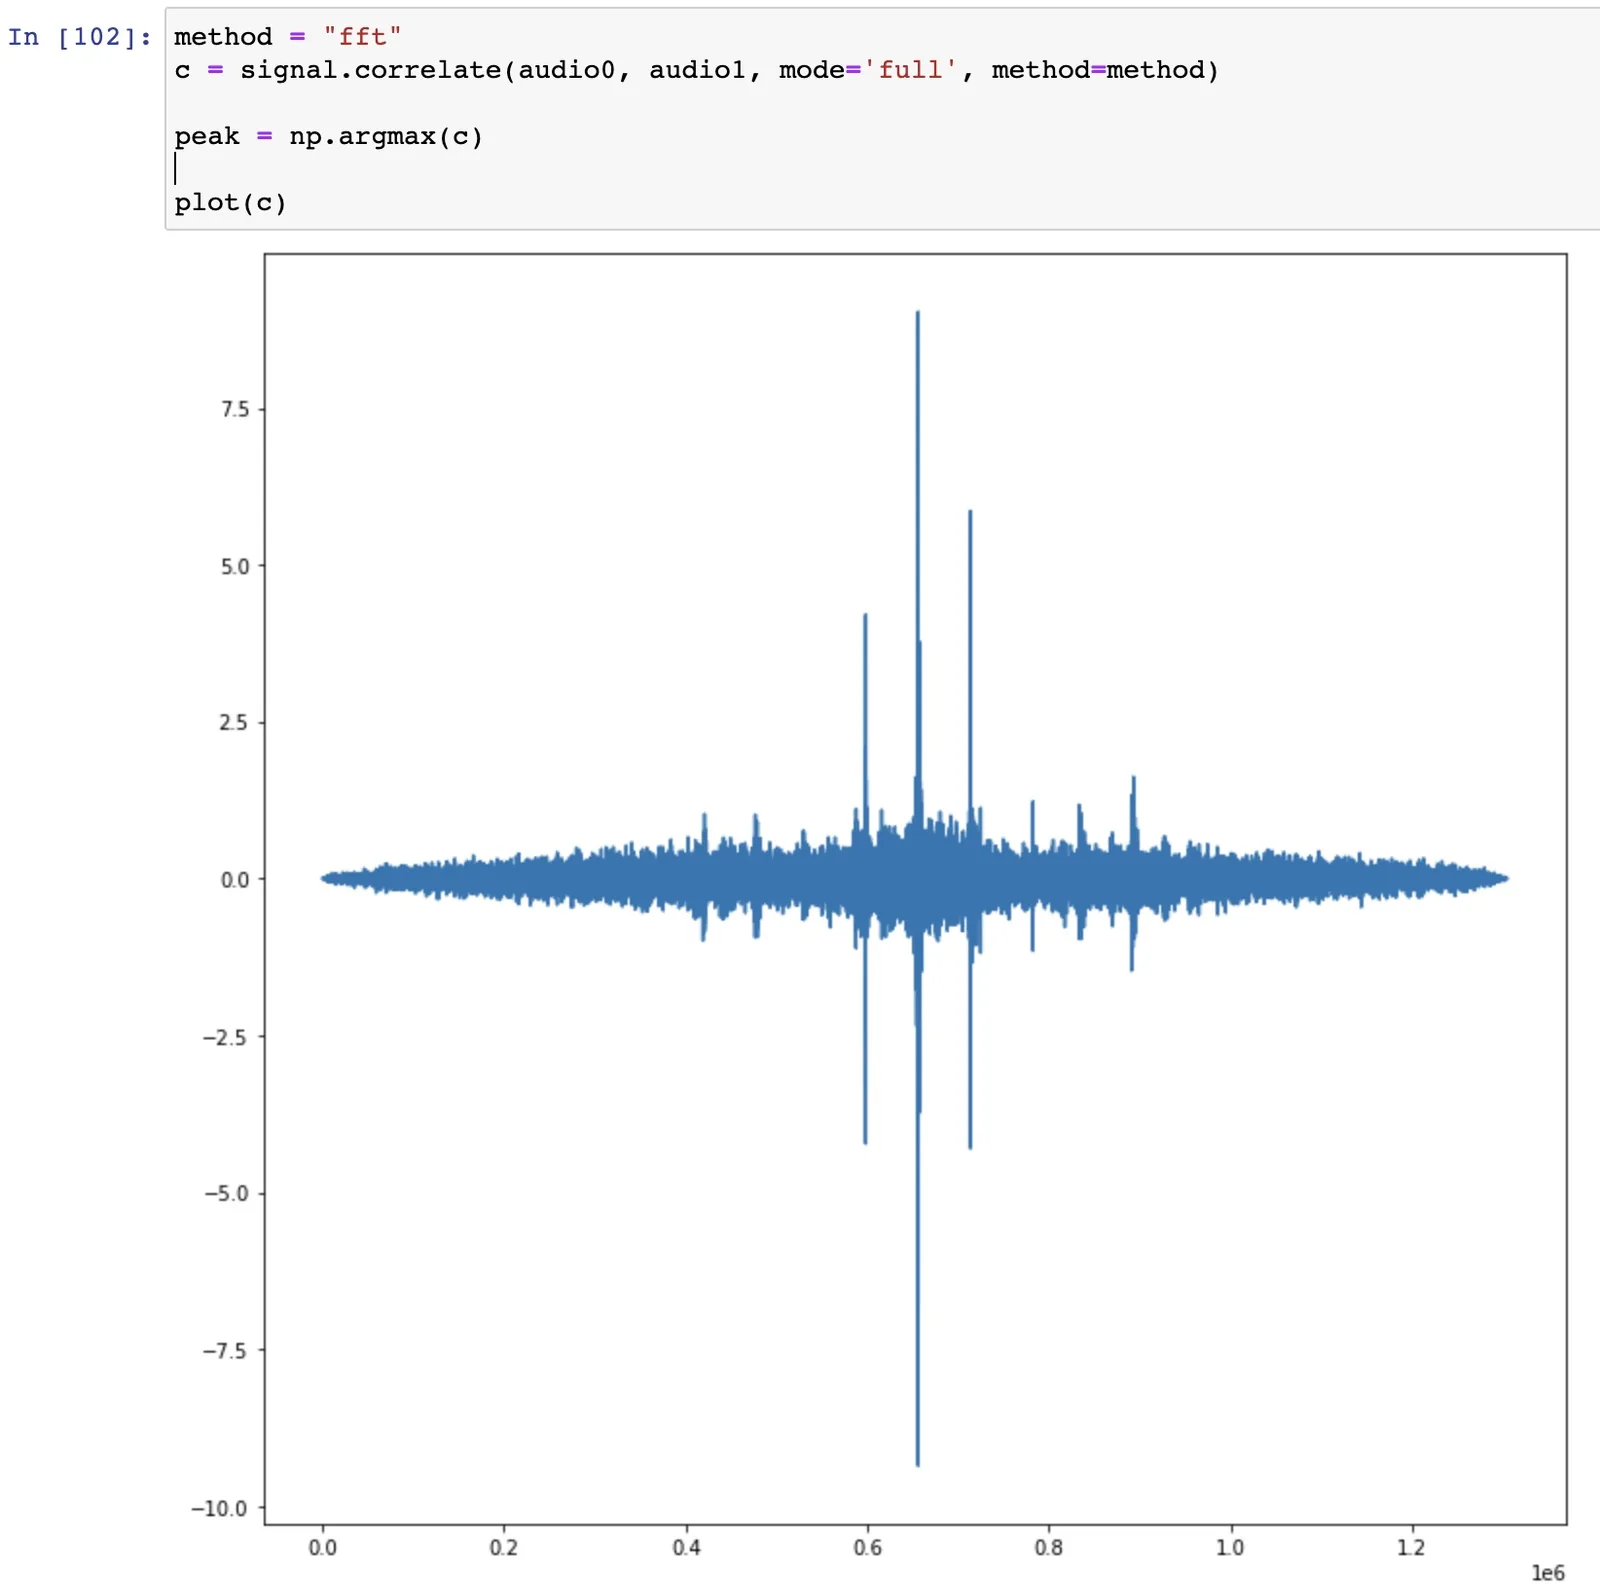
Correlación cruzada
Una vez alineados todos los videos en el mismo tiempo global, exporté un conjunto de unos 200 fotogramas sincronizados de los 15 teléfonos. Es decir, unas 3000 imágenes.
Entrenamiento de los NeRF
El siguiente paso es entrenar los NeRF con todos los datos; aquí surgieron algunos problemas que merece la pena mencionar.
Combinación de instantes de tiempo
Primero, algo de contexto sobre el proceso de entrenamiento de un NeRF:
El primer paso de un NeRF es calcular las poses de cámara de todas las imágenes de la escena. Para ello se usa COLMAP
En el caso del bullet time, tenemos tantas «escenas» como instantes de tiempo hay en nuestros videos exportados (es decir, 200 instantes)
Por tanto, necesitamos una forma de asegurarnos de que las poses de cámara estén alineadas en un sistema de coordenadas global que no cambie a lo largo del video.
Si ninguna cámara se mueve mientras se captura la escena, esto es bastante sencillo: basta con calcular las poses del primer fotograma y reutilizarlas en todos los siguientes. En mi caso, había personas sosteniendo algunos de los teléfonos durante la captura, y esos teléfonos se movieron ligeramente mientras grababan.
Con solo 15 cámaras en total, no quería perder los ángulos de cámara vitales de los teléfonos que se movieron un poco. Esto exigió calcular las poses de cámara de las cámaras dinámicas para cada uno de los 200 instantes.
Si pudiera elegir, la próxima vez optaría por cámaras totalmente estáticas sobre trípodes, ya que simplifica mucho el proceso de recuperación de poses.
Probé varios enfoques distintos, pero me decidí por personalizar ligeramente COLMAP para permitir la reconstrucción incremental de la escena.
El enfoque que adopté parte de una escena «de fondo» en la que las poses de cámara se calculan una vez y permanecen fijas mientras se le añaden imágenes nuevas. La escena de fondo se capturó sin personas, así que pude moverme libremente con un solo teléfono y capturar muchas imágenes.
Cada «instante» del video tiene 15 imágenes, una por cada cámara que graba. Así que, para cada instante, partimos de la escena de fondo y luego le añadimos las imágenes nuevas fijando las poses de cámara de la escena de fondo. COLMAP admite añadir imágenes nuevas a una escena estática existente mediante la opción «--Mapper.fix_existing_images», pero por desgracia sigue modificando las poses de cámara base durante el paso de ajuste de haces (bundle adjustment) y, más adelante, en el paso de normalización. Modifiqué COLMAP para fijar las poses de cámara existentes en los pasos de ajuste de haces y para no normalizar la escena cuando se pasa la opción «fix_existing_images».
Escena de fondo
El siguiente problema que surgió fue que, con solo 15 cámaras, el NeRF entrenado solo representaba un volumen 3D bastante pequeño alrededor del sujeto (las personas). Al mover la cámara para mostrar otras partes de la escena aparecían muchos artefactos y objetos flotantes (floaters):
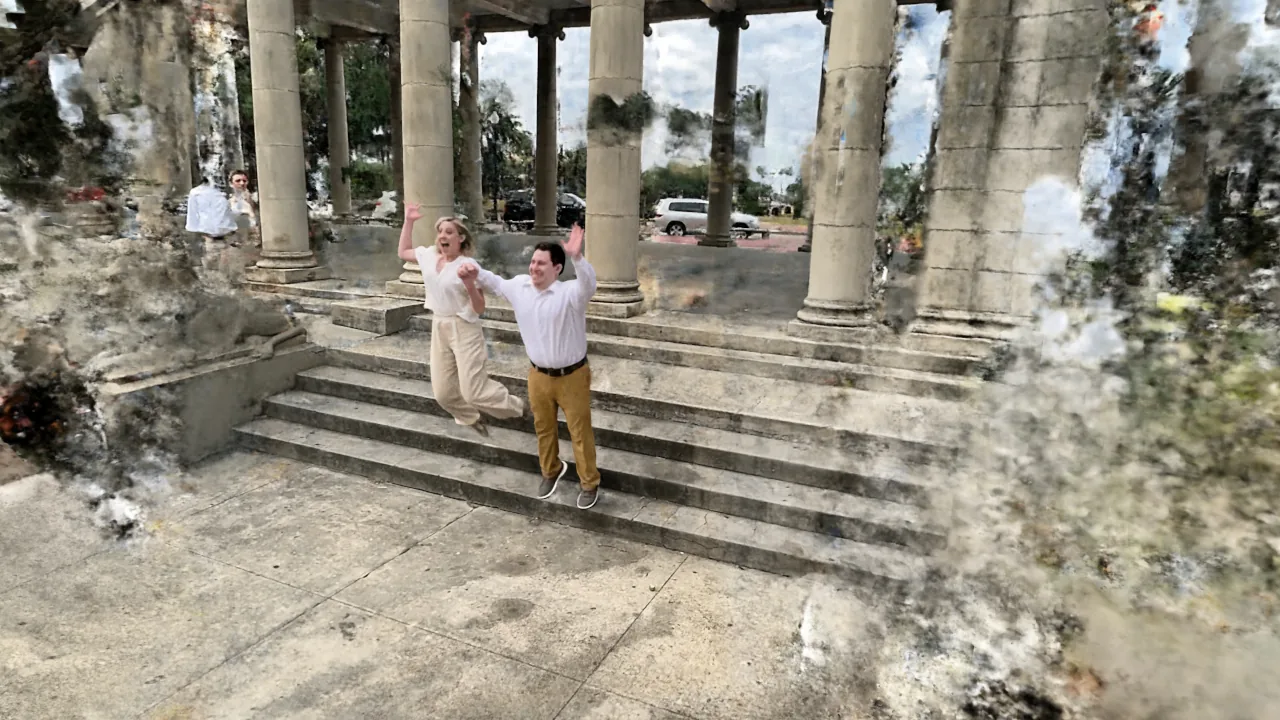
Fotograma de muestra con floaters
Así que, para renderizar las demás partes de la escena, capturé unas 200 imágenes del entorno sin ninguna persona.
Luego entrené un NeRF aparte, que se compondría con el NeRF de cada instante:
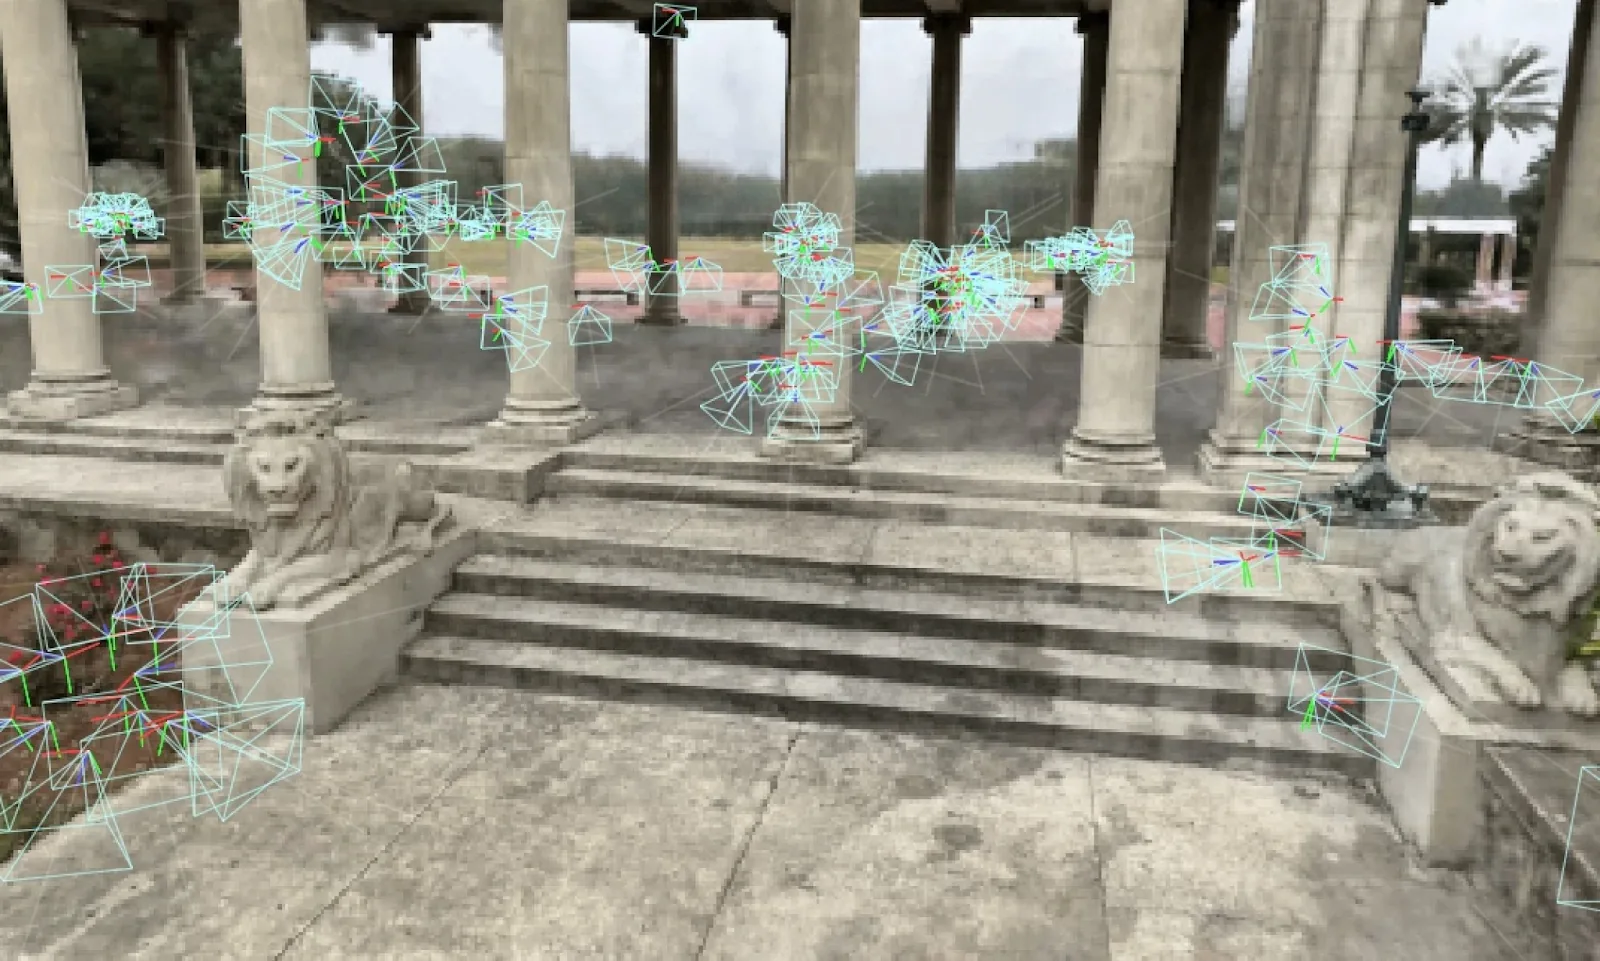
Render del NeRF de la escena de fondo
Como se ha mencionado, mi configuración personalizada de COLMAP hacía que el NeRF de fondo ya estuviera en el mismo sistema de coordenadas que cada uno de los NeRF de los instantes, por lo que los distintos renders se componen a la perfección al renderizar trayectorias de cámara:
Composición de la escena
Eso sí, tuve que renderizar los NeRF dinámicos con un volumen de recorte y transparencia para asegurarme de que solo se renderizaran las personas:
Volumen de recorte del primer plano
Notas sobre la calidad de la escena
Algunas notas sobre los problemas de calidad y de renderizado que surgieron durante el proyecto.
Parpadeo
Al principio entrené cada instante del NeRF por separado, pero al crear la animación con todos los NeRF había muchos artefactos de parpadeo:
Parpadeo temporal
Probé a reutilizar la red entrenada de un instante anterior como inicialización del instante siguiente (en concreto, guardando una instantánea tras unos 500 pasos para usarla como inicialización del siguiente instante)
Esto mejoró claramente la continuidad: la solución en la que se asentaba la red era parecida de un instante a otro. Si hubiera tenido más cámaras, no creo que esto fuera un problema tan grande, ya que hay menos margen de ambigüedad en la escena.
Floaters
Los artefactos conocidos como floaters aparecen cuando hay ambigüedad en las vistas durante el entrenamiento. Añadir más vistas de cámara lo reduce, pero en nuestro caso añadir más cámaras no es fácil en una escena dinámica.
Ajustar la «distancia cercana» del entrenamiento ayudó sin duda a reducir los floaters. Estuve a punto de implementar una distancia cercana por cámara para reducirlos aún más.
Otra idea que estaba considerando construir eran volúmenes o planos de enmascaramiento. La intuición básica es: «sé que aquí hay espacio vacío, así que no pongas ningún floater ni densidad aquí»
Un ejemplo es el suelo o plano del terreno. En escenas con un plano de suelo evidente, como esta, si pudiera configurarlo de modo que no se permitiera ninguna densidad por debajo del plano del suelo, la reconstrucción del suelo se vería más coherente en vistas nuevas.
Lo mismo ocurre con los grandes volúmenes de espacio vacío: NeRF suele aprender densidad en zonas donde sería fácil dibujar un cubo gigante para «poner a cero» cualquier gradiente en ese lugar.
También quería probar alguna supervisión con profundidad para ver si eso reducía también los floaters.
Regularización
La regularización se ha incorporado a muchos de los métodos NeRF posteriores, pero, que yo sepa, no mucho al repositorio de Instant NGP. Con más tiempo me gustaría explorar algunas técnicas para empujar el entrenamiento de la red en la dirección correcta.
- Supervisión de profundidad monocular con MiDas
- A priori de coherencia de normales para superficies suaves
Al final, usar la escena de fondo limpia, entrenada con muchas vistas, junto con las personas enmascaradas, hizo que los floaters no fueran un problema grave.
Si dispone de pocos ángulos de cámara, estas ideas podrían merecer la pena.
Ajuste de color
Algunos fotogramas capturados por distintos teléfonos tienen tonos de color ligeramente diferentes:
Diferencia de tono de color
Incluir un marcador de calibración en las imágenes podría facilitar un poco resolver esto de forma automática. Probablemente hay muchas maneras de resolver o mejorar este problema. Quizá, en el lado de la captura, podríamos sincronizar el balance de blancos y la exposición en todos los teléfonos. No exploré otras técnicas para resolver este problema.
Una idea era seleccionar los mismos puntos en distintas imágenes y luego resolver una operación de transformación de color que reduzca las diferencias de color entre imágenes.
Un problema podría ser no acertar exactamente con el mismo píxel en las distintas imágenes.
Usar las características SIFT de COLMAP podría ayudar, pero como las características SIFT suelen estar en bordes o zonas de alto contraste, podríamos acabar seleccionando colores distintos para el «mismo» punto 3D proyectado en imágenes diferentes.
Transporte óptimo
Lo primero y lo único que probé para resolver este problema fue el transporte óptimo de histogramas de color.
Encontré unos buenos ejemplos de código en la web, de la biblioteca Python Optimal Transport / POT, aquí:
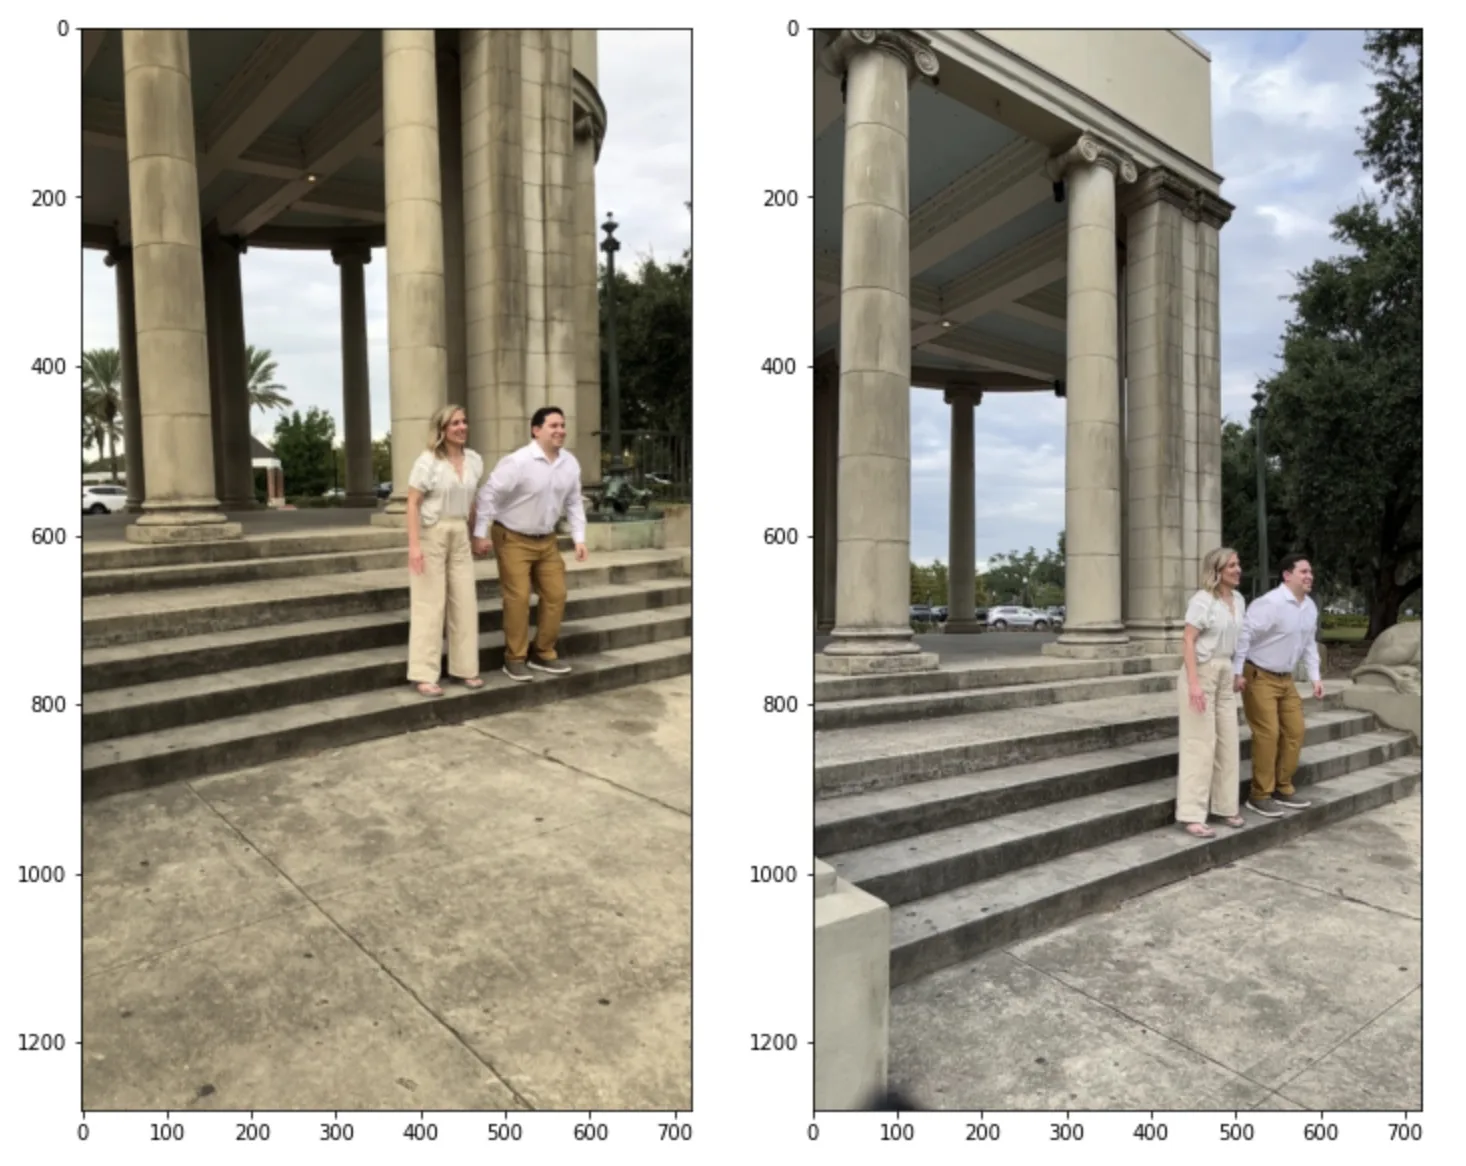
Mi única modificación algo ingeniosa fue muestrear más intensamente sobre las personas de la imagen, ya que es lo que más me importa, pero además las personas aparecen en todas las tomas.
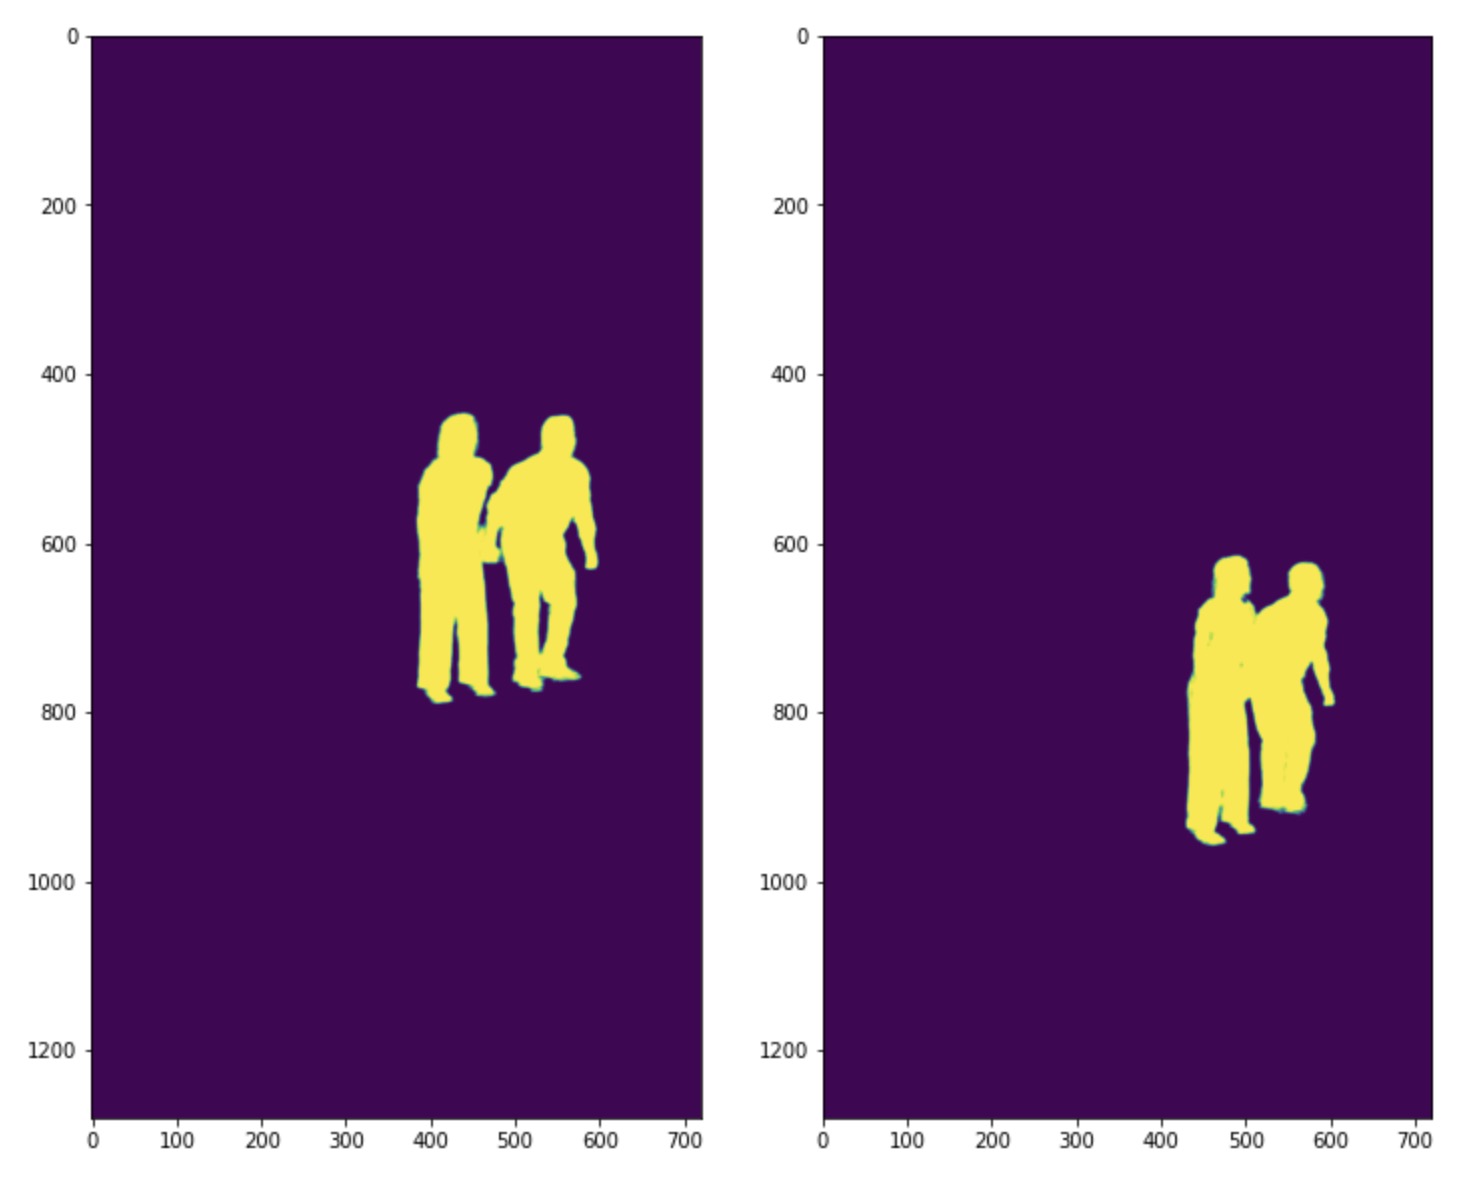
Máscaras de segmentación de personas
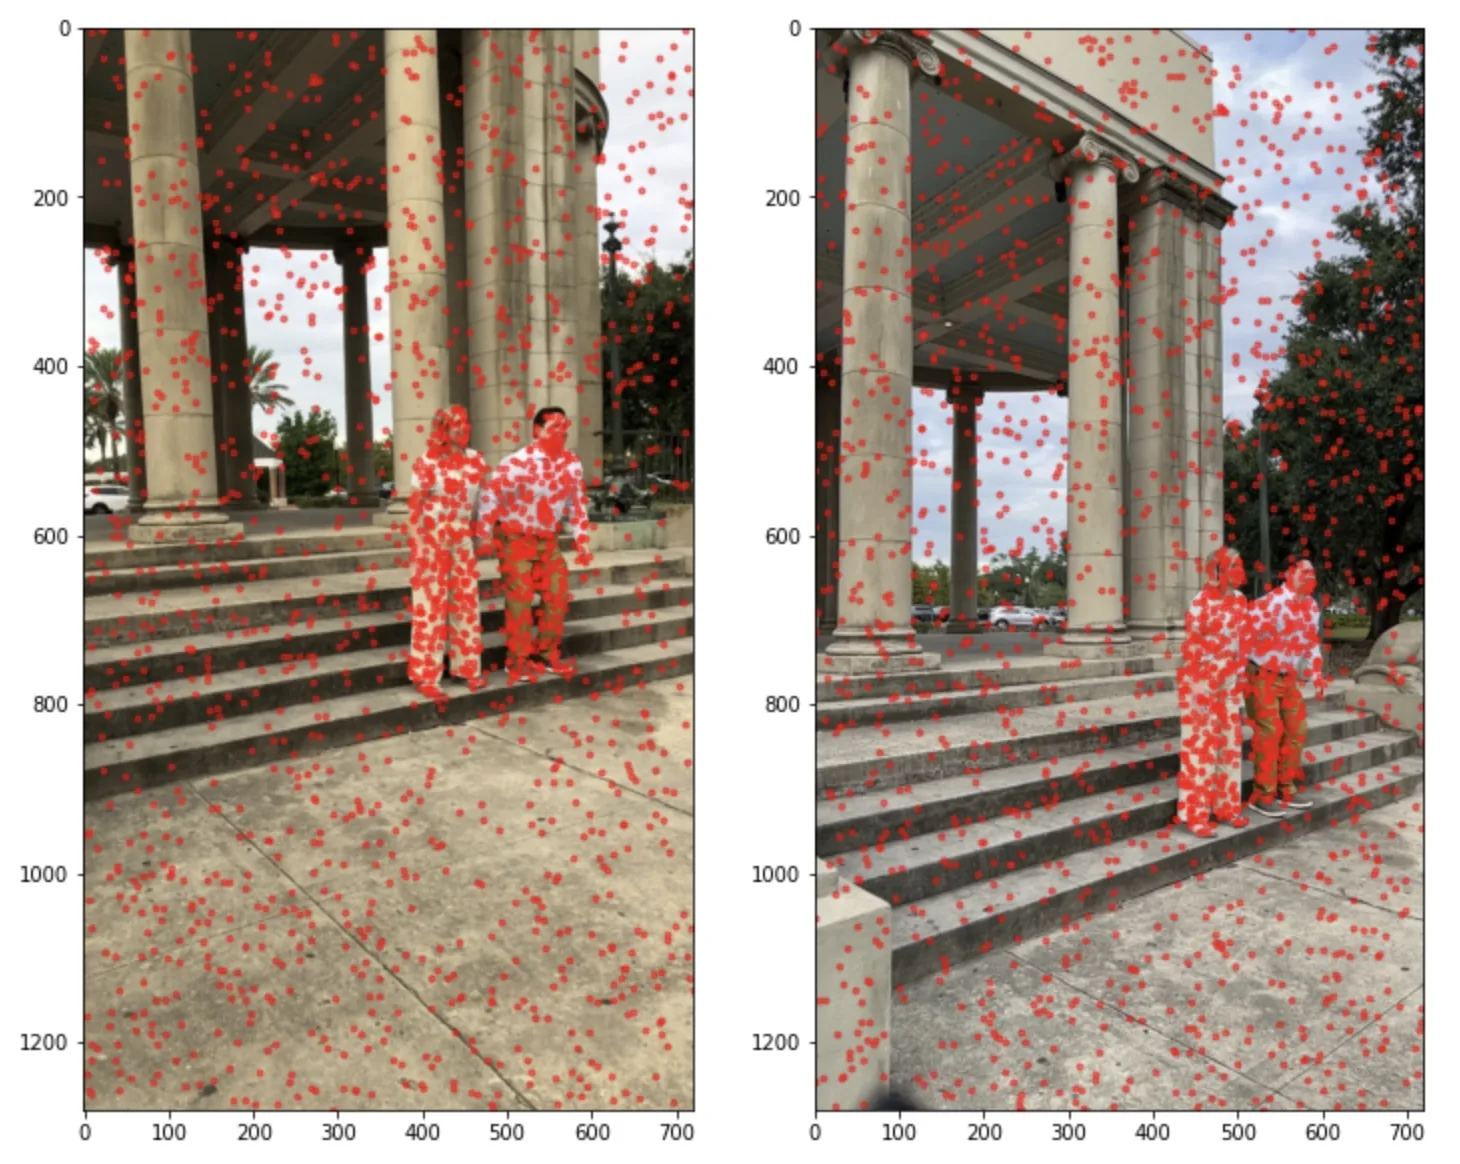
Muestreo de la segmentación de personas
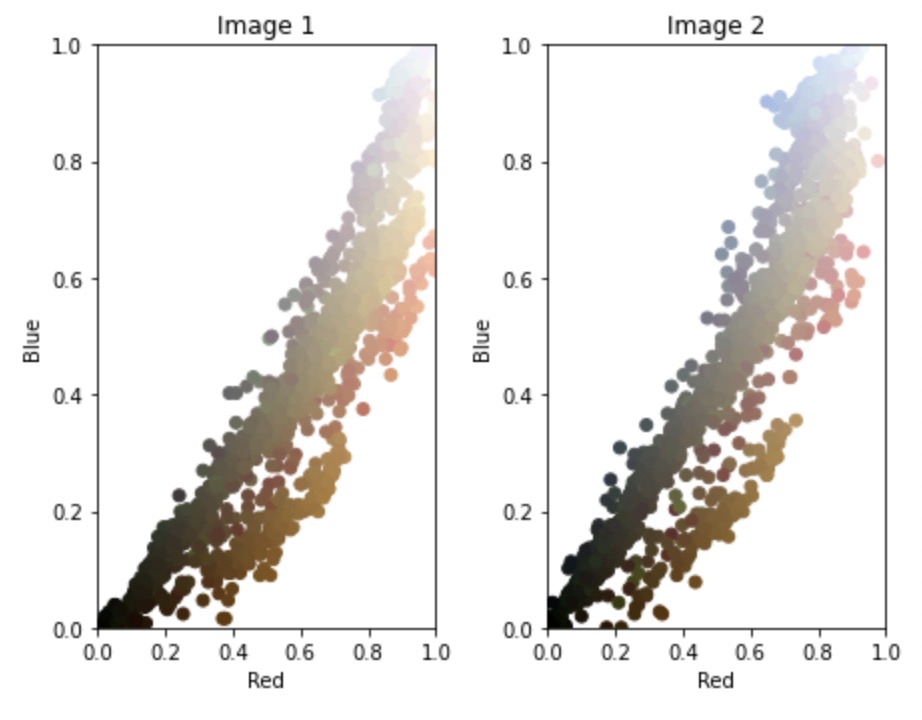
Gráficas de color
Es un cambio sutil, pero creo que marca una diferencia en la reconstrucción del NeRF:
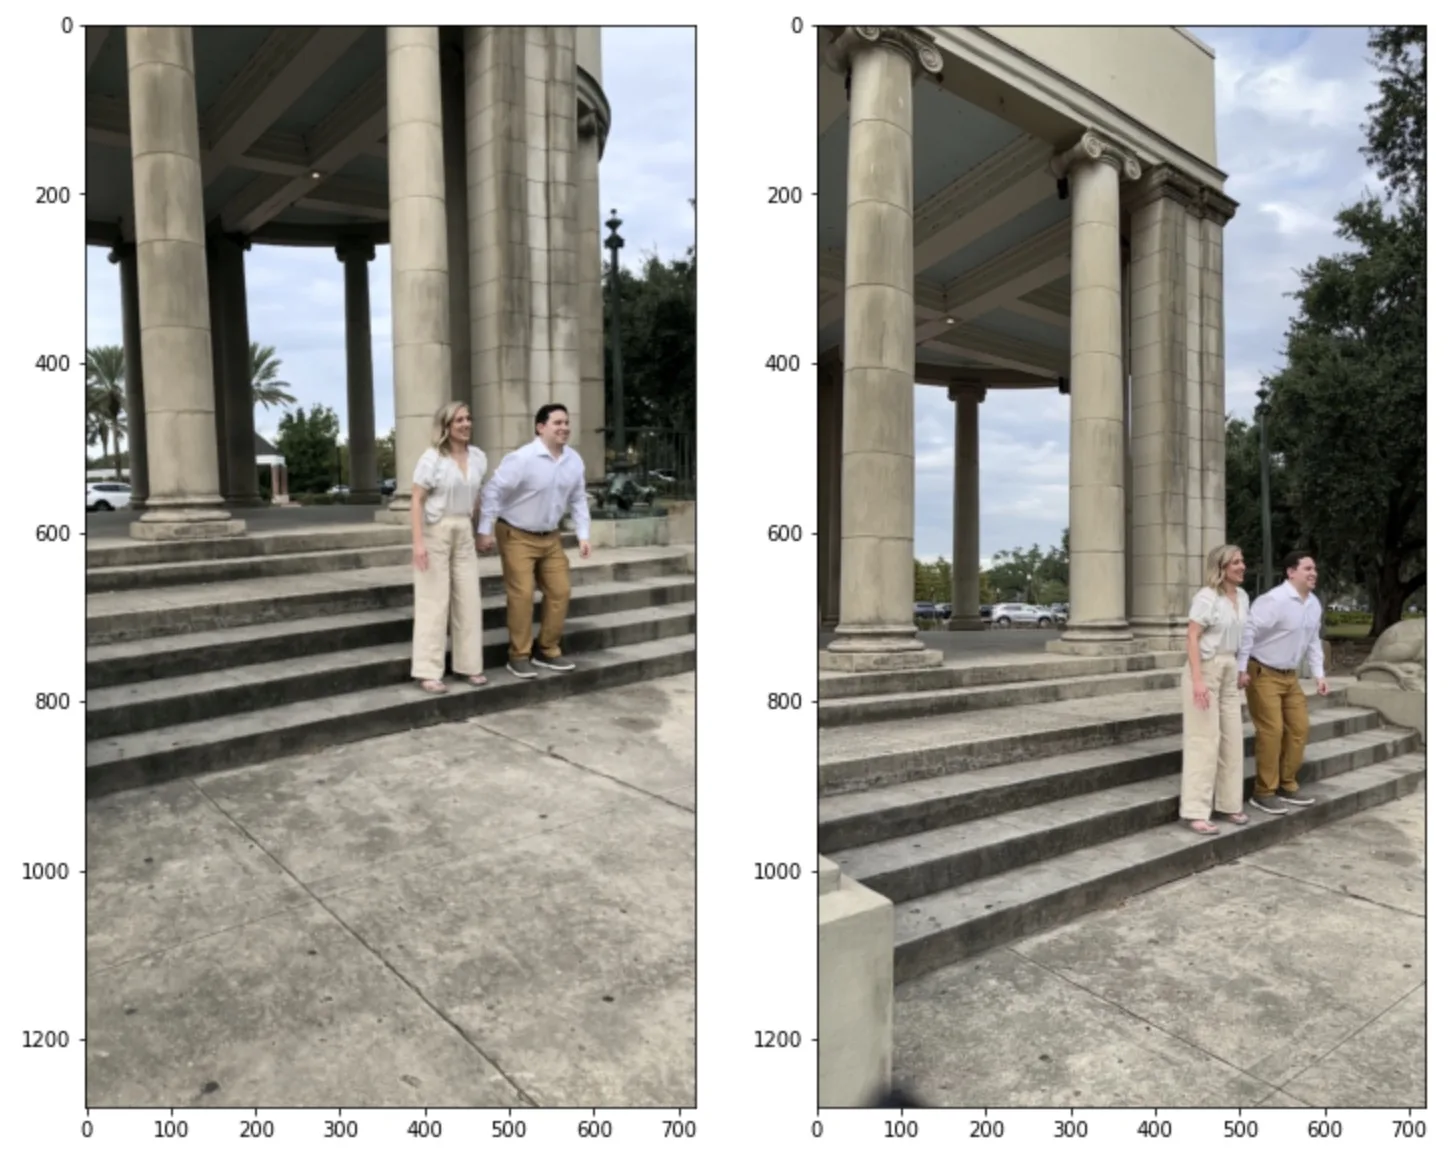
Imágenes ajustadas
Animación de las imágenes ajustadas
Código
Si le interesa construir sobre esto, escríbanos por correo electrónico
Trabaje con nosotros
Si necesita ayuda para usar NeRF en un proyecto, envíenos un correo electrónico.
Trabaje con Laan Labs
Gaussian Splatting y campos de radiancia
Captura 3D fotorrealista a partir de fotos y vídeo, desde el protocolo de captura hasta el entrenamiento y la entrega en un navegador o en un dispositivo.
Descargar este artículo
Obtenga el código fuente en Markdown para leerlo sin conexión