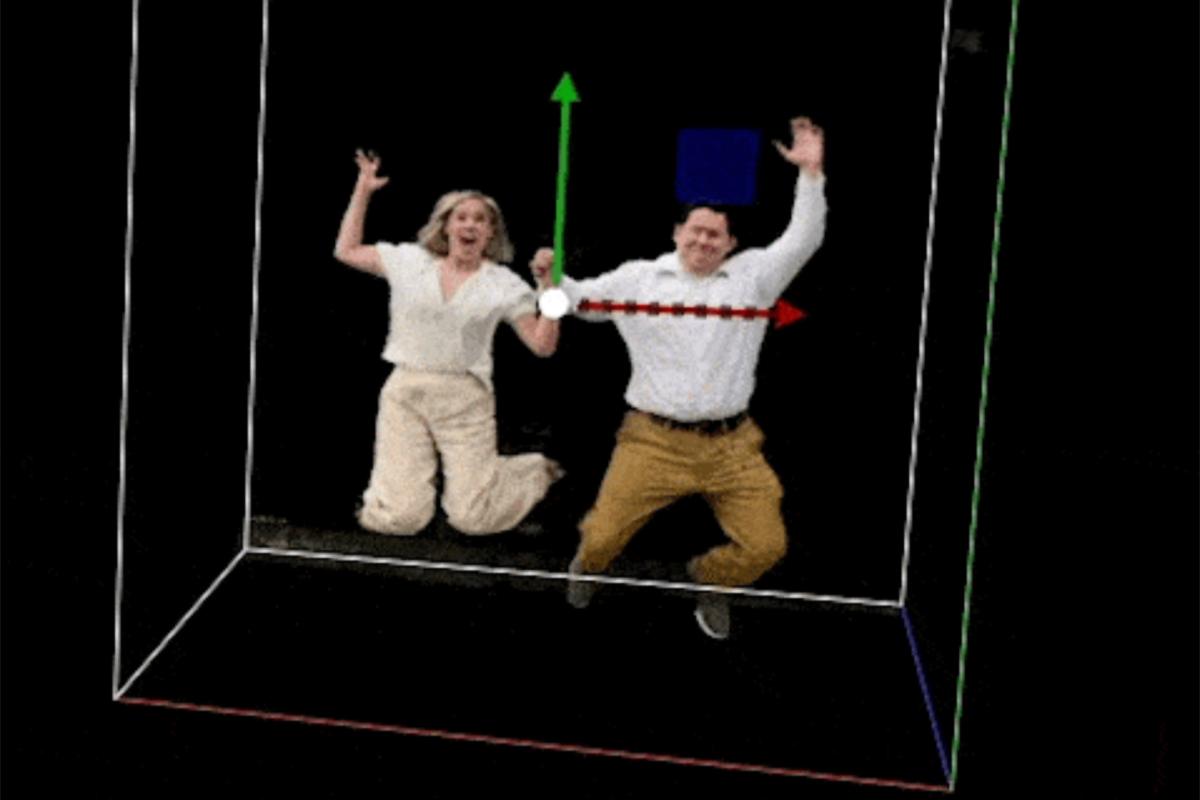
NeRFで作るスローモーションの「バレットタイム」

TLDR
NeRFと15台のiPhoneを使って、ボリュメトリックな3D「バレットタイム」ビデオを記録しました。
NeRFによるバレットタイム
フルビデオ
概要
先月、いとこが結婚することになり、その記念に家族写真の撮影をしていました。この機会に、以前からあれこれ試していたアイデアをもう一度やってみることにしました。基本的な発想は、友人たちを集めて、スマートフォンで1つのシーンをさまざまな角度からキャプチャするというものです。最終的には、マトリックスで見られたようなフリーズフレーム、つまりバレットタイムの映像ができあがります。
何年も前にこのアイデアを最初に試したときは、NeRFがまだ存在しなかったため、高品質な「ビュー合成」を行うよい方法がありませんでした。ここでいう「ビュー合成」とは、シーンを最初にキャプチャした視点とは異なる視点から、そのシーンの画像をレンダリングすることを指します。
NeRFとは
NeRF(Neural Radiance Fields)は、ビュー合成と3D再構築の驚くべき新手法として、急速に注目を集めるようになりました。
Neural Radiance Fieldsは、ディープラーニングを使って3Dシーンを表現し、レンダリングする手法です。NeRFの基本的な考え方は、ニューラルネットワークを使って、3D空間の各点におけるシーンの放射輝度を予測することです。シーンの入力画像の集合が与えられると、ニューラルネットワークは、シーンの3D構造と、各点での表面反射と照明を予測できるようになります。得られる表現は、3D空間の任意の点で評価できる連続関数で、どの視点からでもシーンを非常に写実的にレンダリングできます。NeRFは、複雑な3Dシーンの高品質でフォトリアルなレンダリングを生成でき、コンピュータグラフィックスの分野に革命を起こす可能性を秘めています。
この分野の動きは非常に速く、新しいアプローチや改良がほぼ毎日のように登場しています。
NeRFについてはこちらで詳しく読めます。元の論文はこちらです。また、YouTubeではNeRFのクールなレンダリングを見ることもできます。
2021年に、NVIDIAは画像やビデオからNeRFを素早く作成するためのオープンソースのツールキット、Instant NGPを公開しました。Instant NGPによって、NeRFの学習時間は数日から数分に短縮されました。
NeRFによるバレットタイムは以前にも行われており、新しいNeRFの拡張手法では、既存のNeRFモデルに時間の要素を加えることで、動的なシーンを表現できます(「Dynamic NeRF」として知られるDNerfなどを参照)。
これは楽しい短期の副次プロジェクトだったため、新しいアプローチを試すことはできず、Instant NGPが備える使いやすさと高速な学習時間を選びました。
Nerfstudioも、チェックする価値のあるNeRF学習ツールキットです。動的シーン向けの「DNerf」にも対応していますが、まだ試す機会がありません。
NeRFをめぐる研究は非常に速く進んでいるため、数か月後には、こうしたものを作るためのより優れた、より高速な手法が登場している可能性が高いでしょう。
ビデオのキャプチャ
このプロジェクトの最初の要件は、シーンをさまざまな角度から撮影したスローモーションビデオをキャプチャすることです。新しめのiPhoneは、1920x1080の解像度で240フレーム/秒のビデオを撮影でき、NeRFの学習に使うには十分です。
手持ちのテスト用デバイスをすべて集め、家族にも頼んだ結果、15台のiPhoneが集まりました。(通常、NeRFのシーンには40〜100枚ほどの画像を使います。)
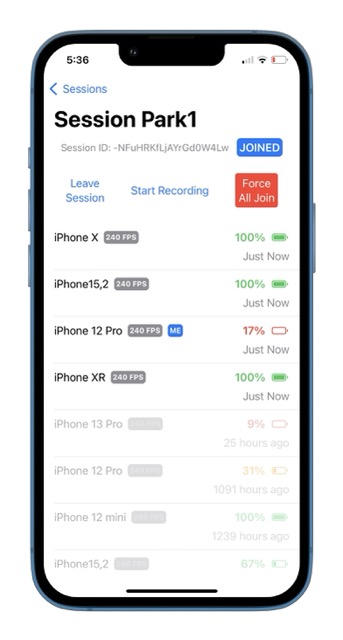
次に、すべてのスマートフォンで同時に録画を開始できる、シンプルなFirebase Realtime Databaseアプリを作成しました。ビデオがキャプチャされると、自動的にGoogle Cloud Storageにアップロードされます。
1台のスマートフォンで録画ボタンを押すと、接続されているすべてのデバイスで録画が始まります。
複数のスマートフォンで同期した録画
このアプリは、各デバイスのバッテリー残量とビデオのアップロード状況も表示します。
iPhone用の三脚
安価な木材で簡単な三脚を作り、残りのスマートフォンは数人の家族に持ってもらいました。
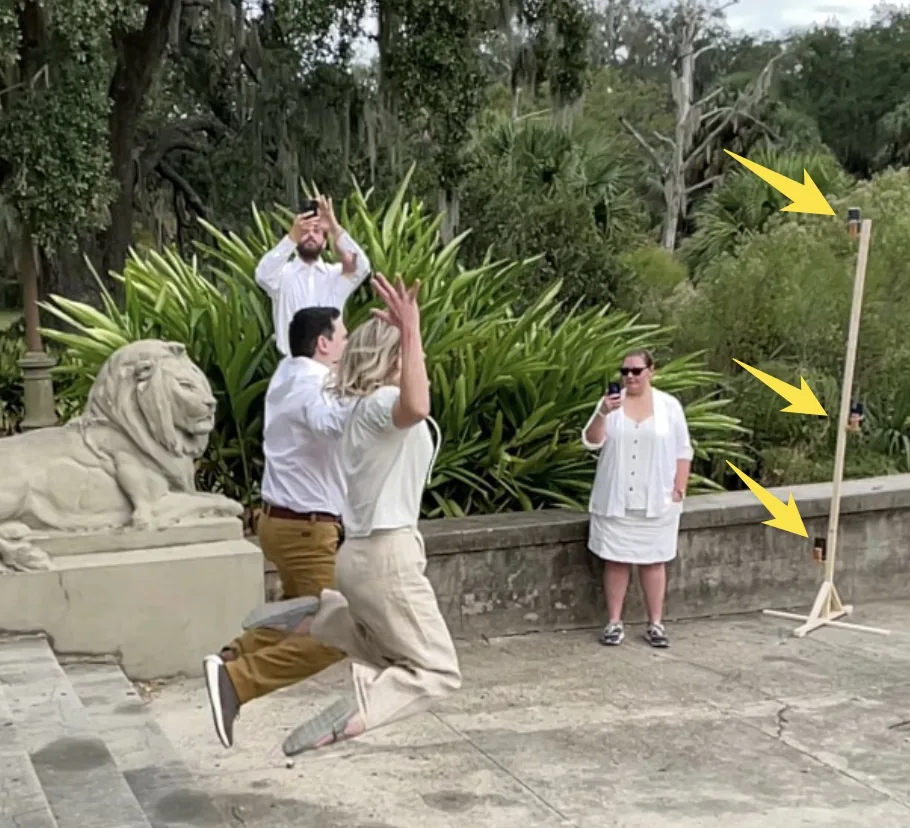
三脚を使ったキャプチャの様子
異なるスマートフォンで撮影された画像の一部を紹介します。
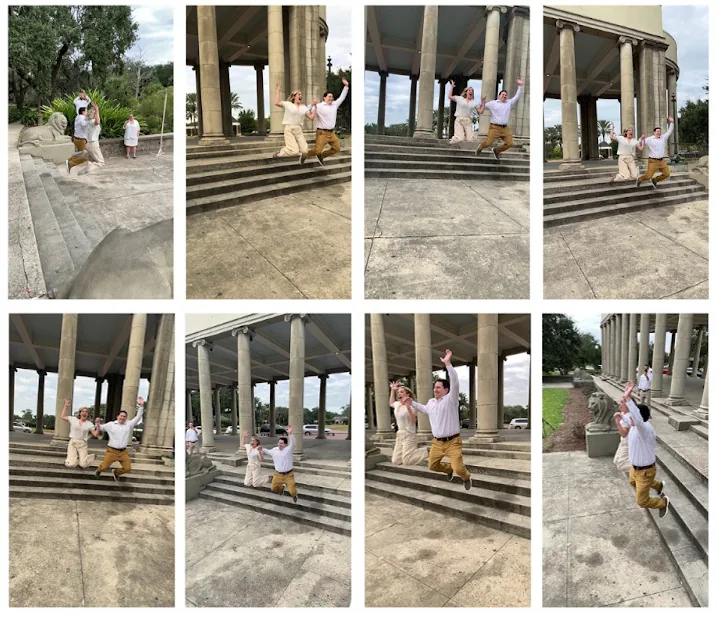
サンプル画像
アプリは録画時にフォーカスと露出をロックしましたが、その値はスマートフォン間で同期されなかったため、画像に色の違いが見られます。これについては、後ほど詳しく説明します。
セットアップとシーンのキャプチャに使えた時間は、せいぜい10分ほどと、かなり短いものでした。時間があれば、どれが最適かを確かめるために、いろいろなカメラ配置を試したかったところです。
ビデオの時間同期
すべてのビデオをキャプチャしたら、時間を同期させる必要があります。
一度きりの作業なら手動で同期するほうが速いのですが、開発者としては、このプロセスを自動化したいと考えました。
最終的に、2つのビデオ間で最適な時間オフセットを見つけるために、音声ストリームの相互相関を計算する小さなPythonスクリプトを書きました。
これをより確実にするため、録画の開始時に打ち合わせる金属の棒を2本持っていきました。
同期していない2つのビデオの音声波形:
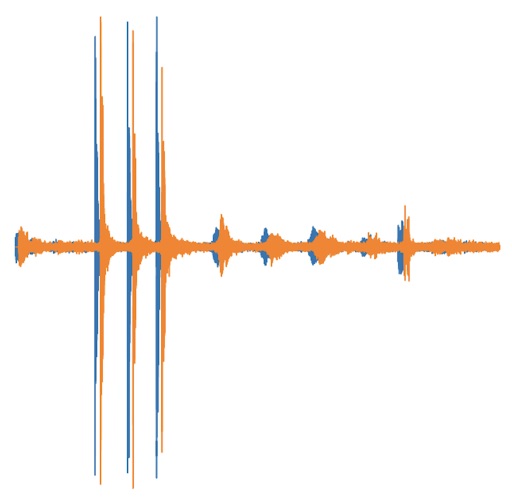
音声の位置合わせ
相互相関では、2つの信号の位置が最もよく合う場所に明確なピークが現れます。
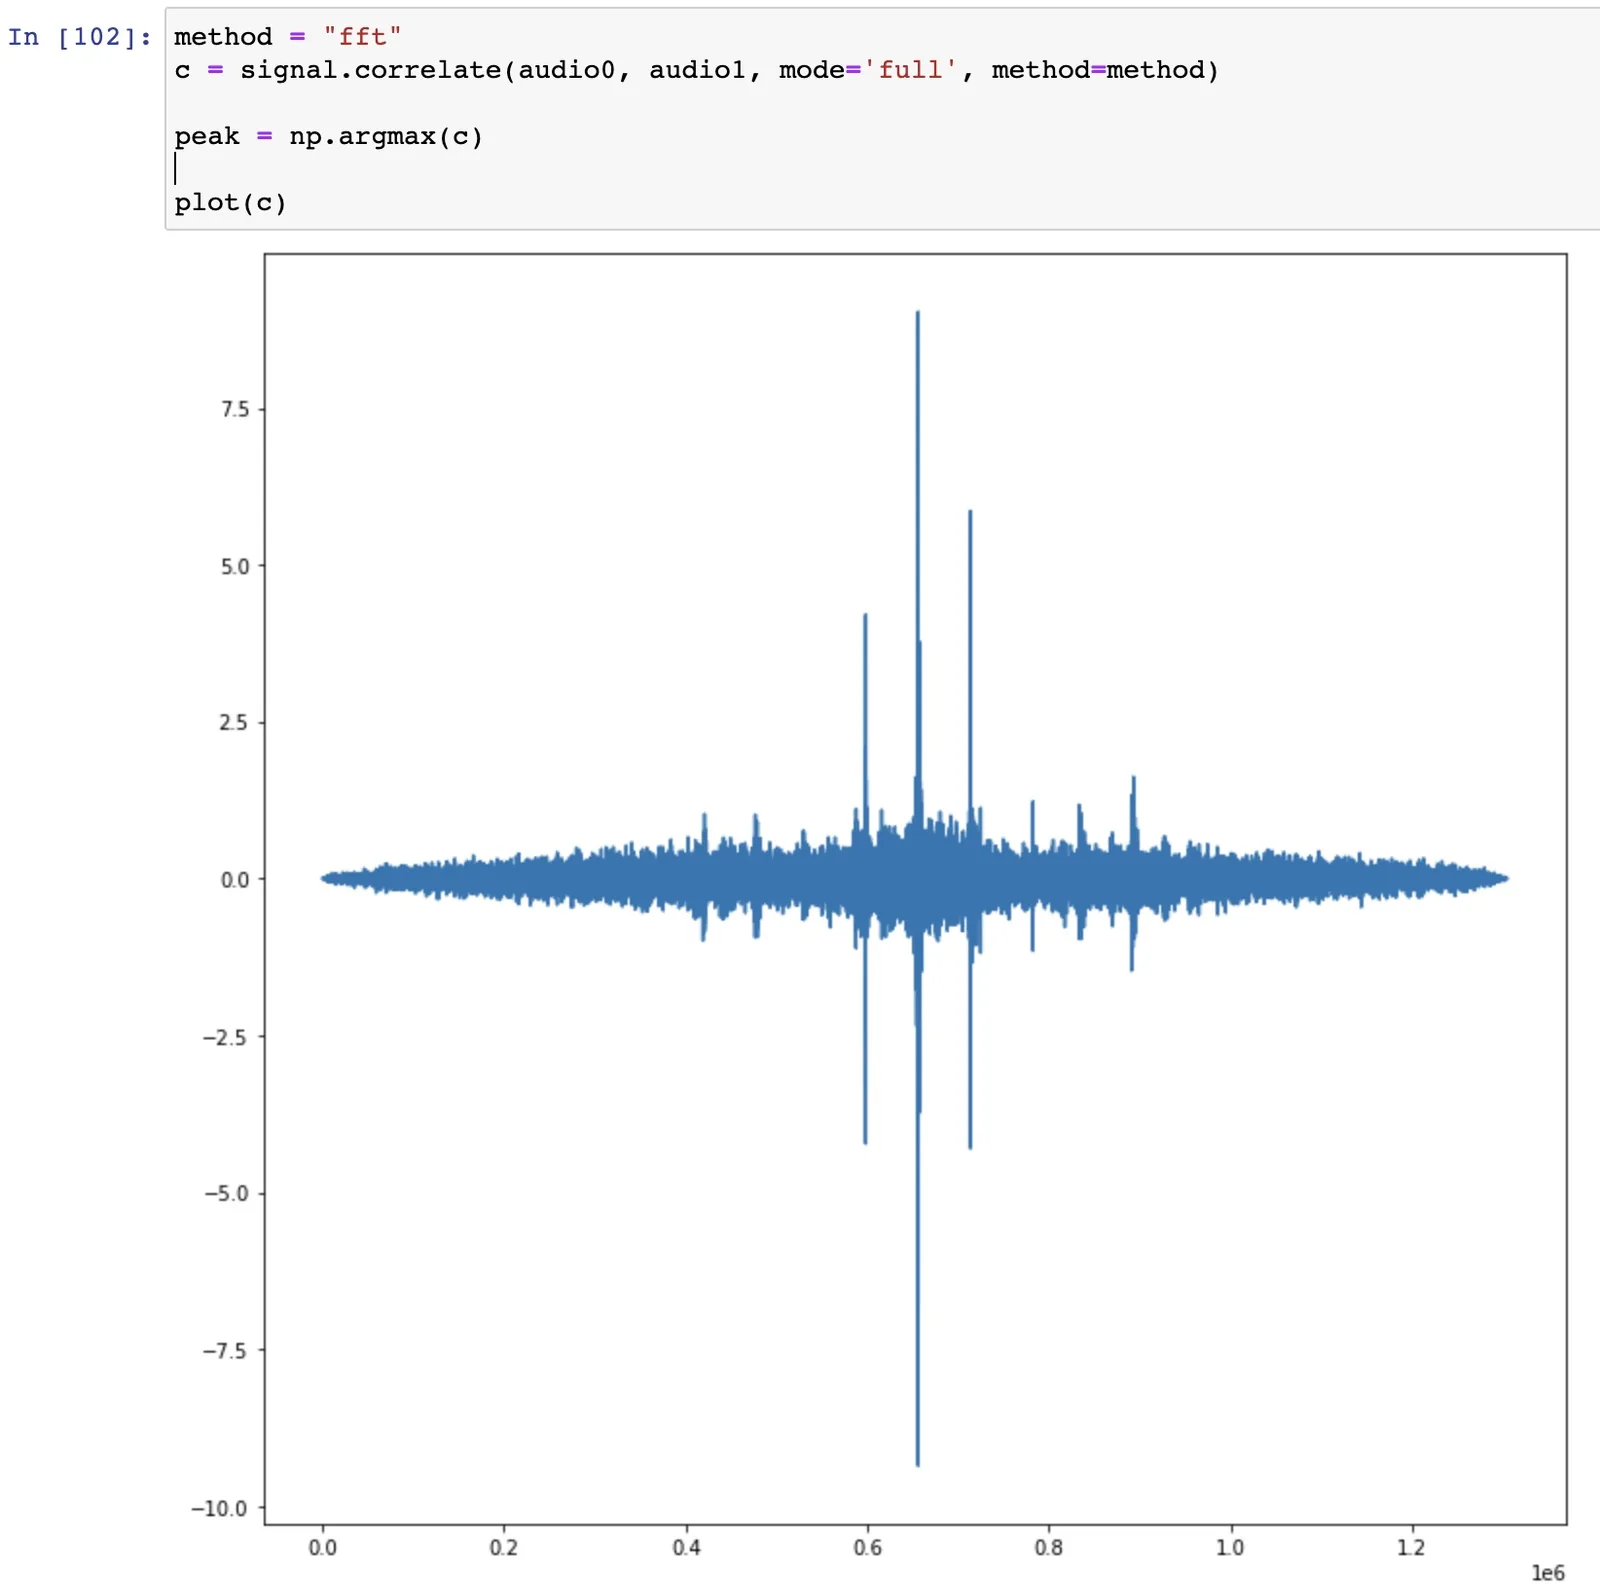
相互相関
すべてのビデオを同じグローバルな時間軸に揃えたあと、15台すべてのスマートフォンから、同期した約200フレームを書き出しました。合計で約3000枚の画像になります。
NeRFの学習
次のステップは、すべてのデータでNeRFを学習させることです。ここでは、触れておく価値のある問題がいくつか出てきました。
タイムステップの統合
まず、NeRFの学習プロセスの背景を説明します。
NeRFの最初のステップは、シーン内のすべての画像についてカメラポーズを計算することです。これにはCOLMAPを使います。
バレットタイムの場合、書き出したビデオのタイムステップの数(つまり200タイムステップ)だけ「シーン」があることになります。
そのため、カメラポーズが、ビデオ全体を通じて変化しないグローバルな座標系に揃っていることを保証する方法が必要です。
シーンの撮影中にすべてのカメラが動かないのであれば、これは非常に簡単です。最初のフレームでポーズを計算し、それ以降のすべてのフレームで再利用するだけです。今回のケースでは、何台かのスマートフォンを人が手で持っていたため、撮影中にそれらがわずかに動きました。
カメラは全部で15台しかないため、わずかに動いたスマートフォンの重要なカメラアングルを失いたくありませんでした。そのためには、動いているカメラについて、200のタイムステップごとにカメラポーズを計算する必要がありました。
選べるなら、次回はポーズの復元プロセスが大幅に簡単になるため、すべてのカメラを三脚に固定します。
これにはいくつかの異なるアプローチを試しましたが、最終的に、COLMAPを少しカスタマイズして、シーンの増分再構築ができるようにしました。
私が採用したアプローチは、カメラポーズを一度だけ計算し、新しい画像が追加されても固定されたままにする「背景」シーンから始めます。背景のシーンは人がいない状態でキャプチャしたため、1台のスマートフォンを持って自由に歩き回り、たくさんの画像を撮影できました。
ビデオの各「タイムステップ」には、録画しているすべてのカメラからの15枚の画像があります。そこで、タイムステップごとに背景シーンから始め、背景シーンのカメラポーズを固定したまま、新しい画像をそこに追加していきます。COLMAPには、「--Mapper.fix_existing_images」オプションで、既存の静的なシーンに新しい画像を追加する機能がありますが、残念ながら、バンドル調整のステップと、その後の正規化のステップで、ベースとなるカメラポーズが変更されてしまいます。そこで、COLMAPを改造し、バンドル調整のステップで既存のカメラポーズを固定し、「fix_existing_images」オプションが渡されたときはシーンを正規化しないようにしました。
背景シーン
次に起きた問題は、カメラが15台しかないため、学習したNeRFが表現できるのは、被写体(人々)の周囲のごく小さな3Dボリュームだけだったことです。カメラを動かしてシーンの別の部分を映すと、アーティファクトや浮遊物が大量に発生しました。
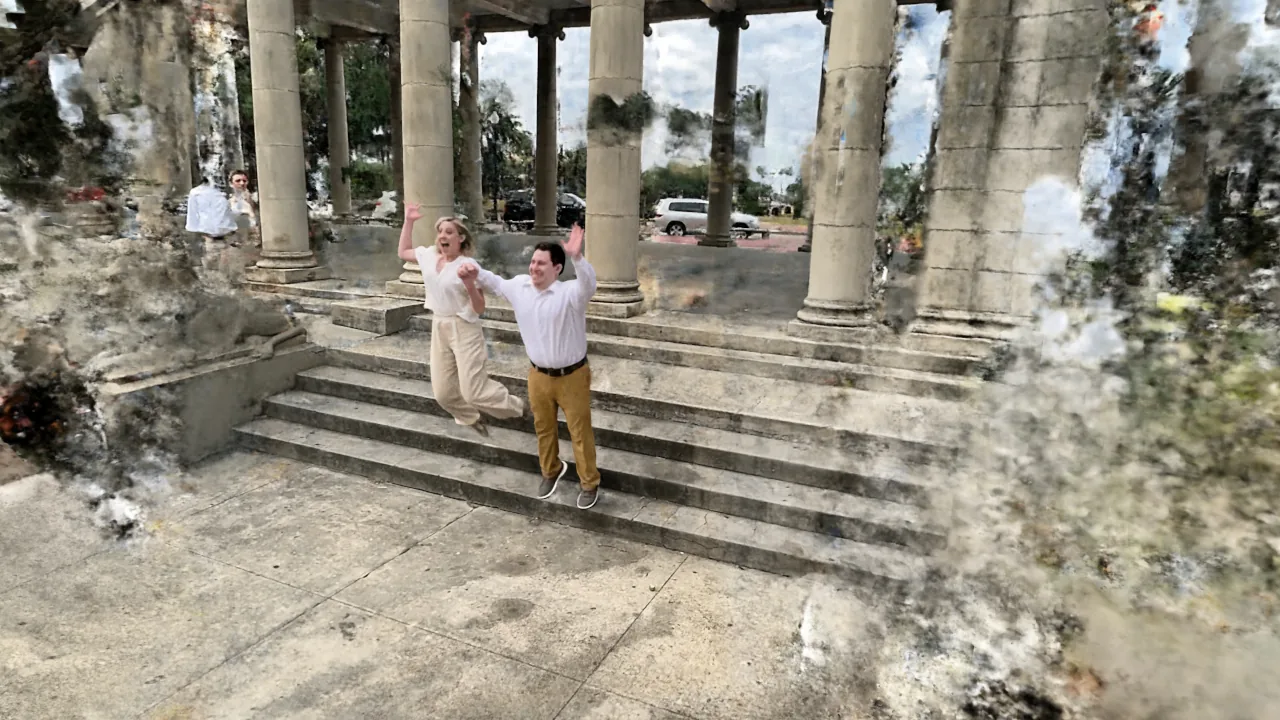
浮遊物のあるサンプルフレーム
そこで、シーンの他の部分をレンダリングするために、人のいない状態で周囲の約200枚の画像をキャプチャしました。
次に、各タイムステップのNeRFと合成するための、別のNeRFを学習させました。
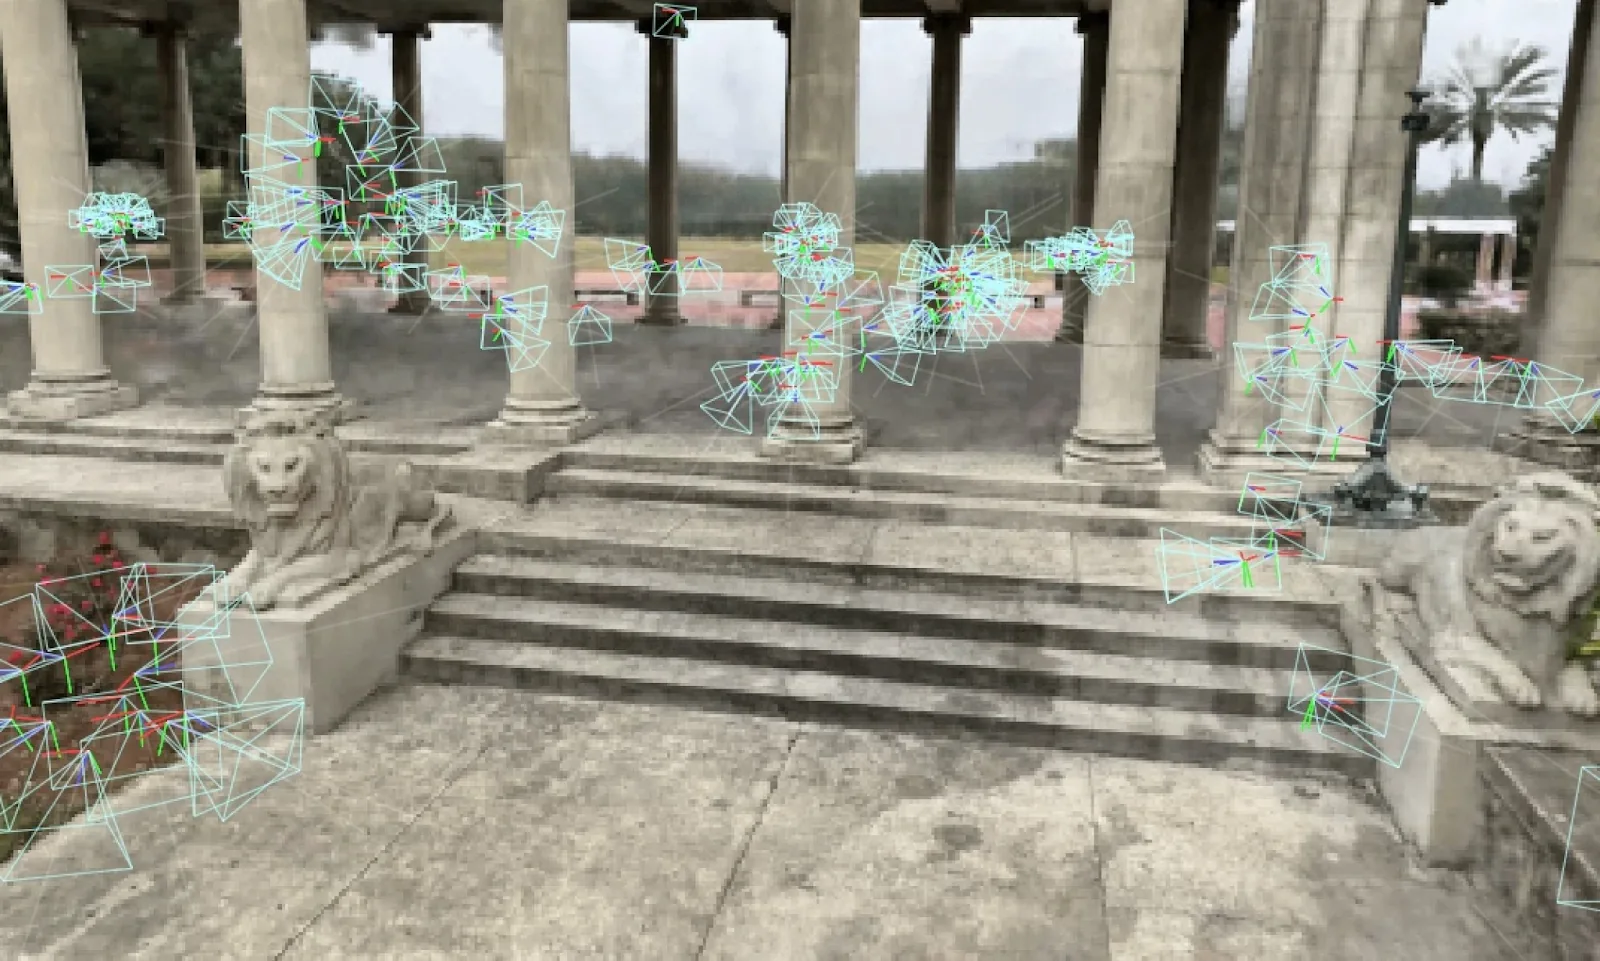
背景シーンのNeRFによるレンダリング
前述のとおり、カスタマイズしたCOLMAPのセットアップによって、背景のNeRFは各タイムステップのNeRFとすでに同じ座標系にあったため、カメラパスをレンダリングするときには、異なるレンダリング結果がぴったりと合成されます。
シーンの合成
ただし、人だけがレンダリングされるように、動的なNeRFはクロップボリュームと透過を使ってレンダリングする必要がありました。
前景のクロップボリューム
シーン品質に関するメモ
プロジェクト中に生じた、品質やレンダリングに関する問題についてのメモです。
フリッカー
当初は各NeRFのタイムステップを個別に学習させていましたが、すべてのNeRFからアニメーションを作ると、大量のフリッカー(ちらつき)のアーティファクトが発生しました。
時間方向のフリッカー
そこで、前のタイムステップで学習したネットワークを、次のタイムステップの初期値として再利用する方法を試しました(具体的には、約500ステップ後にスナップショットを保存し、次のタイムステップの初期化に使います)。
これによって、ネットワークが収束する解が、タイムステップ間で似たものになり、連続性が確実に改善されました。カメラがもっと多ければ、シーンの曖昧さが小さくなるため、これはそれほど大きな問題にはならないと思います。
浮遊物
浮遊物と呼ばれるアーティファクトは、学習中にビューに曖昧さがあると発生します。カメラビューを増やせば減りますが、今回のような動的なシーンでは、カメラを増やすのは簡単ではありません。
学習時の「ニアディスタンス」を調整すると、浮遊物は確実に減りました。浮遊物をさらに減らすために、カメラごとのニアディスタンスを実装する寸前まで行きました。
もう1つ、構築を検討していたアイデアは、マスキング用のボリュームや平面でした。基本的な発想は、「ここが空の空間であることはわかっているので、ここに浮遊物や密度を置くな」というものです。
その一例が、床/地面の平面です。今回のように、床の平面がはっきりしているシーンでは、床面より下には密度を許さないように設定できれば、新しい視点でも地面の再構築がより一貫して見えるはずです。
広い空の空間についても同じことが言えます。NeRFは、巨大な立方体のボリュームを描いて勾配を「ゼロにする」ことが容易な領域にも、密度を学習してしまうことがよくあります。
また、深度による教師あり学習を試して、それでも浮遊物を減らせるかどうか確かめたいとも思っていました。
正則化
正則化は、NeRFのその後の多くの手法に取り入れられていますが、私の知る限り、Instant NGPのリポジトリにはあまり組み込まれていません。時間があれば、ネットワークの学習を正しい方向へ導く手法をいくつか探ってみたいと思っています。
- MiDasによる単眼深度の教師あり学習
- 滑らかな表面のための法線一貫性の事前分布
結局、多数のビューで学習させたクリーンな背景シーンと、マスクした人物を組み合わせたことで、浮遊物は大きな問題になりませんでした。
カメラアングルが限られている場合は、こうしたアイデアを探る価値が出てくるかもしれません。
色合わせ
異なるスマートフォンで撮影されたフレームの一部は、色調がわずかに異なります。
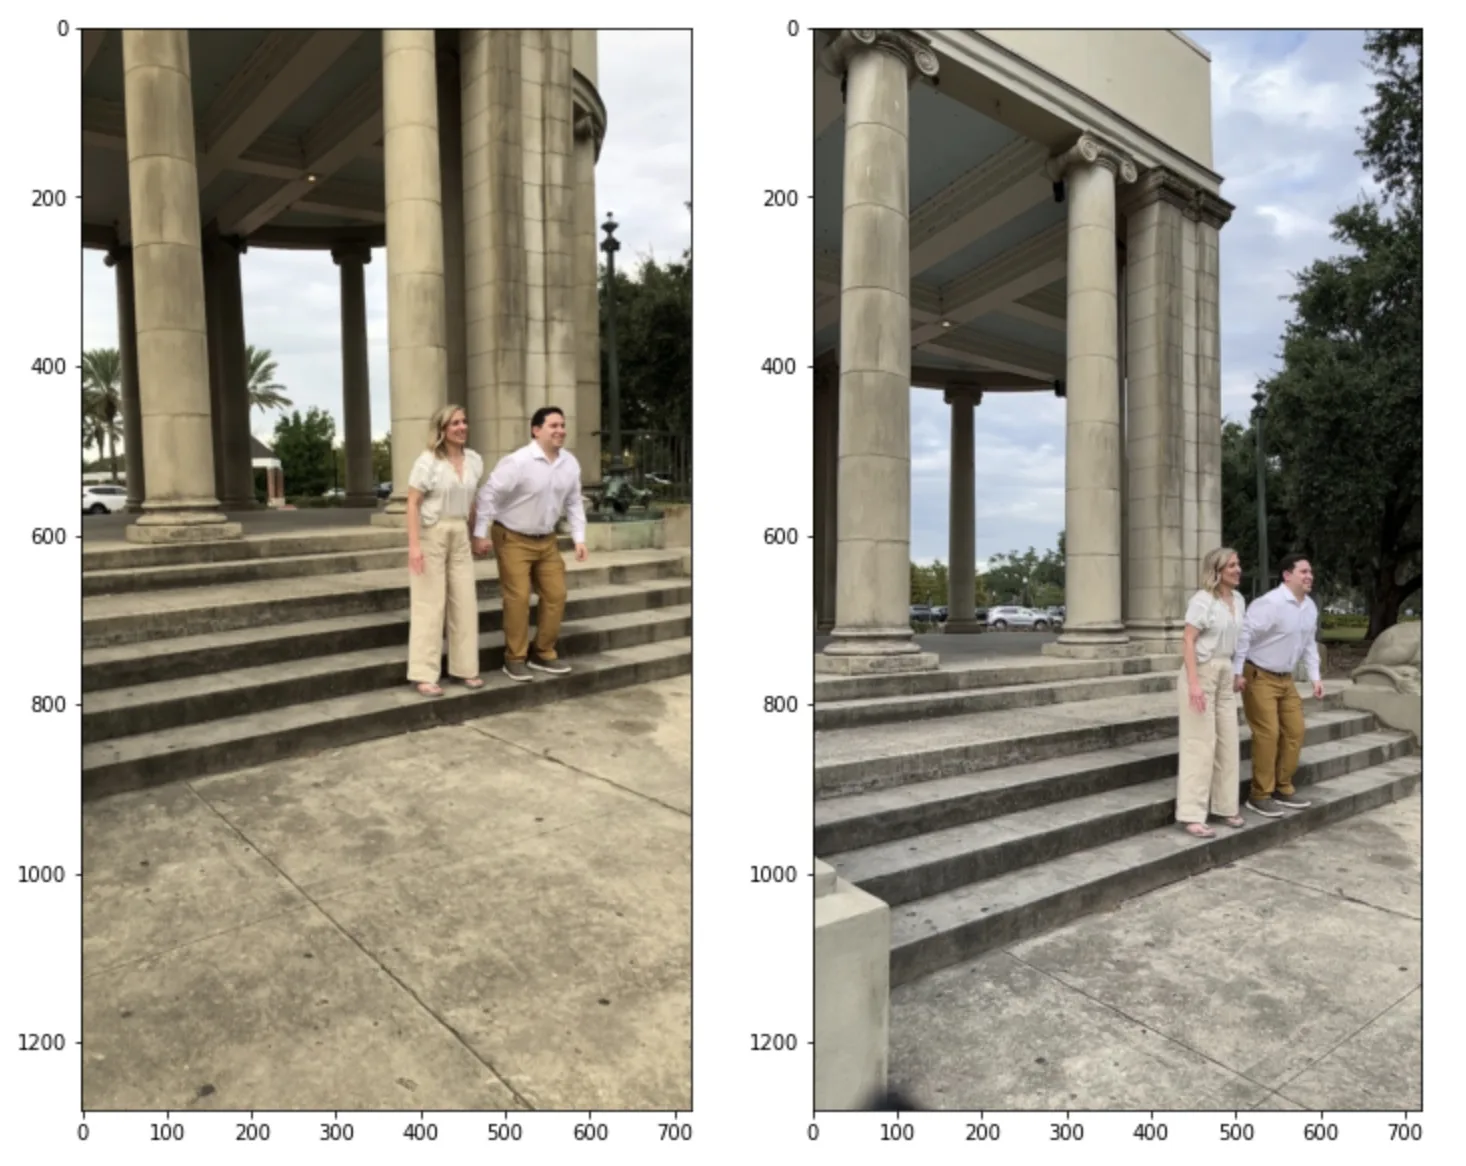
色調のずれ
画像にキャリブレーション用のマーカーを入れておけば、これを自動的に解決するのが少し楽になるかもしれません。この問題を解決したり改善したりする方法は、おそらくたくさんあります。キャプチャ側で、すべてのスマートフォンのホワイトバランスと露出を同期できるかもしれません。他の手法は試していません。
1つのアイデアは、画像間で同じ点を選び、画像間の色の違いを小さくする色変換の演算を解くというものでした。
問題になりうるのは、複数の画像で、まったく同じピクセルを選べないことです。
COLMAPのSIFT特徴量を使えば役立つかもしれませんが、SIFT特徴量はエッジやコントラストの高い場所にあることが多いため、異なる画像に投影された「同じ」3D点で、異なる色を選んでしまう可能性があります。
最適輸送
この問題を解決するために私が最初に、そして唯一試したのは、色ヒストグラムの最適輸送でした。
Python Optimal Transport / POTライブラリに、Web上で見つけた優れたコード例がありました。
私が加えた、ほんの少しだけ工夫した変更は、画像内の人物を重点的にサンプリングすることです。私が最も重視しているのが人物で、しかも人物はどのショットにも写っているためです。
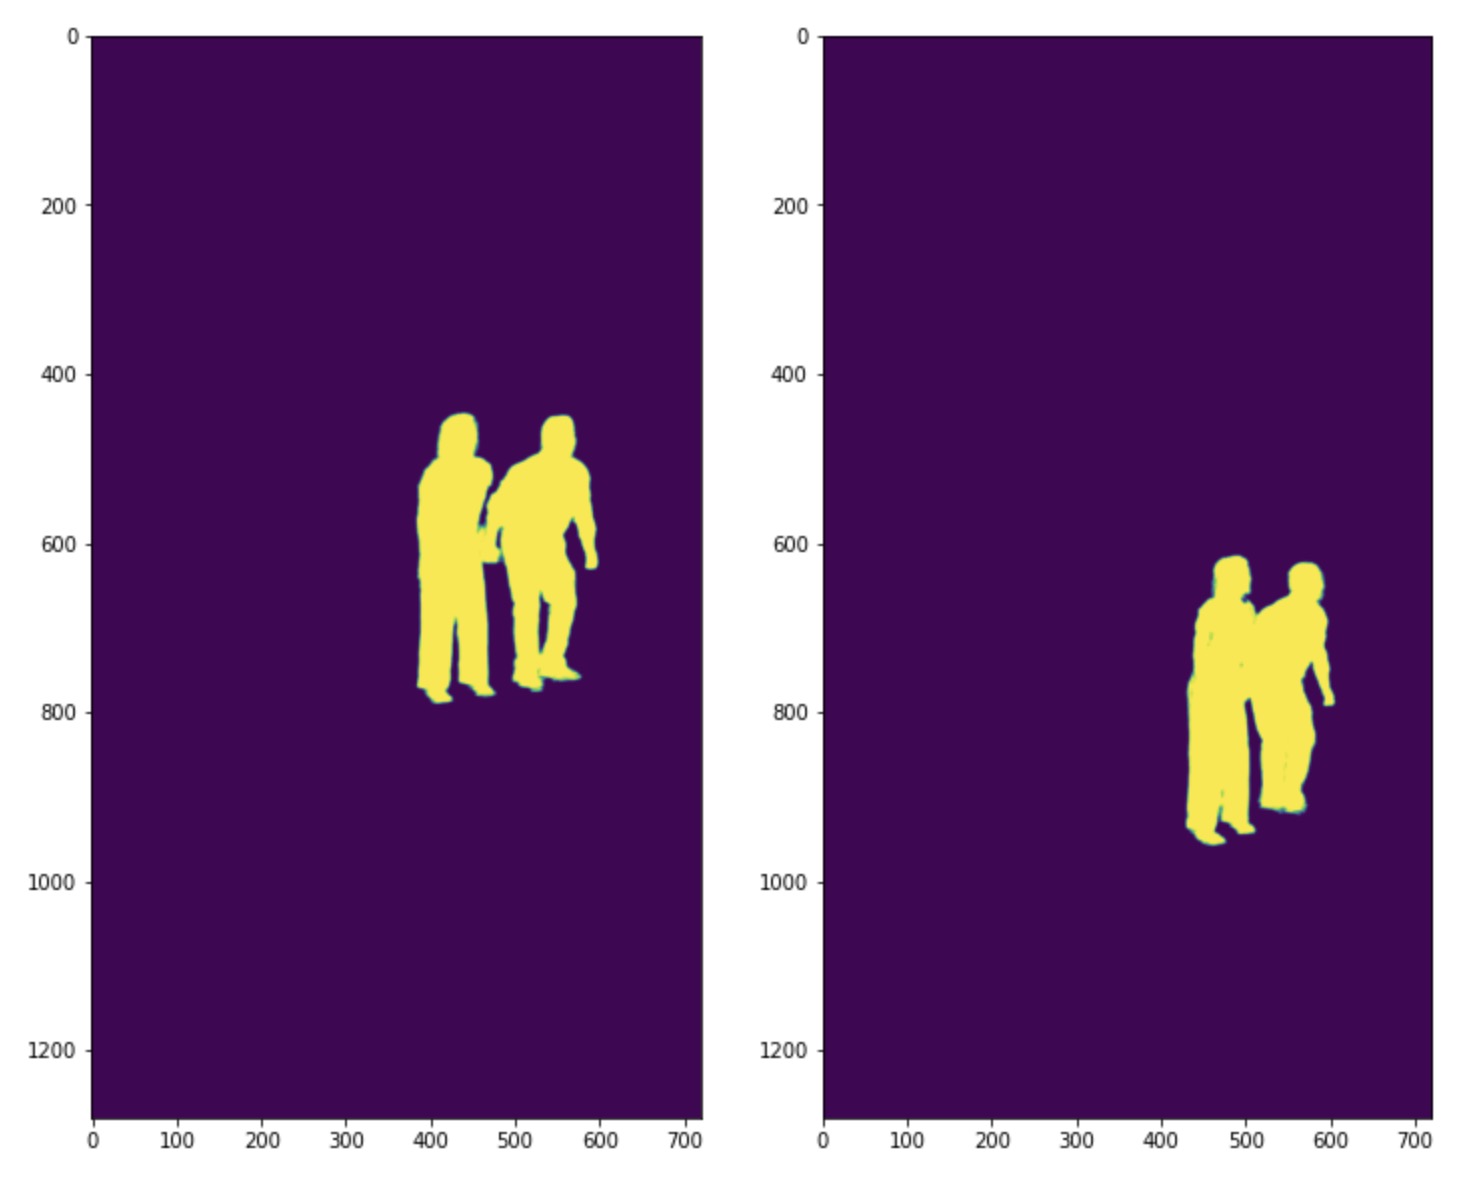
人物のセグメンテーションマスク
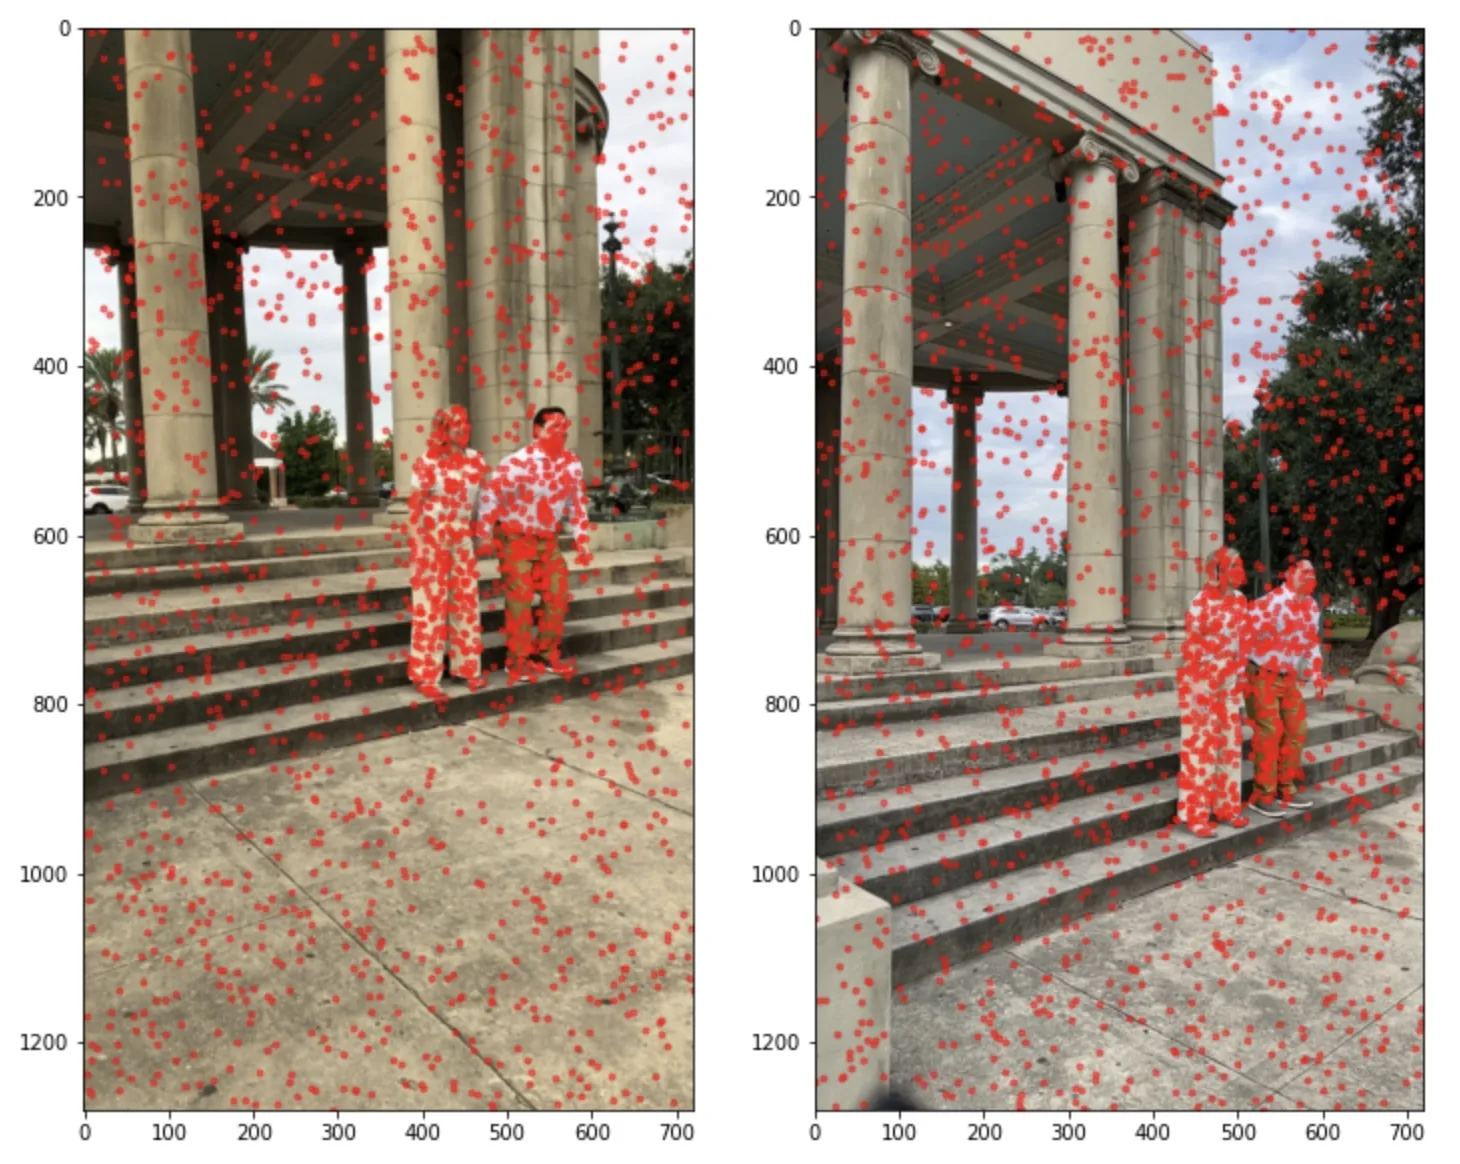
人物のセグメンテーションによるサンプリング
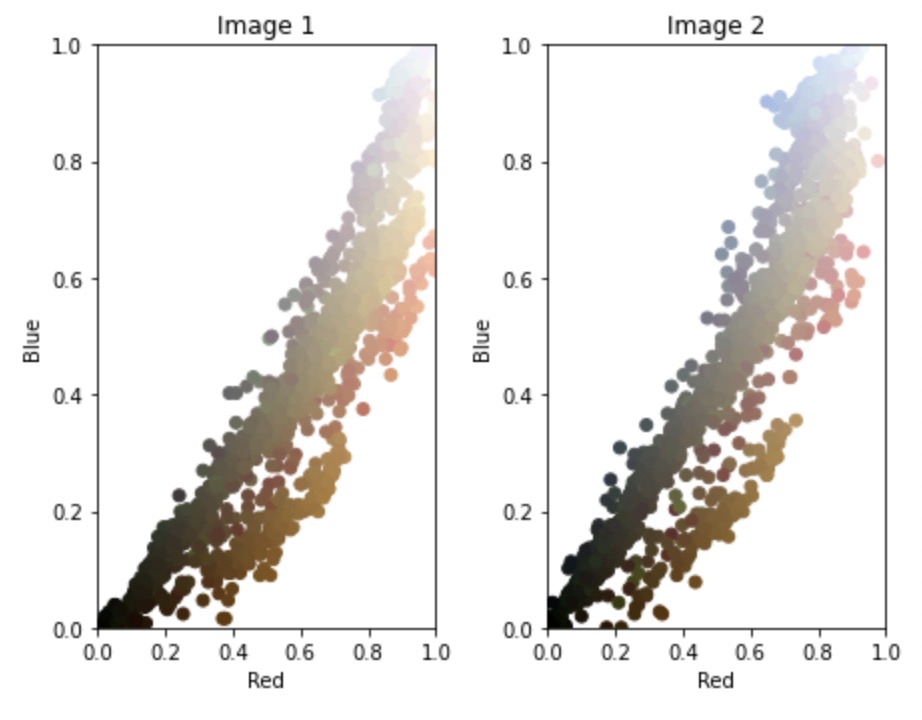
色のプロット
わずかな変化ですが、NeRFの再構築では違いが出ていると思います。
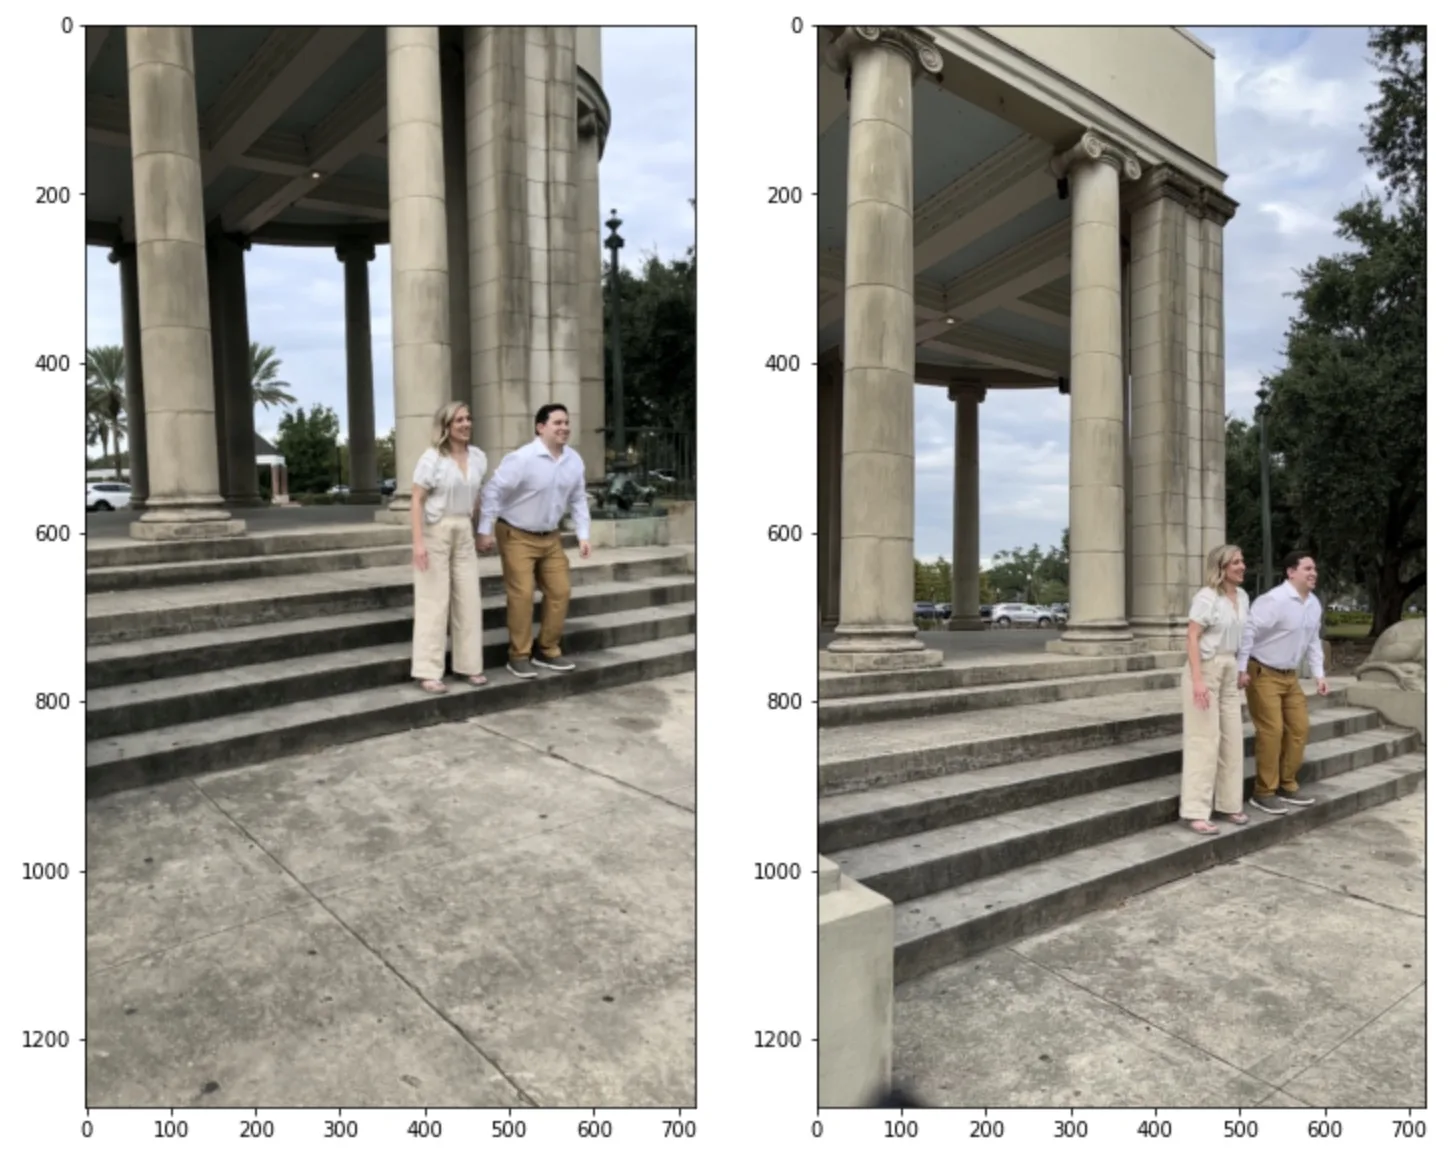
色合わせ後の画像
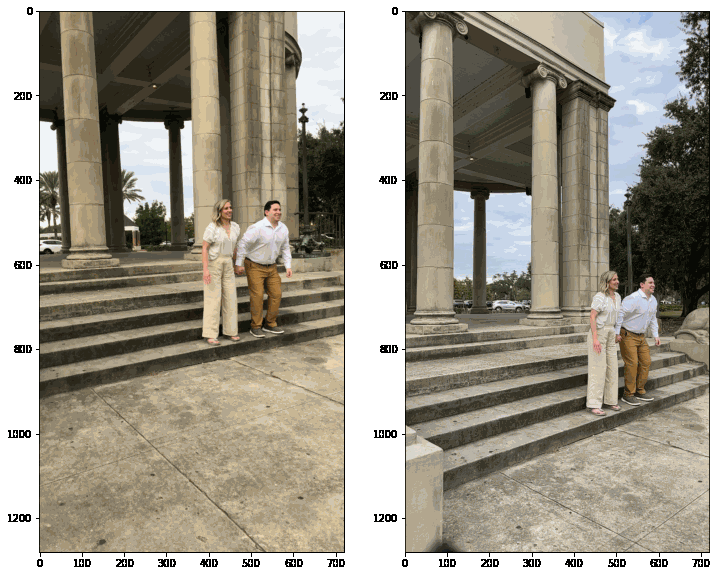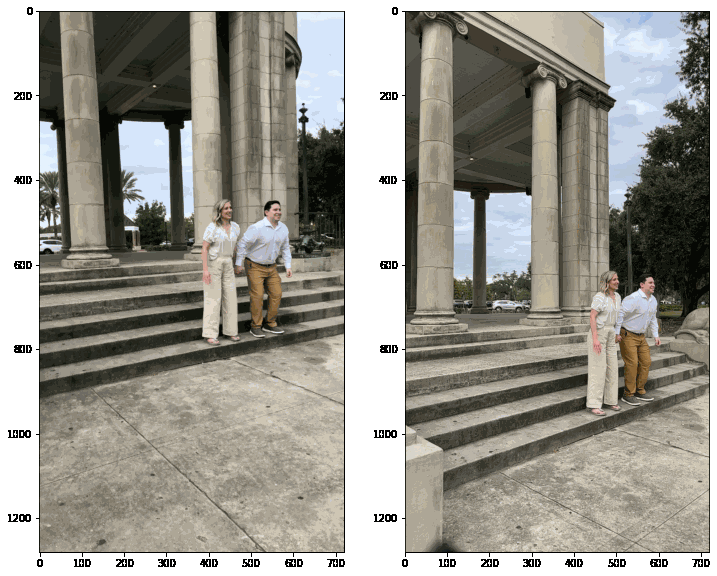
色合わせ後の画像のアニメーション
コード
これをもとに開発することにご興味がありましたら、メールでご連絡ください。
ご相談ください
プロジェクトでNeRFを活用するためのサポートが必要な場合は、メールをお送りください。
Laan Labs と協業する
Gaussian Splatting・ラディアンスフィールド
写真や動画からフォトリアルな3Dキャプチャを実現します。撮影プロトコルから学習、ブラウザやデバイスでの配信までを一貫して手がけます。
この記事をダウンロード
オフラインで読めるMarkdownソースを入手できます