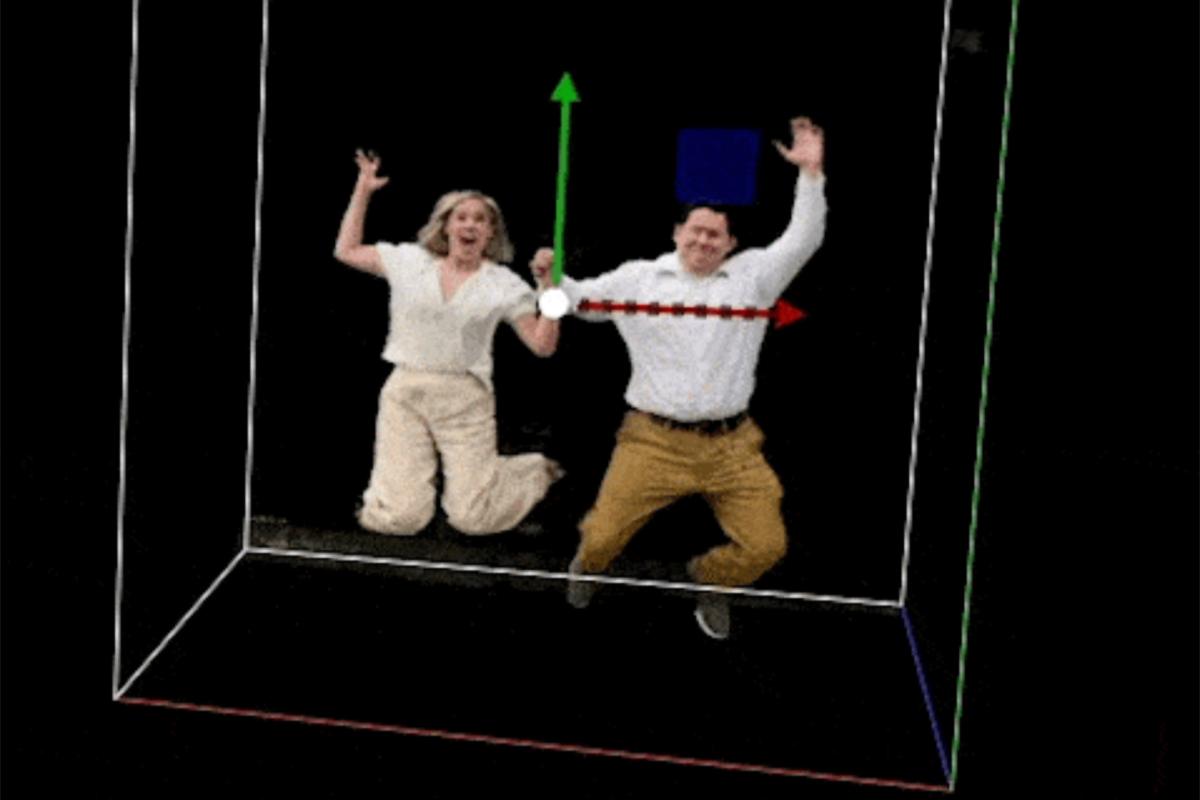
用 NeRF 实现慢动作“子弹时间”

太长不看
我们用 NeRF 和 15 部 iPhone 录制了体积 3D “子弹时间”视频
NeRF 子弹时间
完整视频
概述
上个月我表弟要结婚,我们为此拍了一组家庭合影。我趁这个机会重新捡起了一个我们已经琢磨了一段时间的想法。基本的想法是:召集一群朋友,用手机从不同角度拍摄同一个场景,最终得到一个定格画面,或者像《黑客帝国》里那样的“子弹时间”视频。
几年前我们刚开始琢磨这个想法时,NeRF 还不存在,所以我们没有好的办法来完成高质量的“视角合成”。这里的“视角合成”,指的就是从与最初拍摄场景时不同的视点渲染出场景的图像。
NeRF
NeRF,即神经辐射场(Neural Radiance Fields),作为一种用于视角合成和 3D 重建的出色新方法,迅速崭露头角。
神经辐射场是一种利用深度学习来表示和渲染 3D 场景的方法。NeRF 的核心思想是用神经网络预测场景在 3D 空间中每一点的辐射。给定一组场景的输入图像,神经网络学习预测场景的 3D 结构,以及每个点的表面反射和光照。最终得到的表示是一个连续函数,可以在 3D 空间中的任意点求值,从而能从任意视点对场景进行高度逼真的渲染。NeRF 可以生成复杂 3D 场景的高质量、照片级真实感的渲染图,有望彻底改变计算机图形学领域。
这个领域发展得非常快,几乎每天都有新方法和新改进出现。
你可以在这里了解更多关于 NeRF 的内容,或者阅读原始论文,也可以在 YouTube 上观看一些很酷的 NeRF 渲染视频。
2021 年,NVIDIA 发布了 Instant NGP,这是一个开源工具包,可以从图像或视频中快速创建 NeRF。Instant NGP 把 NeRF 的训练时间从几天缩短到了几分钟。
用 NeRF 做子弹时间以前就有人做过,而且新的 NeRF 扩展通过在现有 NeRF 模型中加入时间维度,可以表示动态场景。(参见“动态 NeRF”,例如 DNerf)
鉴于这是一个有趣的 / 快速的业余项目,我没来得及测试任何较新的方法,而是选择了 Instant NGP 所提供的易用性和快速训练时间。
Nerfstudio 是另一个值得一看的 NeRF 训练工具包。它甚至支持用于动态场景的“DNerf”,不过我还没有机会测试。
围绕 NeRF 的研究进展非常快,几个月之后,很可能就会出现更好 / 更快的方法来创建类似的东西。
拍摄视频
这个项目的第一个要求,是从不同角度拍摄场景的慢动作视频。较新的 iPhone 可以以 1920x1080 的分辨率、每秒 240 帧拍摄视频,这足以用来训练 NeRF。
把我们所有的测试设备都凑齐,再向家人借了一些之后,我们一共凑到了 15 部 iPhone。(不过通常一个 NeRF 场景会使用 40 - 100 张图像。)
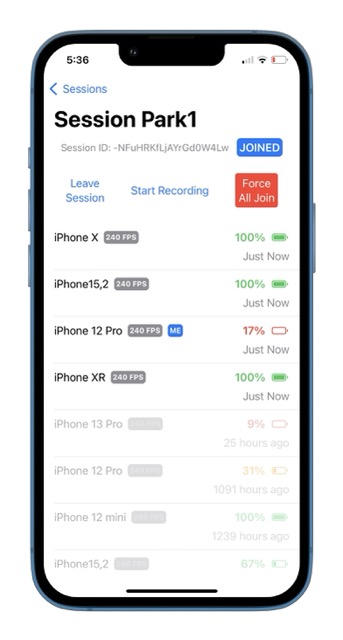
然后我做了一个简单的 Firebase Realtime 数据库应用,可以让所有手机同时开始录制。视频拍完之后,会自动上传到 Google Cloud Storage。
在一部手机上按下录制,所有已连接的设备都会开始录制。
多部手机同步录制
这个应用还会显示每台设备的电量和视频上传状态:
iPhone 三脚架
我们用廉价的木材做了一些简易三脚架,并请几位家人手持其余的手机:
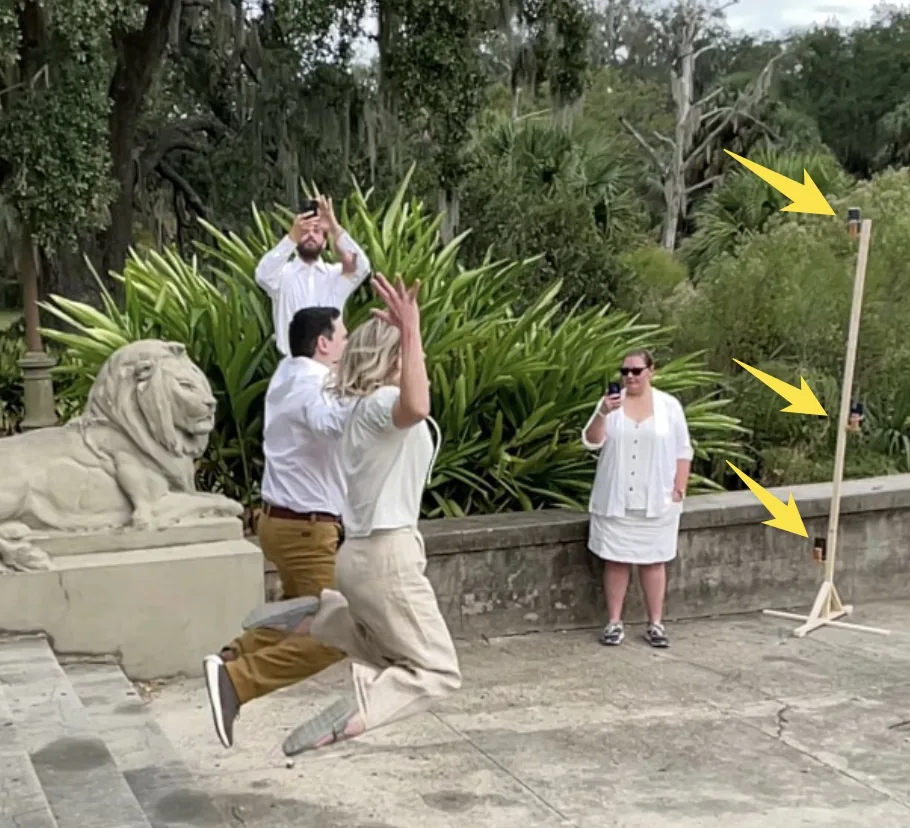
使用三脚架的拍摄布置
下面是不同手机拍到的一些图像:
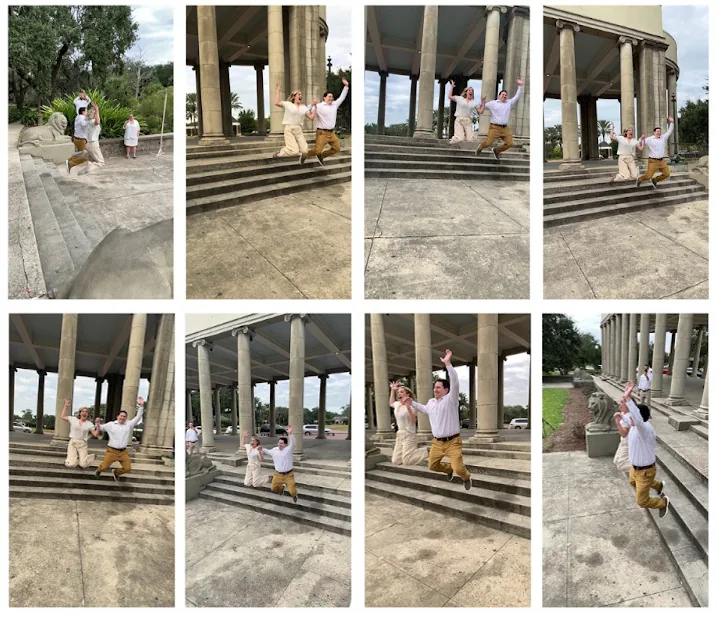
样例图像
应用在录制时确实锁定了对焦 / 曝光,但没有在各部手机之间同步这些数值,所以你可以看到图像中有一些色差。下文会详细谈到。
我们布置和拍摄场景的时间窗口很短,大概只有 10 分钟。如果时间更充裕,我可能会测试一些不同的相机布置,看看哪种效果最好。
视频时间同步
所有视频拍完之后,我们需要对它们进行时间同步。
作为开发者,我想把这个过程自动化,尽管如果只做一次的话,手动同步视频其实更快。
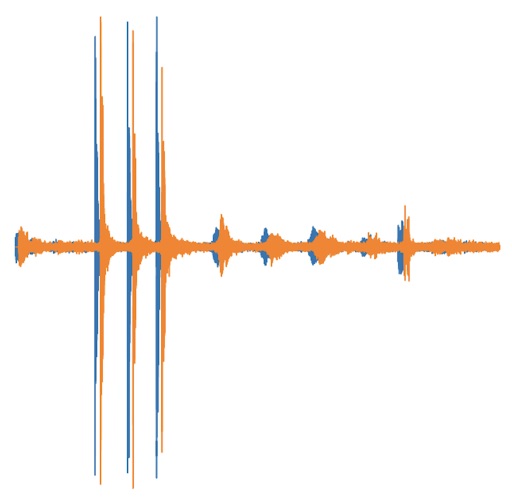
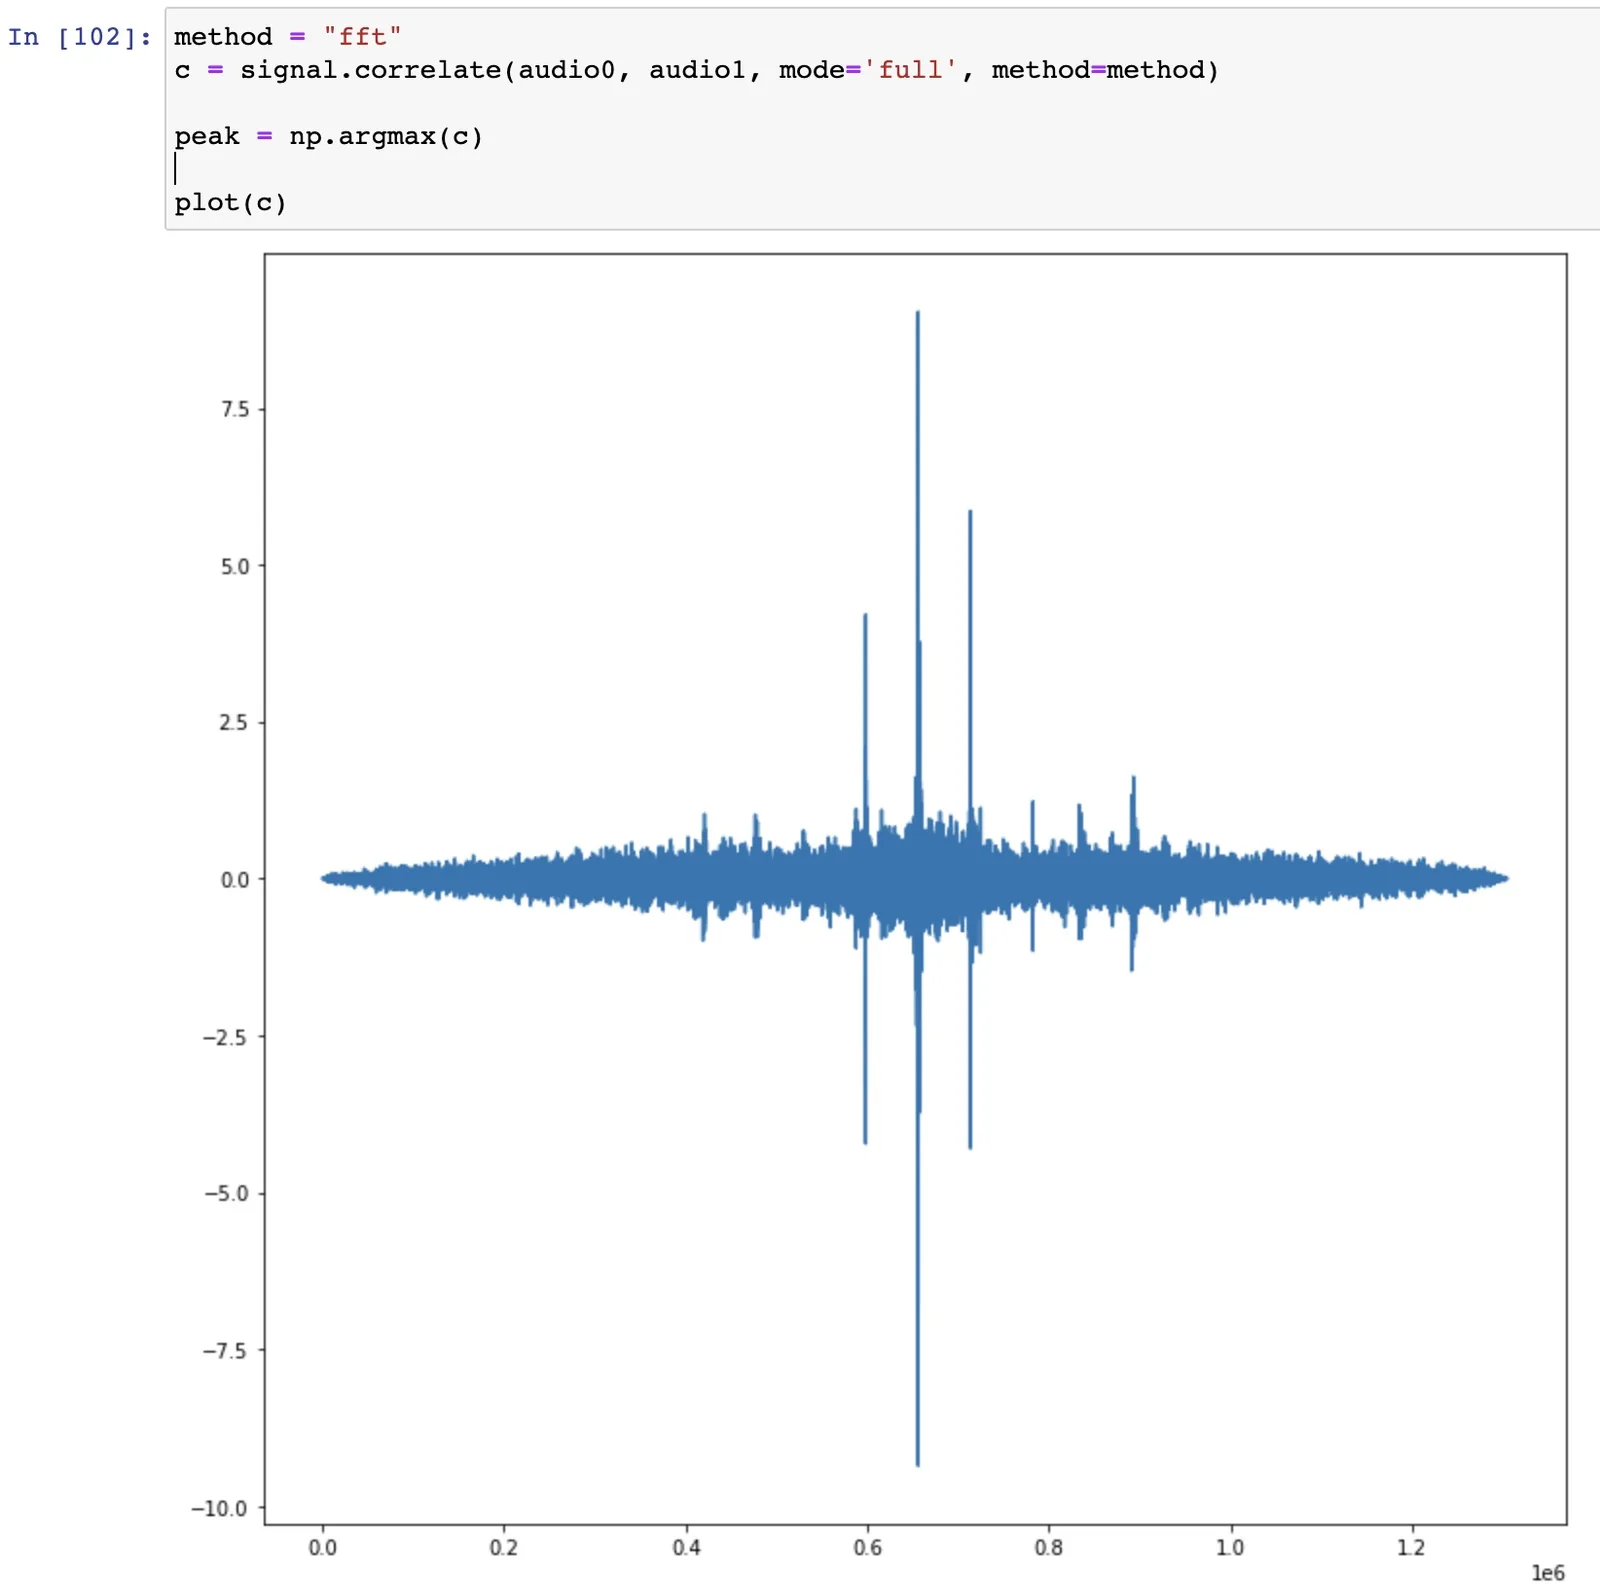
我最终写了一个小的 python 脚本,对音频流做互相关,以找出两段视频之间最佳的时间偏移。
为了让这个方法更可靠,我们带了两根金属棒,在录制开始时敲在一起。
两段未同步视频的音频波形:
音频对齐
互相关结果在两个信号对齐程度最高的位置出现了明显的峰值:
互相关
等所有视频都对齐到同一个全局时间之后,我从 15 部手机上共导出了一组约 200 个同步帧,大约是 3000 张图像。
训练 NeRF
下一步是用所有数据训练 NeRF,这里出现了几个值得一提的问题。
合并时间步
首先介绍一下 NeRF 训练过程的背景:
NeRF 的第一步是计算场景中所有图像的相机位姿。这一步使用 COLMAP 完成
对于子弹时间的情形,我们有多少个导出视频的时间步,就有多少个“场景”(即 200 个时间步)
所以我们需要确保相机位姿对齐到一个在整个视频中都不变的全局坐标系中。
如果在拍摄场景时所有相机都不动,那就很简单:只需计算第一帧的位姿,并在之后所有帧中复用。在我的情况下,有几部手机是由人手持拍摄的,这些手机在拍摄过程中会轻微移动。
由于总共只有 15 台相机,我不想丢掉那些轻微移动的手机所提供的重要相机角度。这就需要在 200 个时间步中,分别为这些动态相机计算相机位姿。
如果可以选择,下次我会让所有相机都固定在三脚架上,因为这样确实能大大简化位姿恢复的过程。
我尝试过几种不同的方法,但最终选择对 COLMAP 稍作定制,使其支持增量式场景重建。
我采用的方法是从一个“背景”场景开始,其中的相机位姿只计算一次,并在向其中添加新图像时保持固定。背景场景是在没有人的情况下拍摄的,所以我可以自由地拿着一部手机走动,拍摄大量图像。
视频中的每个“时间步”都有来自所有录制相机的 15 张图像。因此对于每个时间步,我们从背景场景开始,然后在固定背景场景相机位姿的前提下,向其中添加新图像。COLMAP 支持通过 “--Mapper.fix_existing_images” 选项把新图像添加到已有的静态场景中,但遗憾的是,它在 bundle adjustment(光束法平差)步骤中仍会修改基础相机位姿,在后续的归一化步骤中也是如此。我修改了 COLMAP,使其在传入 “fix_existing_images” 选项时,在 bundle adjustment 步骤中固定已有的相机位姿,并且不对场景做归一化。
背景场景
接下来出现的问题是,由于只有 15 台相机,训练出的 NeRF 只表示了被摄对象(人物)周围相当小的一块 3D 体积。移动相机去展示场景的其他部分,就会出现大量伪影 / 漂浮物:
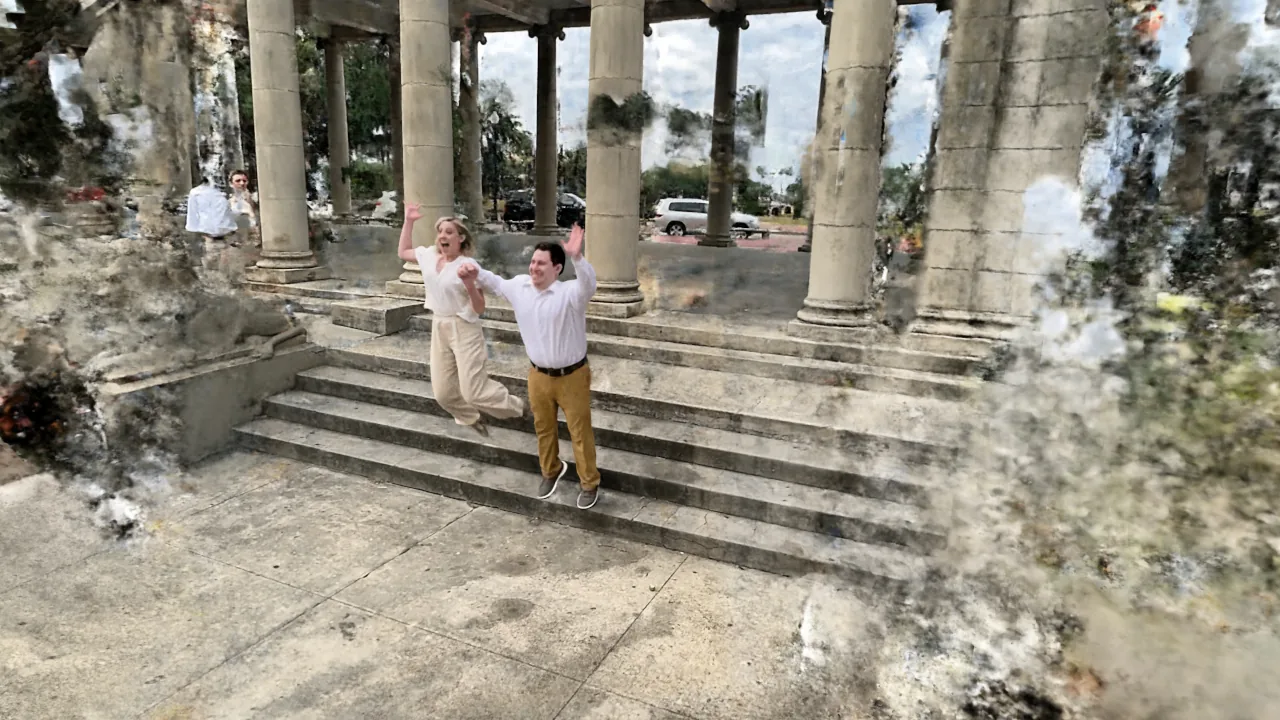
带有漂浮物的样例帧
所以为了渲染场景的其他部分,我拍摄了大约 200 张周边区域的图像,画面中没有任何人。
然后我单独训练了一个 NeRF,并让它与每个时间步的 NeRF 合成:
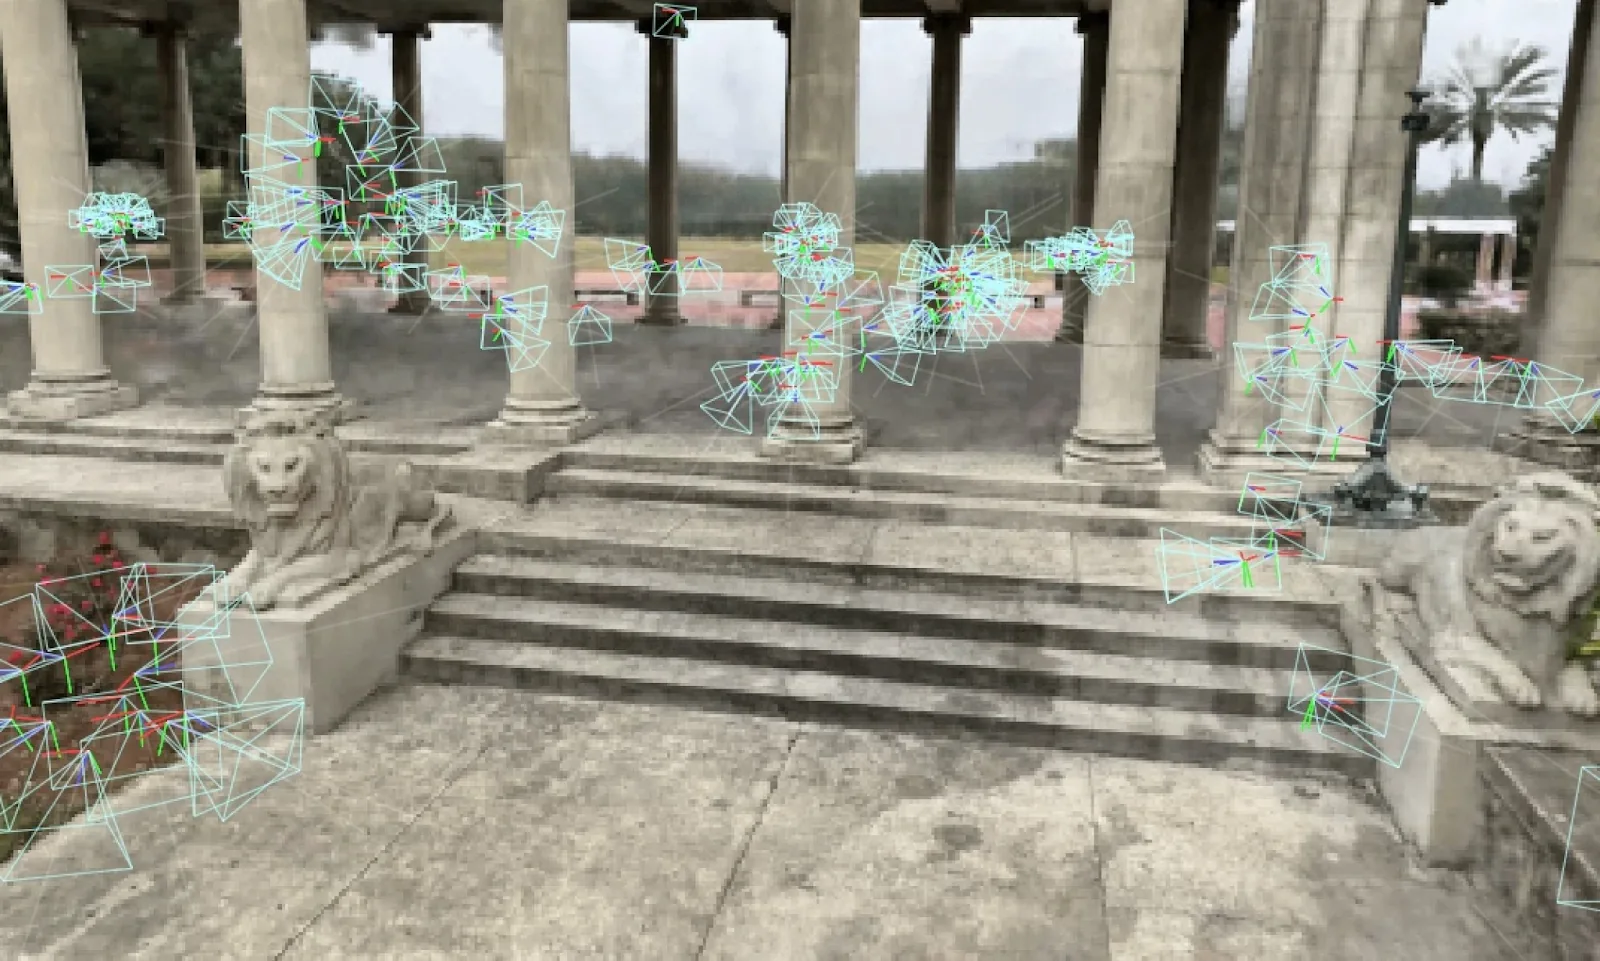
背景场景 NeRF 渲染图
如前所述,我定制的 COLMAP 方案意味着背景 NeRF 与每个时间步的 NeRF 已经处于同一个坐标系中,所以在渲染相机路径时,不同的渲染结果可以完美合成:
场景合成
不过,我得用裁剪体积和透明度来渲染动态 NeRF,以确保只渲染出人物:
前景裁剪体积
场景质量说明
下面是项目中遇到的一些质量 / 渲染问题的说明。
闪烁
我最初是单独训练每个 NeRF 时间步的,但是用所有 NeRF 生成动画时,出现了大量闪烁伪影:
时间闪烁
我试验了把前一个时间步已训练好的网络,作为后一个时间步的初始化(具体来说,是在大约 500 步之后保存一个快照,作为下一个时间步的初始值)
这确实改善了连续性,使网络在各个时间步上收敛到的解彼此相似。如果相机更多,我认为这就不会是个大问题,因为场景中的歧义空间会更小。
漂浮物
训练期间,当不同视图之间存在歧义时,就会出现被称为漂浮物(floaters)的伪影。增加相机视图可以减少这种情况,但在我们的例子中,要为动态场景增加更多相机并不容易。
调整训练时的“近距离(near distance)”确实有助于减少漂浮物。我差一点就实现了针对每台相机的近距离设置,以进一步减少漂浮物。
我还考虑构建的另一个想法是遮罩体积或平面。基本直觉是:“我知道这里是空的,所以不要在这里放任何漂浮物 / 密度”
地板 / 地平面就是一个例子。对于像这个场景这样有明显地平面的情况,如果我能设定不允许在地平面以下出现任何密度,那么从新视角看,地面的重建就会显得更加一致。
大块的空白体积也是如此:NeRF 经常会在那些很容易画一个巨大的立方体体积来把其中梯度“清零”的区域里学到密度。
我还想测试一下深度监督,看看它是否也能减少漂浮物。
正则化
许多后续的 NeRF 方法都加入了正则化,但据我所知,Instant NGP 仓库里并没有加入多少。如果有更多时间,我想探索一些技术,把网络训练推向正确的方向。
- MiDas 单目深度监督
- 用于平滑表面的法线一致性先验
最终,由于使用了基于大量视图训练出的干净背景场景,加上被遮罩出来的人物,漂浮物就不是什么大问题了。
如果你的相机角度有限,这些想法可能就值得探索。
色彩匹配
来自不同手机的一些帧,色调略有差异:
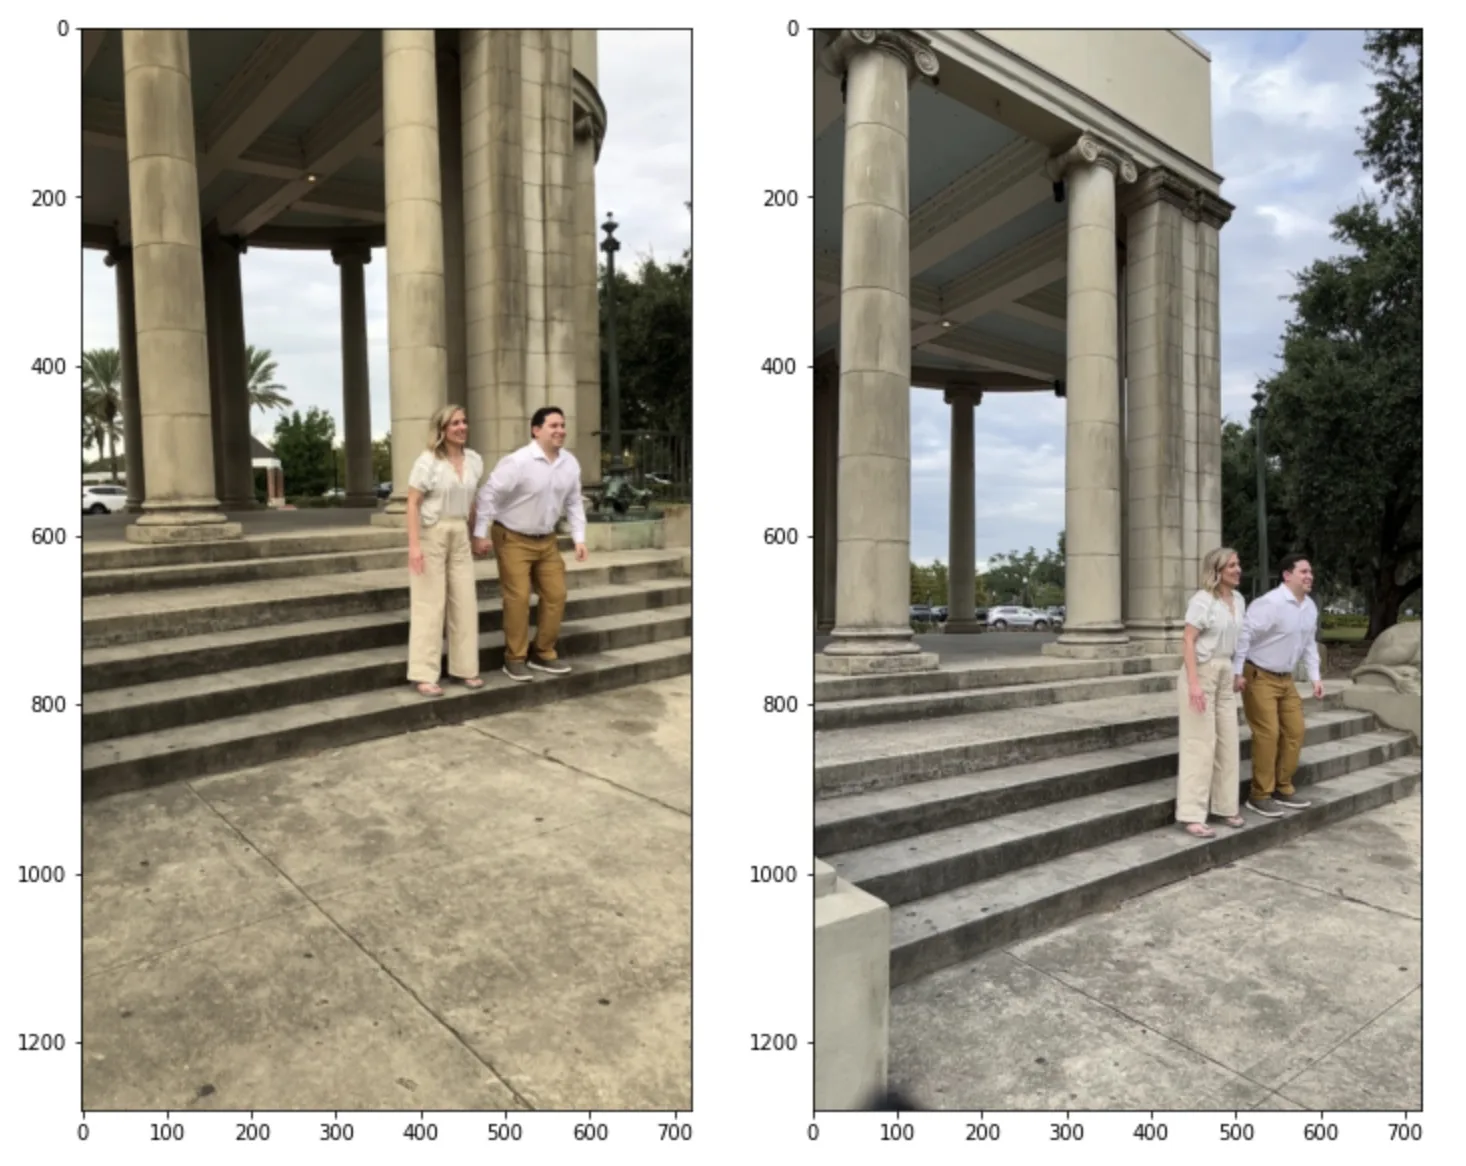
色调不匹配
在图像中加入校准标记,也许能让自动解决这个问题稍微容易一些。解决或改善这个问题大概有很多办法。比如在拍摄端,也许可以在所有手机之间同步白平衡 / 曝光。我没有探索其他技术来解决这个问题。
一个想法是在各图像中选取相同的点,然后求解一个颜色变换,使图像之间的色差减小。
可能的问题是,在不同图像中无法恰好命中同一个像素。
使用 COLMAP 的 SIFT 特征也许有帮助,但由于 SIFT 特征往往位于边缘 / 高对比度处,同一个 3D 点投影到不同图像中时,我们最终选中的颜色可能并不相同。
最优传输
我尝试过的第一个也是唯一一个解决这个问题的办法,是对颜色直方图做最优传输。
我在网上找到了一些来自 Python Optimal Transport / POT 库的不错的代码示例,见这里:
我唯一稍微有点巧思的修改,是对图像中的人物进行更密集的采样,因为那是我最关心的部分,而且每张画面里都有人物。
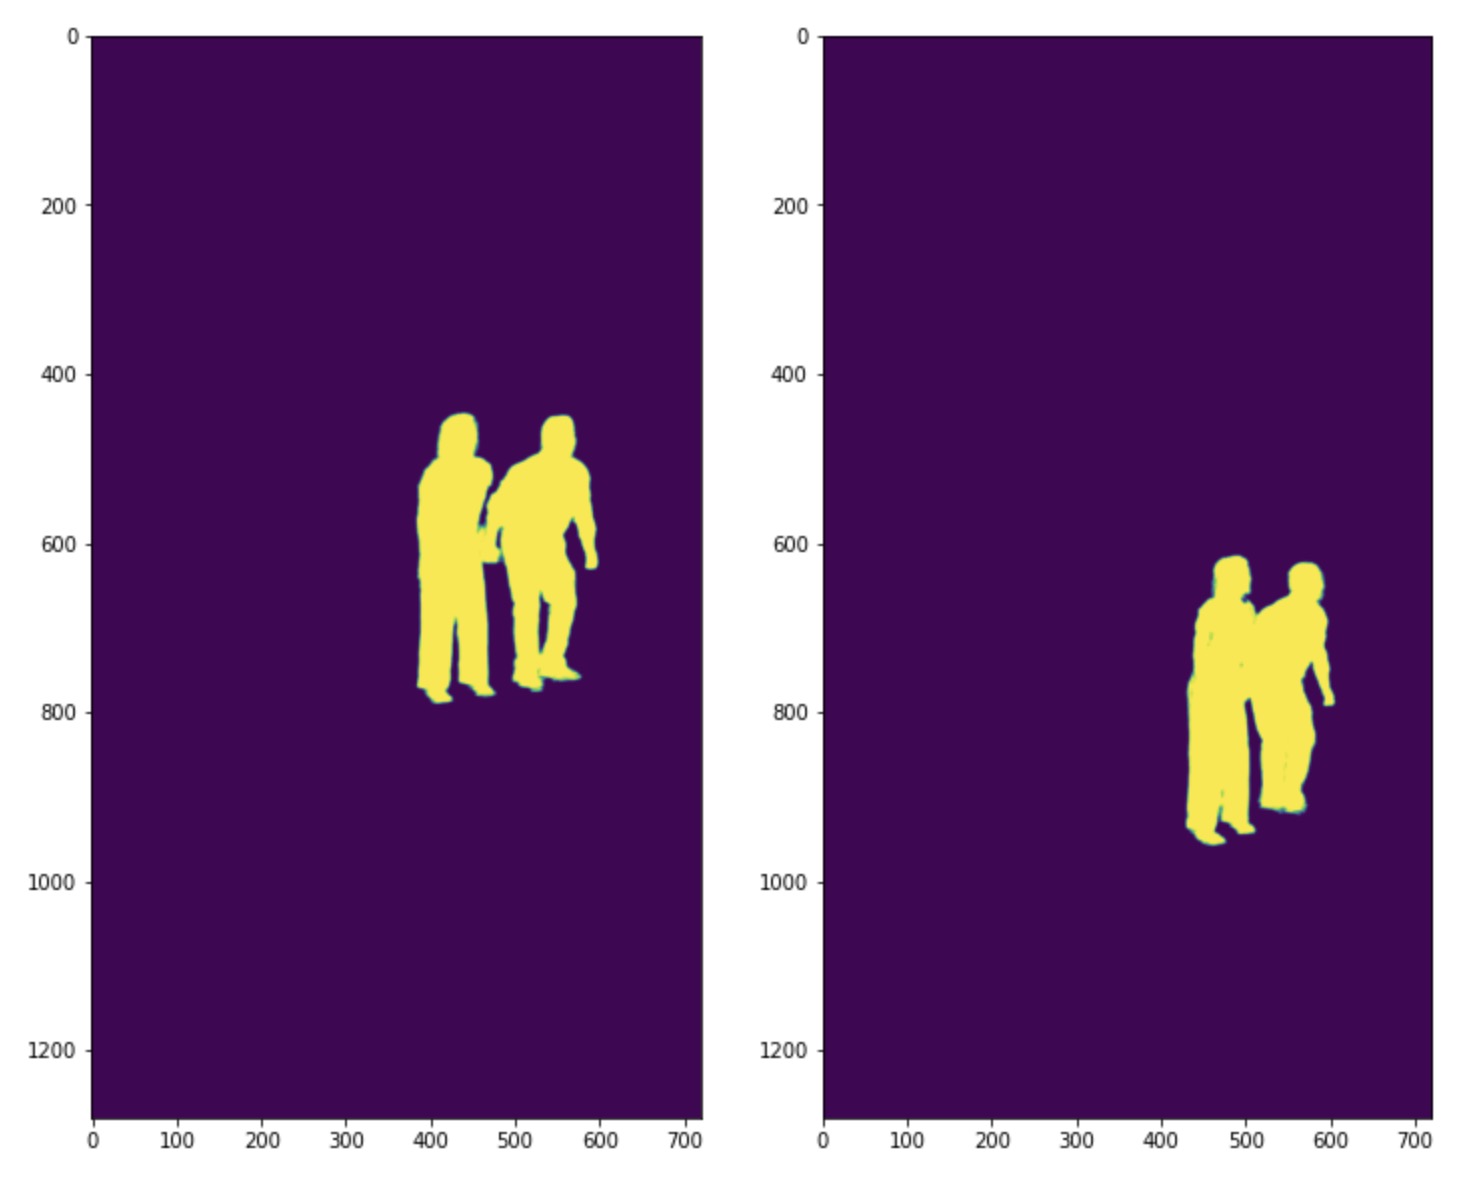
人物分割遮罩
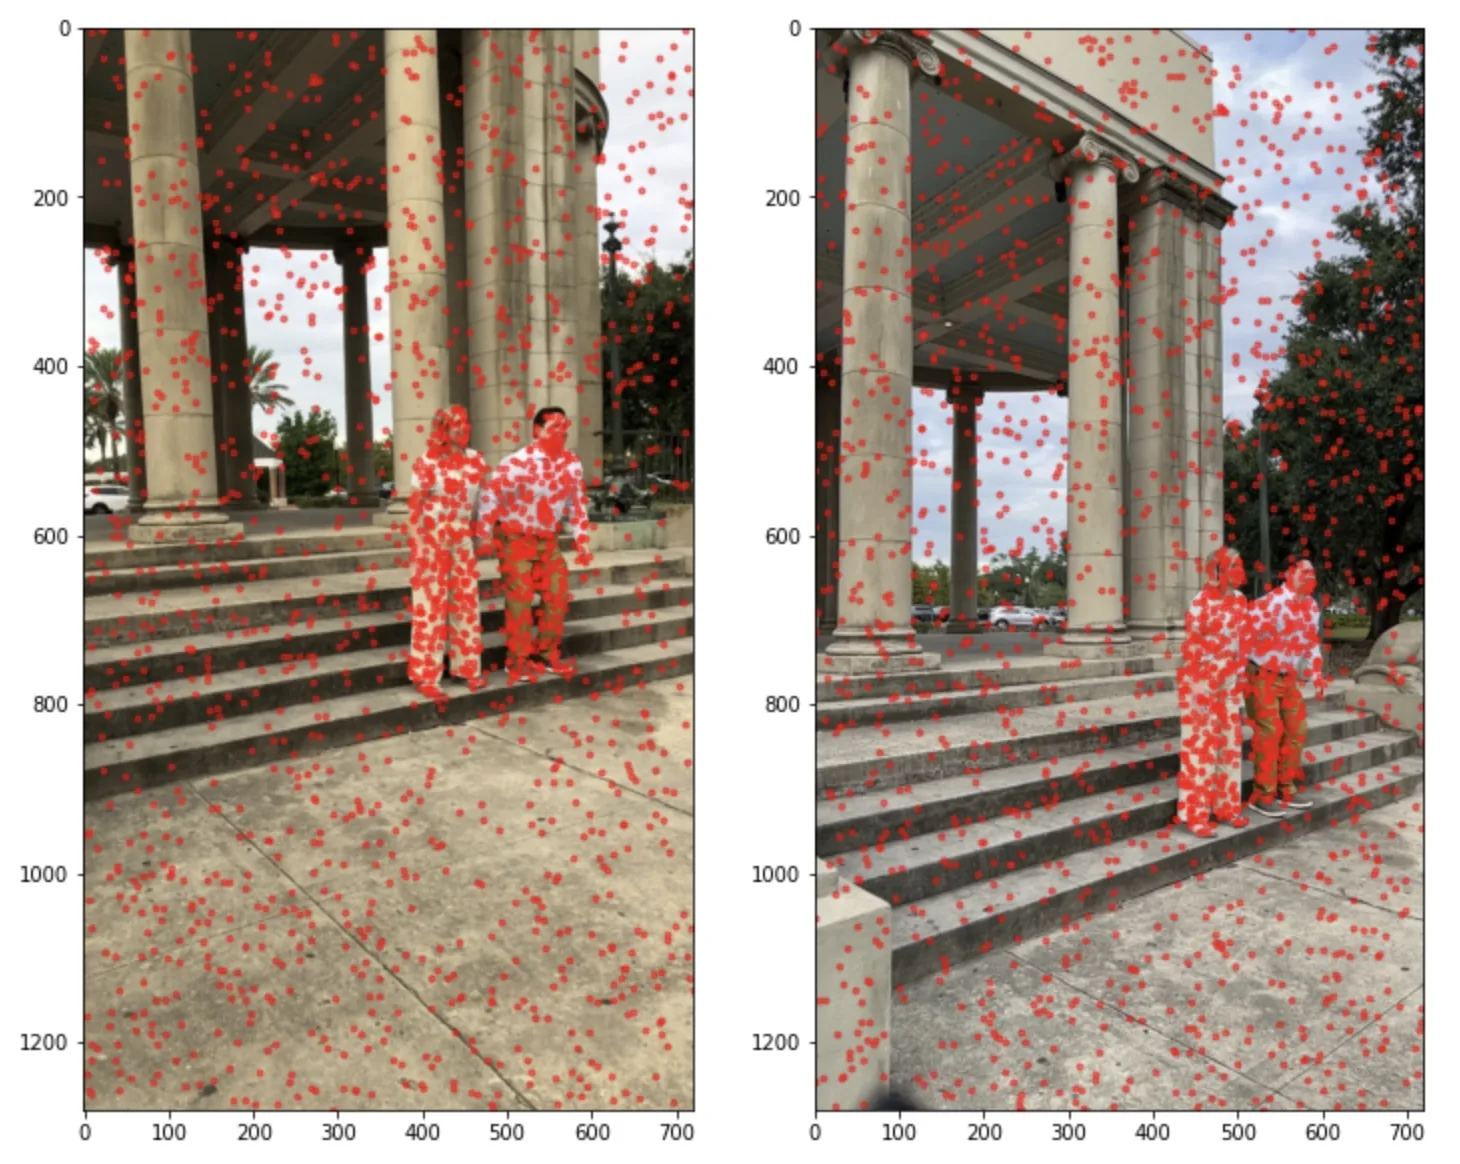
人物分割采样
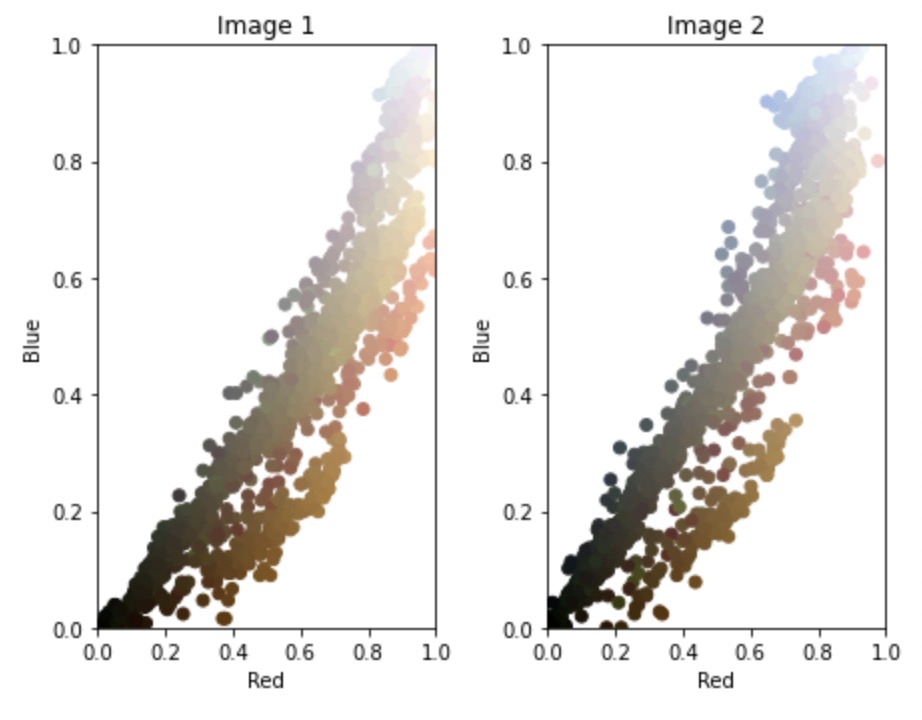
颜色分布图
这个变化很细微,但我认为它对 NeRF 重建有影响:
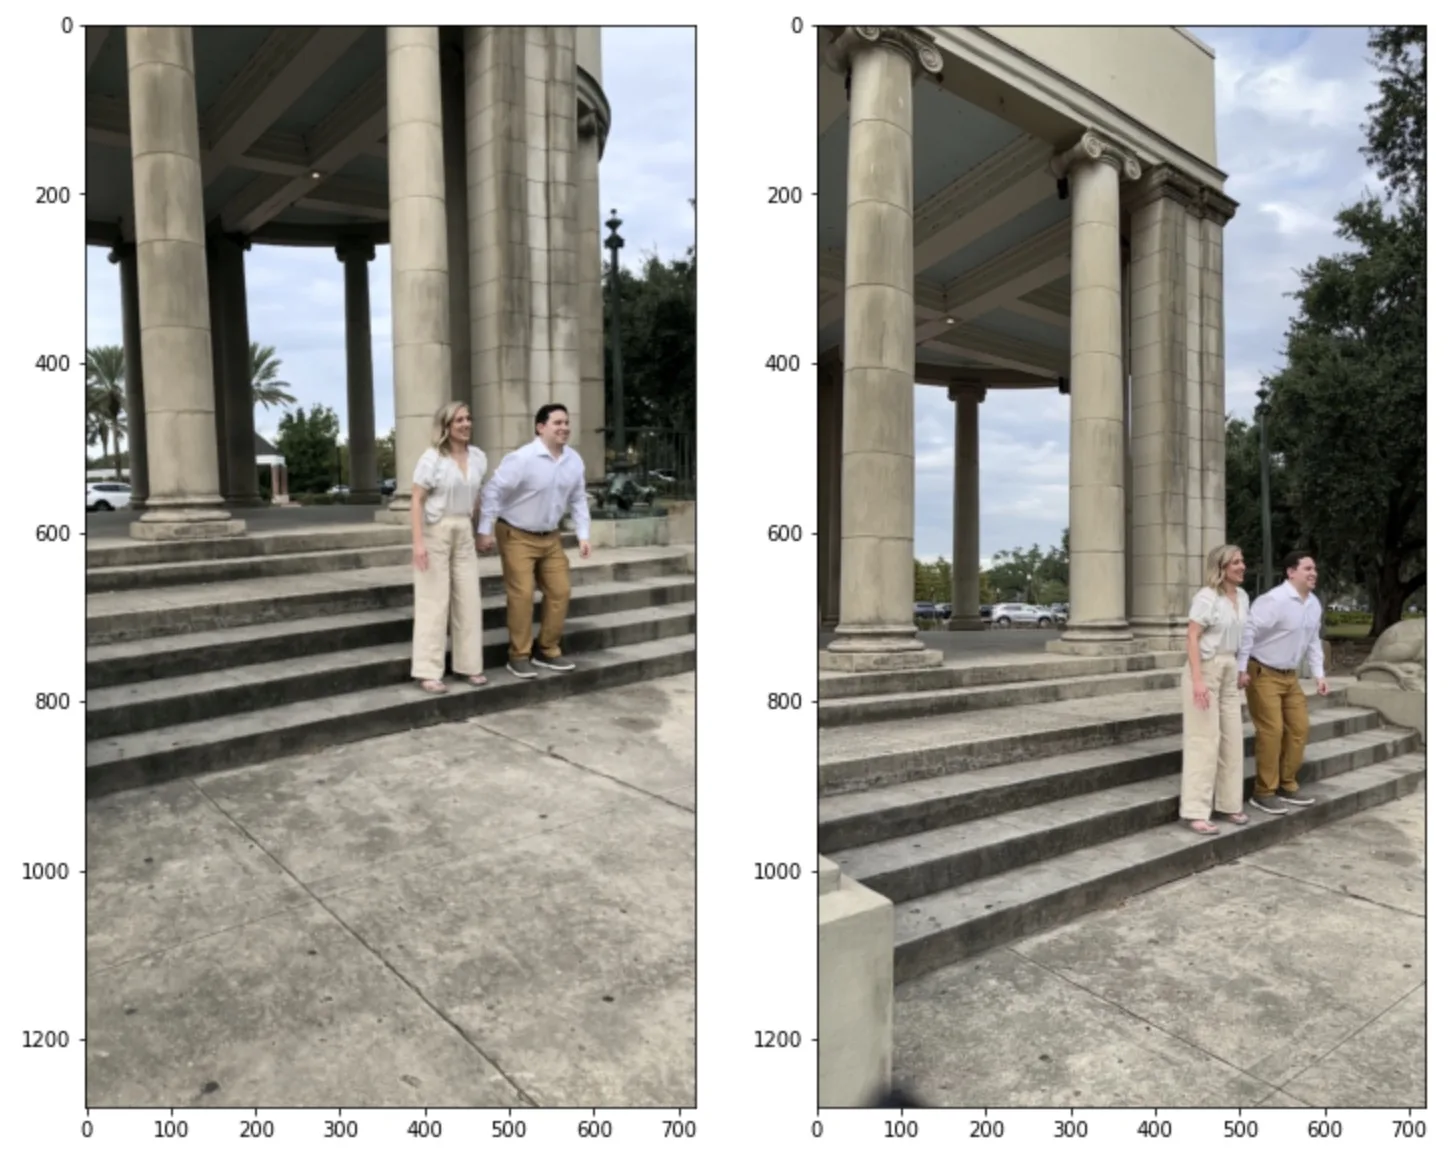
匹配后的图像
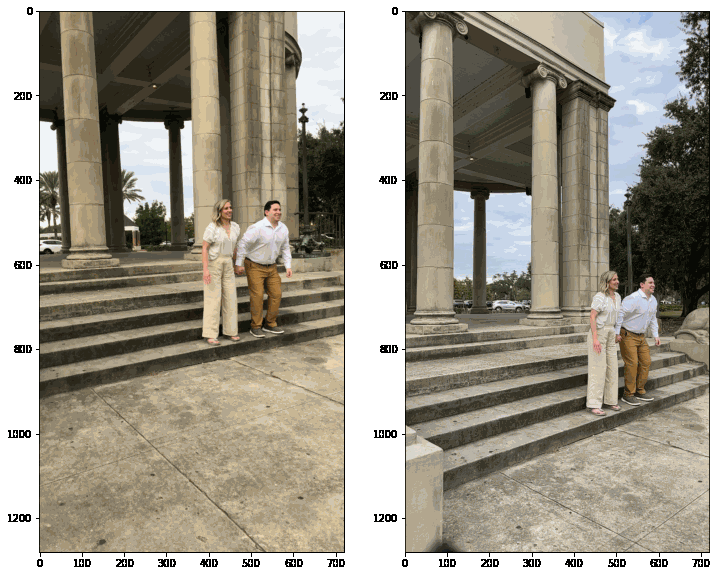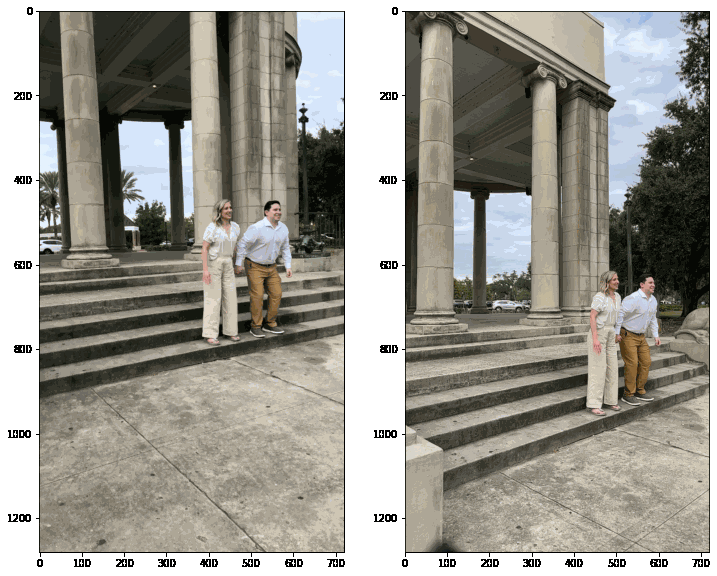
匹配后的图像动画
代码
如果你有兴趣在此基础上继续开发,请给我们发邮件
与我们合作
如果您需要帮助,在项目中使用 NeRF,欢迎给我们发邮件。
与 Laan Labs 合作
Gaussian Splatting 与辐射场
基于照片和视频的照片级真实感 3D 采集,从采集规范、训练到在浏览器或设备上交付。
下载本文
获取 Markdown 源文件,方便离线阅读