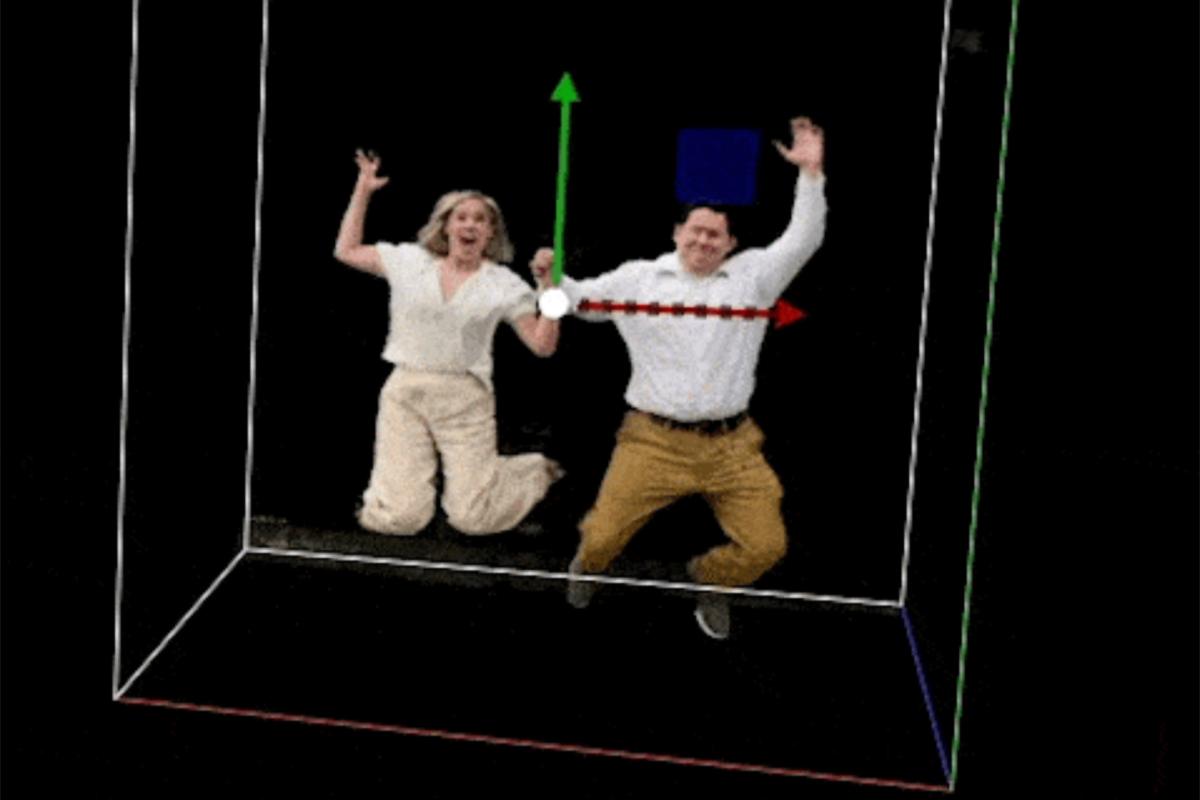
Zeitlupen-„Bullet Time“ mit NeRFs

TLDR
Wir haben mit NeRFs und 15 iPhones volumetrisches 3D-„Bullet-Time“-Video aufgenommen
NeRF Bullet Time
Das ganze Video
Überblick
Mein Cousin hat letzten Monat geheiratet, und aus diesem Anlass gab es ein Familienfotoshooting. Ich nutzte die Gelegenheit, eine Idee wieder aufzugreifen, mit der wir schon länger herumspielen. Die Grundidee: Ein paar Freunde zusammenbringen, um eine Szene mit Mobiltelefonen aus verschiedenen Winkeln zu erfassen. Das Endergebnis wäre ein Freeze Frame oder ein Bullet-Time-Video wie in Matrix.
Als wir vor Jahren erstmals mit der Idee gespielt haben, gab es noch keine NeRFs, wir hatten also keine gute Möglichkeit für eine hochwertige „View Synthesis“. „View Synthesis“ bedeutet hier einfach, Bilder einer Szene aus Blickwinkeln zu rendern, die sich von denen unterscheiden, aus denen die Szene ursprünglich aufgenommen wurde.
NeRFs
NeRFs, also Neural Radiance Fields, haben sich rasant als erstaunliche neue Methode für View Synthesis und 3D-Rekonstruktion etabliert.
Neural Radiance Fields sind eine Methode, 3D-Szenen mit Deep Learning darzustellen und zu rendern. Die Grundidee hinter NeRFs besteht darin, mit einem neuronalen Netz die Radiance einer Szene an jedem Punkt im 3D-Raum vorherzusagen. Anhand einer Menge von Eingabebildern einer Szene lernt das neuronale Netz, die 3D-Struktur der Szene sowie die Oberflächenreflexion und die Beleuchtung an jedem Punkt vorherzusagen. Die resultierende Darstellung ist eine kontinuierliche Funktion, die sich an jedem Punkt im 3D-Raum auswerten lässt und so ein äußerst realistisches Rendering der Szene aus jedem Blickwinkel ermöglicht. NeRFs können hochwertige, fotorealistische Renderings komplexer 3D-Szenen erzeugen und haben das Potenzial, die Computergrafik zu revolutionieren.
Das Feld entwickelt sich so schnell, dass fast täglich neue Ansätze und Verbesserungen erscheinen.
Mehr zu NeRFs können Sie hier lesen oder das Originalpapier hier, oder sich auf YouTube ein paar tolle NeRF-Renderings ansehen.
2021 veröffentlichte NVIDIA Instant NGP, ein Open-Source-Toolkit, mit dem sich NeRFs schnell aus Bildern oder Videos erstellen lassen. Instant NGP verkürzte die NeRF-Trainingszeit von Tagen auf Minuten.
Bullet Time mit NeRFs wurde schon umgesetzt, und neue NeRF-Erweiterungen ermöglichen die Darstellung dynamischer Szenen, indem sie bestehenden NeRF-Modellen eine Zeitkomponente hinzufügen. (Siehe „Dynamic NeRFs“ wie DNerf)
Da dies ein spaßiges / schnelles Nebenprojekt war, konnte ich keine der neueren Ansätze ausprobieren und habe mich für die einfache Bedienung und die kurzen Trainingszeiten von Instant NGP entschieden.
Nerfstudio ist ein weiteres NeRF-Trainings-Toolkit, das einen Blick wert ist. Es unterstützt sogar „DNerf“ für dynamische Szenen, aber ich hatte noch keine Gelegenheit, es zu testen.
Die Forschung rund um NeRFs schreitet so schnell voran, dass es in ein paar Monaten wahrscheinlich bessere / schnellere Methoden gibt, um so etwas zu erstellen.
Videos aufnehmen
Die erste Voraussetzung für das Projekt ist, Zeitlupenvideos einer Szene aus verschiedenen Winkeln aufzunehmen. Neuere iPhones können Video mit 240 Bildern pro Sekunde in einer Auflösung von 1920x1080 aufnehmen, was gut genug ist, um das NeRF damit zu trainieren.
Nachdem wir alle unsere Testgeräte zusammengesammelt und Familienmitglieder gefragt hatten, kamen wir auf 15 iPhones. (Typischerweise würde eine NeRF-Szene eher 40 bis 100 Bilder verwenden.)
Dann habe ich eine einfache App mit einer Firebase-Realtime-Datenbank erstellt, mit der ich die Aufnahme auf allen Telefonen gleichzeitig starten kann. Sobald die Videos aufgenommen waren, wurden sie automatisch in Google Cloud Storage hochgeladen.
Drückt man auf einem Telefon auf Aufnahme, startet die Aufnahme auf allen verbundenen Geräten.
Synchronisierte Aufnahme über mehrere Telefone
Die App zeigt außerdem den Akkustand und den Upload-Status des Videos für jedes Gerät an:
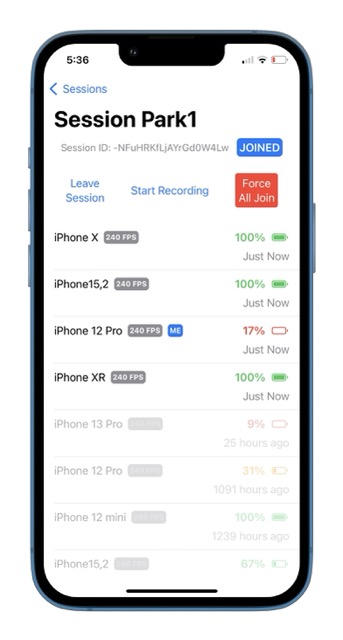
iPhone-Stative
Wir haben einfache Stative aus billigem Bauholz gebaut und einige Familienmitglieder gebeten, die übrigen Telefone zu halten:
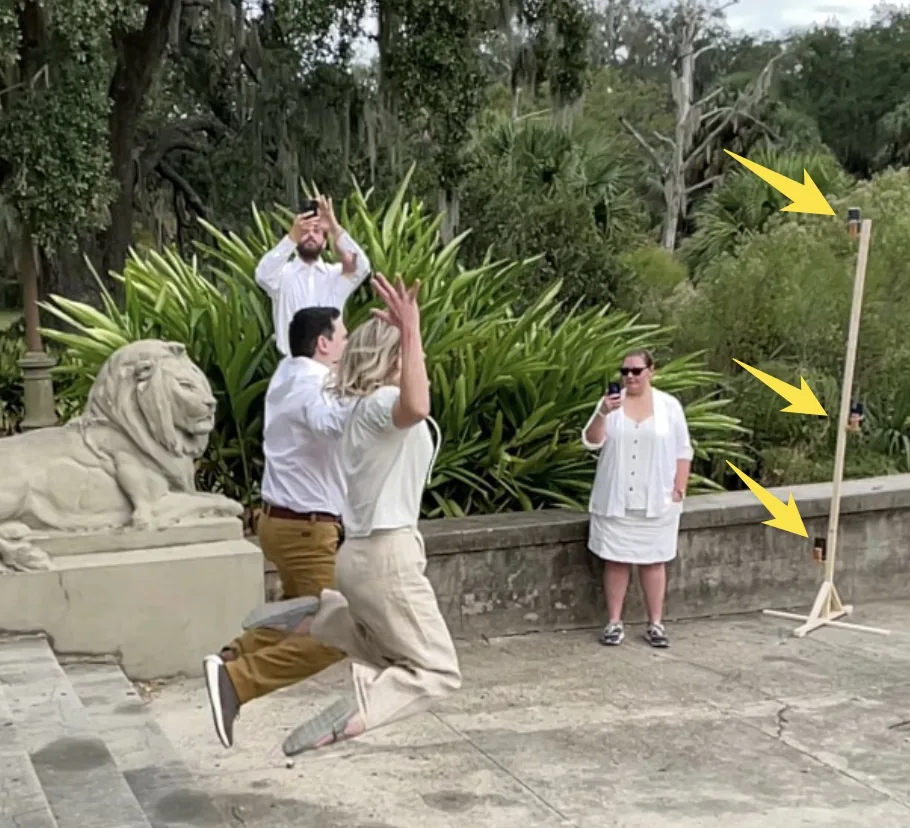
Aufnahmeaufbau mit Stativ
Hier einige der aufgenommenen Bilder der verschiedenen Telefone:
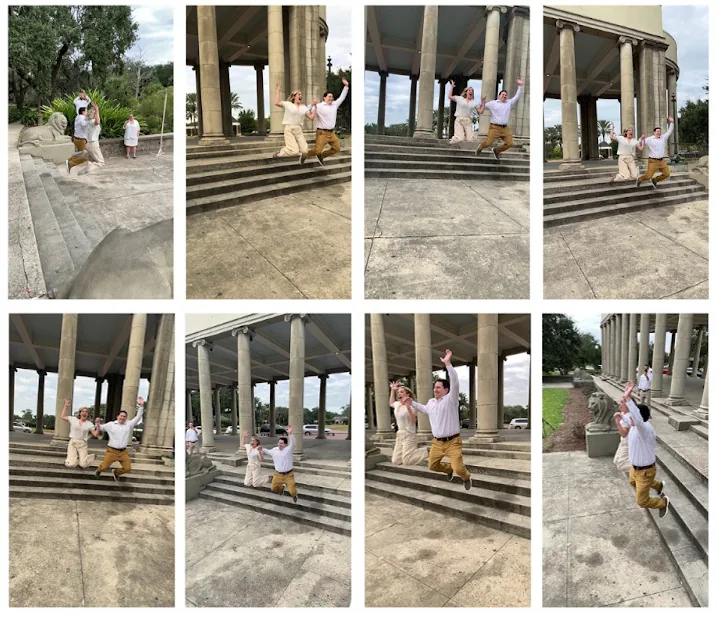
Beispielbilder
Die App hat Fokus / Belichtung bei der Aufnahme gesperrt, diese Werte aber nicht zwischen den Telefonen synchronisiert, weshalb Sie in den Bildern einige Farbunterschiede sehen. Dazu unten mehr.
Wir hatten ein ziemlich kurzes Zeitfenster von vielleicht 10 Minuten, um die Szene aufzubauen und aufzunehmen. Mit mehr Zeit würde ich wahrscheinlich einige verschiedene Kameraaufbauten testen, um zu sehen, was am besten funktioniert.
Zeitsynchronisierung der Videos
Nachdem wir alle Videos aufgenommen hatten, mussten wir sie zeitlich synchronisieren.
Als Entwickler wollte ich diesen Prozess automatisieren, obwohl das manuelle Synchronisieren der Videos bei einmaliger Durchführung schneller gewesen wäre.
Am Ende habe ich ein kleines Python-Skript geschrieben, das eine Kreuzkorrelation der Audiospuren durchführt, um den besten zeitlichen Versatz zwischen zwei Videos zu finden.
Um das robuster zu machen, hatten wir zwei Metallstäbe dabei, die wir zu Beginn der Aufnahme aneinanderschlugen.
Audio-Wellenformen von zwei nicht synchronisierten Videos:
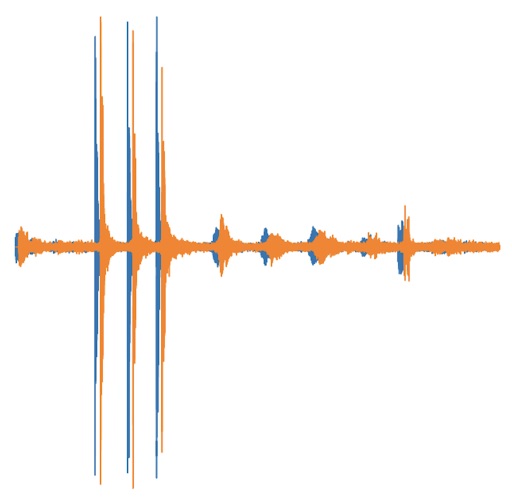
Audio-Ausrichtung
Die Kreuzkorrelation zeigt einen deutlichen Peak dort, wo die beiden Signale maximal übereinstimmen:
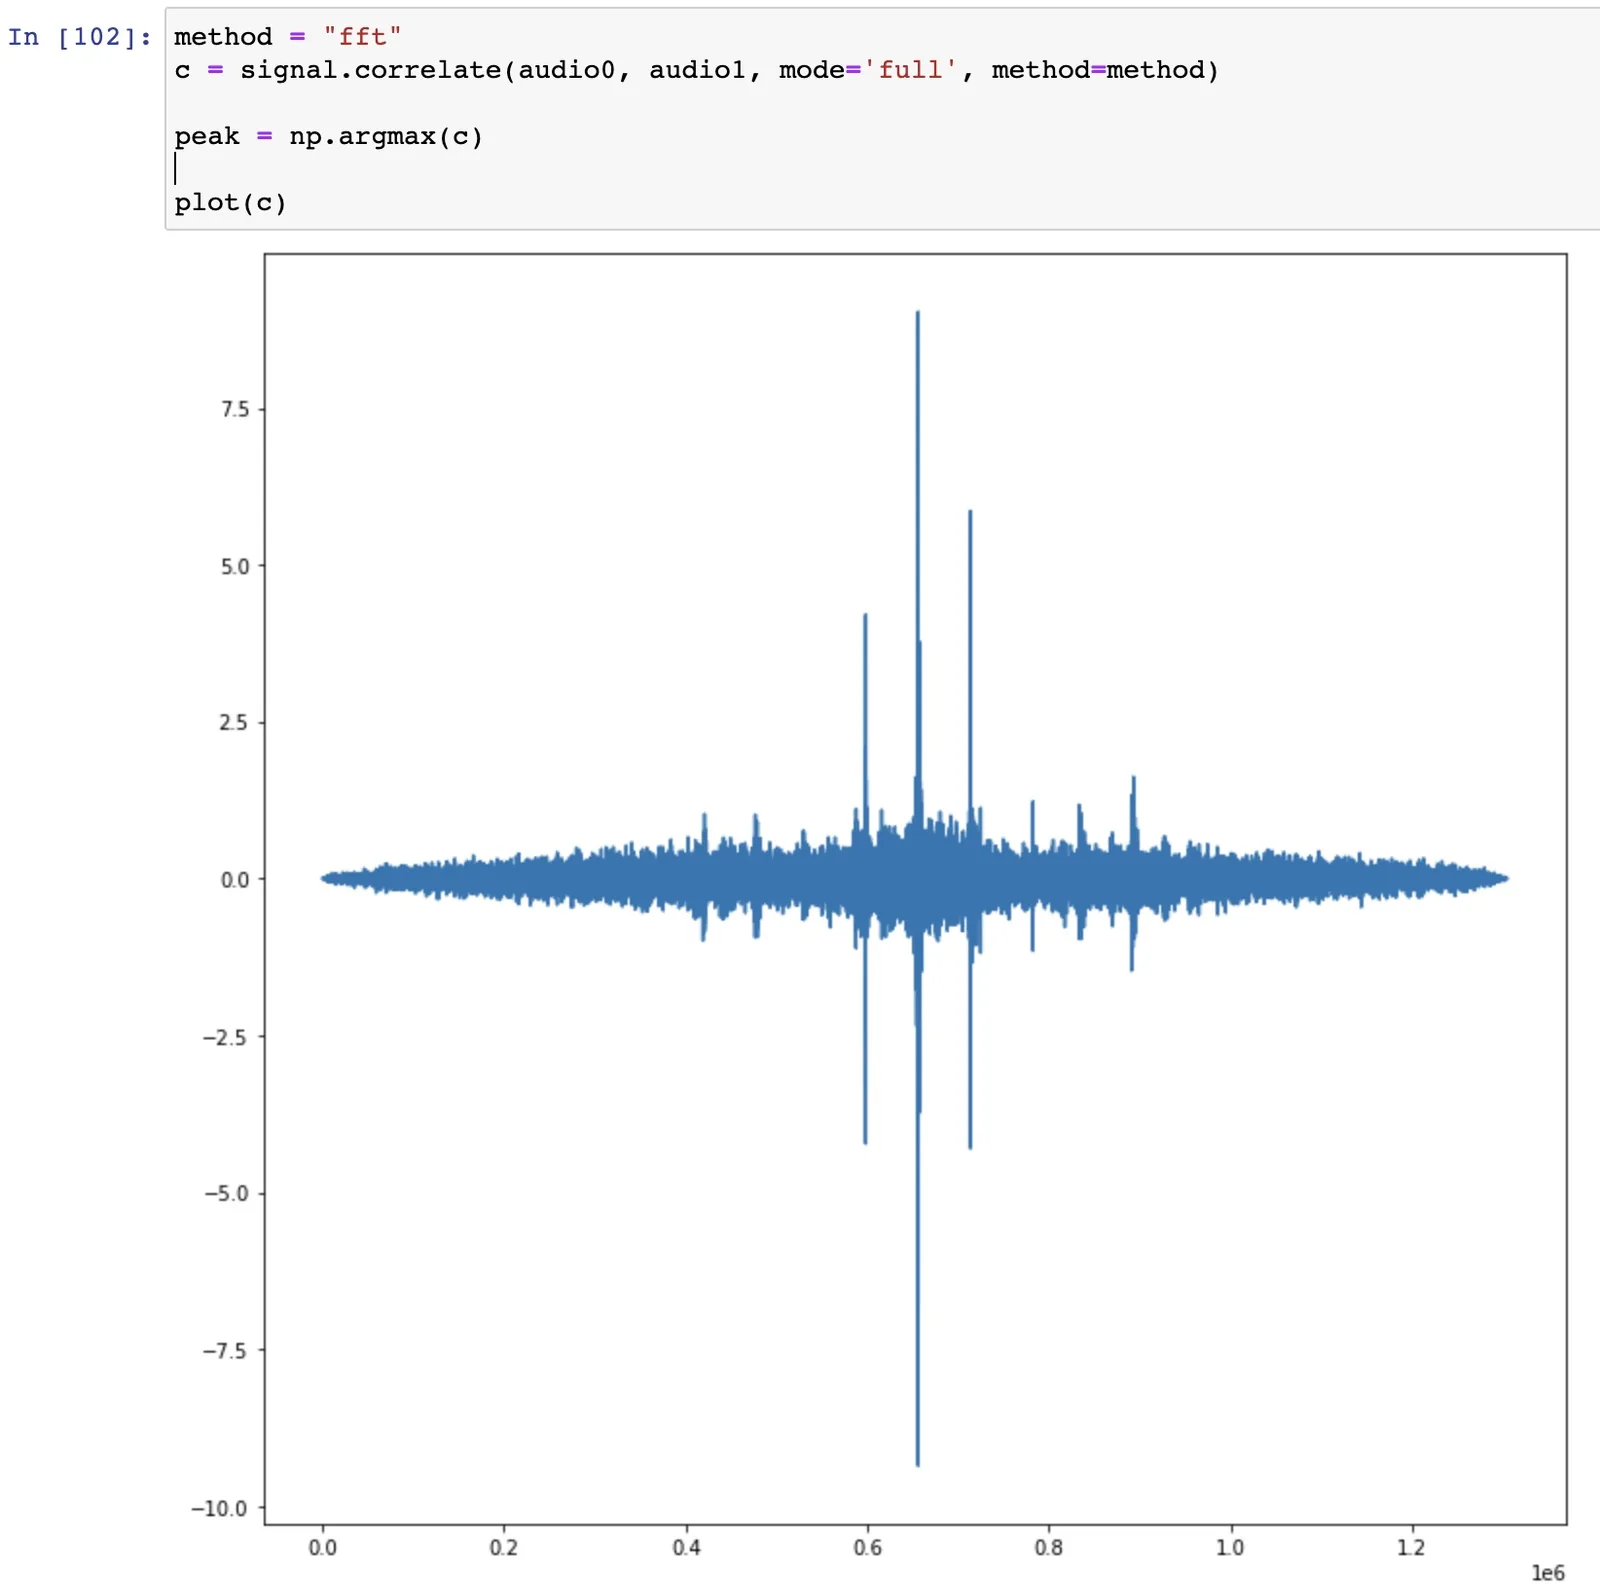
Kreuzkorrelation
Sobald alle Videos auf dieselbe globale Zeit ausgerichtet waren, habe ich von allen 15 Telefonen einen Satz von ca. 200 synchronisierten Einzelbildern exportiert. Das ergibt etwa 3000 Bilder.
Die NeRFs trainieren
Der nächste Schritt ist, die NeRFs mit allen Daten zu trainieren. Dabei traten einige erwähnenswerte Probleme auf.
Zeitschritte kombinieren
Zunächst etwas Hintergrund zum NeRF-Trainingsprozess:
Der erste Schritt bei NeRF ist, die Kameraposen für alle Bilder der Szene zu berechnen. Dafür wird COLMAP verwendet
Im Bullet-Time-Fall haben wir so viele „Szenen“, wie es Zeitschritte in unseren exportierten Videos gibt (also 200 Zeitschritte)
Wir brauchen also eine Möglichkeit sicherzustellen, dass die Kameraposen in einem globalen Koordinatensystem ausgerichtet sind, das sich im Verlauf des Videos nicht ändert.
Wenn sich keine Kamera während der Aufnahme der Szene bewegt, ist das ziemlich einfach: Man berechnet einfach die Posen für das erste Bild und verwendet sie für alle folgenden Bilder wieder. In meinem Fall haben Personen einige der Telefone während der Aufnahme gehalten, und diese Telefone bewegten sich beim Filmen leicht.
Bei nur 15 Kameras wollte ich die wichtigen Kamerawinkel der Telefone, die sich leicht bewegt hatten, nicht verlieren. Das erforderte, die Kameraposen der dynamischen Kameras für jeden der 200 Zeitschritte zu berechnen.
Wenn ich die Wahl hätte, würde ich beim nächsten Mal nur statische Kameras auf Stativen verwenden, da das die Posenrekonstruktion erheblich vereinfacht.
Ich habe einige verschiedene Ansätze ausprobiert, mich aber dafür entschieden, COLMAP leicht anzupassen, um eine inkrementelle Szenenrekonstruktion zu ermöglichen.
Der gewählte Ansatz beginnt mit einer „Hintergrund“-Szene, in der die Kameraposen einmal berechnet werden und fest bleiben, während neue Bilder hinzugefügt werden. Die Hintergrundszene wurde ohne Personen aufgenommen, sodass ich frei mit einem einzelnen Telefon herumlaufen und viele Bilder aufnehmen konnte.
Jeder „Zeitschritt“ im Video besteht aus 15 Bildern aller aufnehmenden Kameras. Für jeden Zeitschritt beginnen wir also mit der Hintergrundszene und fügen dann neue Bilder hinzu, während die Kameraposen der Hintergrundszene fixiert bleiben. COLMAP unterstützt das Hinzufügen neuer Bilder zu einer bestehenden statischen Szene über die Option „--Mapper.fix_existing_images“, verändert aber leider trotzdem die Basis-Kameraposen im Schritt der Bündelausgleichung (Bundle Adjustment) und weiter im Normalisierungsschritt. Ich habe COLMAP so geändert, dass es bestehende Kameraposen in den Schritten der Bündelausgleichung fixiert und die Szene nicht normalisiert, wenn die Option „fix_existing_images“ übergeben wird.
Hintergrundszene
Das nächste Problem war, dass das resultierende trainierte NeRF bei nur 15 Kameras lediglich ein ziemlich kleines 3D-Volumen um das Motiv (die Personen) herum abbildete. Wenn man die Kamera bewegte, um andere Teile der Szene zu zeigen, entstanden viele Artefakte / Floater:
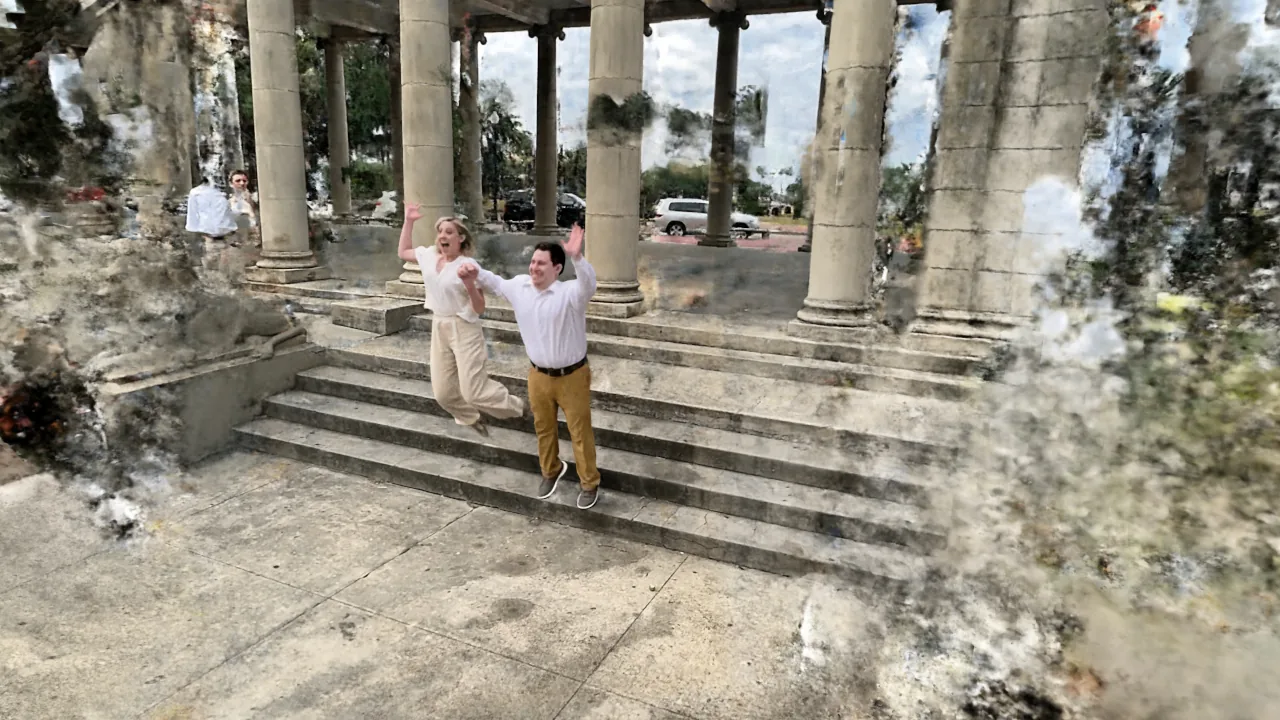
Beispielbild mit Floatern
Um die anderen Teile der Szene rendern zu können, habe ich daher etwa 200 Bilder der Umgebung ohne Personen aufgenommen.
Anschließend habe ich ein separates NeRF trainiert, das mit dem NeRF jedes Zeitschritts zusammengesetzt wird:
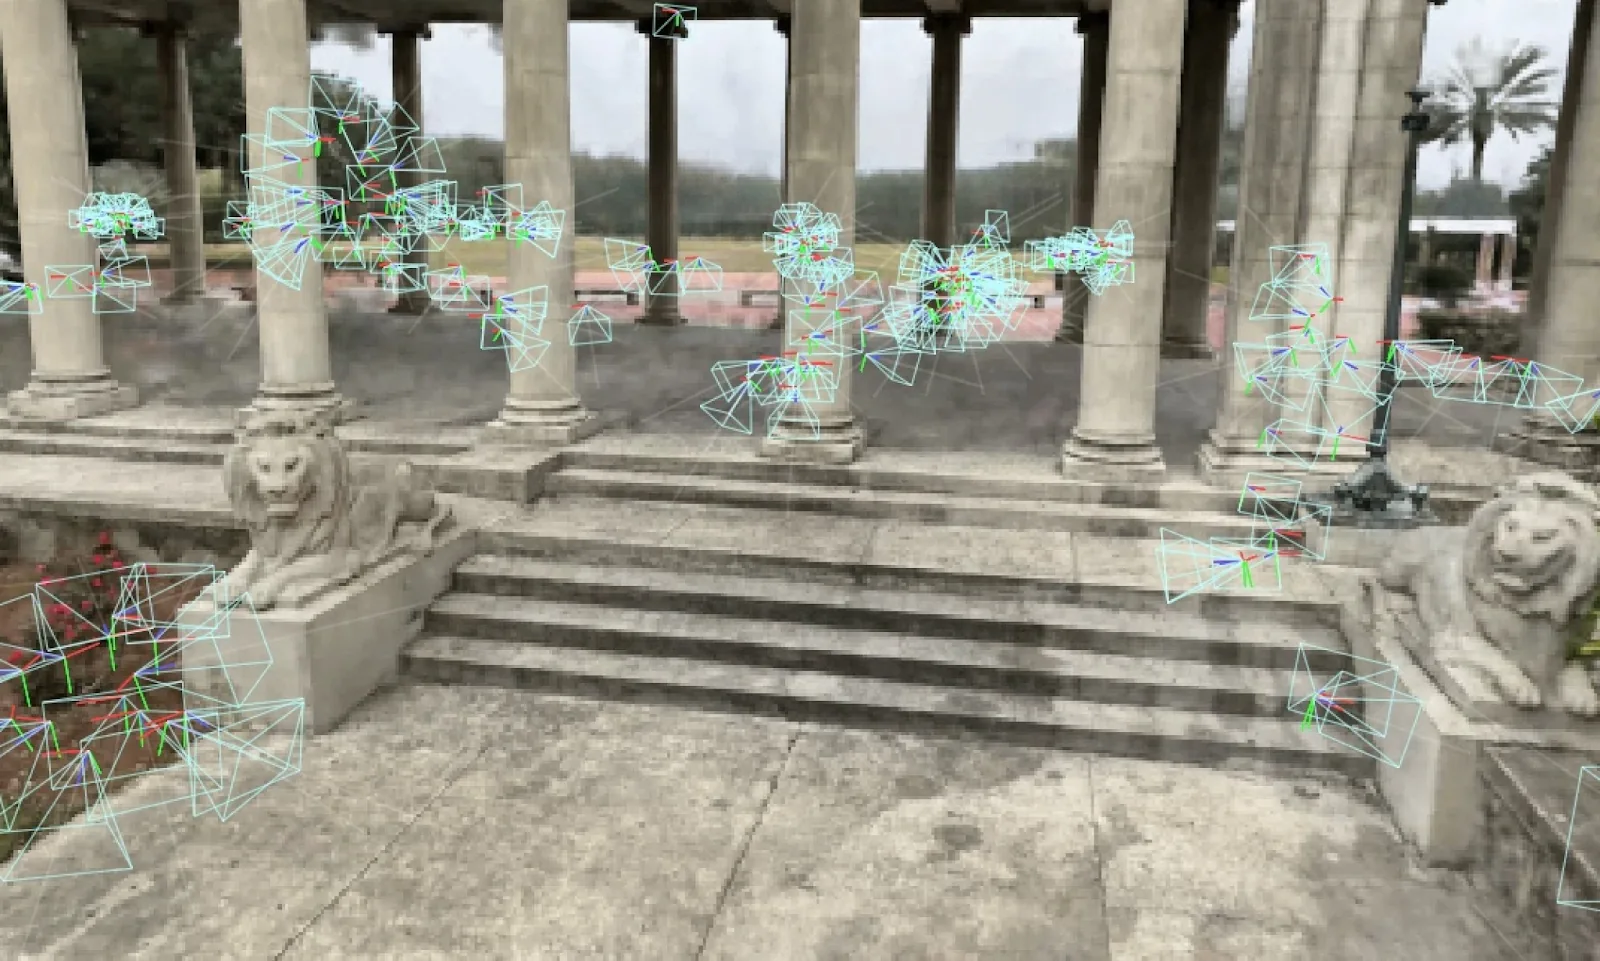
Rendering des NeRF der Hintergrundszene
Wie oben erwähnt, lag das Hintergrund-NeRF dank meines angepassten COLMAP-Setups bereits im selben Koordinatensystem wie die NeRFs der einzelnen Zeitschritte, sodass sich die verschiedenen Renderings beim Rendern von Kamerapfaden perfekt zusammensetzen:
Szenen-Komposit
Allerdings musste ich die dynamischen NeRFs mit einem Zuschneidevolumen und Transparenz rendern, damit nur die Personen gerendert wurden:
Zuschneidevolumen für den Vordergrund
Hinweise zur Szenenqualität
Einige Hinweise zu Qualitäts- und Rendering-Problemen, die während des Projekts auftraten.
Flackern
Ursprünglich habe ich jeden NeRF-Zeitschritt separat trainiert, aber beim Erstellen der Animation aus allen NeRFs gab es viele Flackerartefakte:
Zeitliches Flackern
Ich habe getestet, das trainierte Netz eines vorherigen Zeitschritts als Initialisierung für den folgenden Zeitschritt wiederzuverwenden (konkret, nach etwa 500 Schritten einen Snapshot zu speichern, der als Initialisierung für den nächsten Zeitschritt dient)
Das hat die Kontinuität der Lösung, auf die sich das Netz einpendelt, über die Zeitschritte hinweg eindeutig verbessert. Hätte ich mehr Kameras, wäre das meiner Meinung nach kein so großes Problem, da es weniger Spielraum für Mehrdeutigkeit in der Szene gibt.
Floater
Als Floater bezeichnete Artefakte entstehen, wenn die Ansichten während des Trainings mehrdeutig sind. Mehr Kameraansichten verringern das, aber in unserem Fall ist es bei der dynamischen Szene nicht einfach, mehr Kameras hinzuzufügen.
Das Anpassen der „Near Distance“ beim Training hat Floater eindeutig reduziert. Ich war kurz davor, eine Near Distance pro Kamera zu implementieren, um Floater weiter zu reduzieren.
Eine weitere Idee, die ich umsetzen wollte, waren maskierende Volumen oder Ebenen. Die grundlegende Intuition: „Ich weiß, dass hier leerer Raum ist, also platziere hier keine Floater / keine Dichte.“
Ein Beispiel ist der Boden bzw. die Bodenebene. Bei Szenen mit einer offensichtlichen Bodenebene wie dieser würde die Rekonstruktion des Bodens für neue Ansichten konsistenter wirken, wenn ich festlegen könnte, dass unter der Bodenebene keine Dichte erlaubt ist.
Dasselbe gilt für große Volumen leeren Raums: NeRF lernt oft Dichte in Bereichen, in denen sich leicht ein riesiger Würfel zeichnen ließe, um dort alle Gradienten „auf null zu setzen“.
Außerdem wollte ich eine Tiefenüberwachung (Depth Supervision) testen, um zu sehen, ob auch sie Floater reduziert.
Regularisierung
Regularisierung wurde in viele nachfolgende NeRF-Methoden aufgenommen, aber meines Wissens nicht in nennenswertem Umfang in das Instant-NGP-Repository. Mit mehr Zeit würde ich gern einige Techniken untersuchen, um das Netztraining in die richtige Richtung zu lenken.
- MiDas-Tiefenüberwachung aus monokularen Bildern
- Normalen-Konsistenz-Priors für glatte Oberflächen
Am Ende bedeutete die Verwendung der sauberen, mit vielen Ansichten trainierten Hintergrundszene zusammen mit den maskierten Personen, dass Floater kein großes Problem waren.
Wenn Sie nur wenige Kamerawinkel haben, könnten sich diese Ideen lohnen.
Farbangleichung
Einige Bilder, die mit verschiedenen Telefonen aufgenommen wurden, haben leicht unterschiedliche Farbtöne:
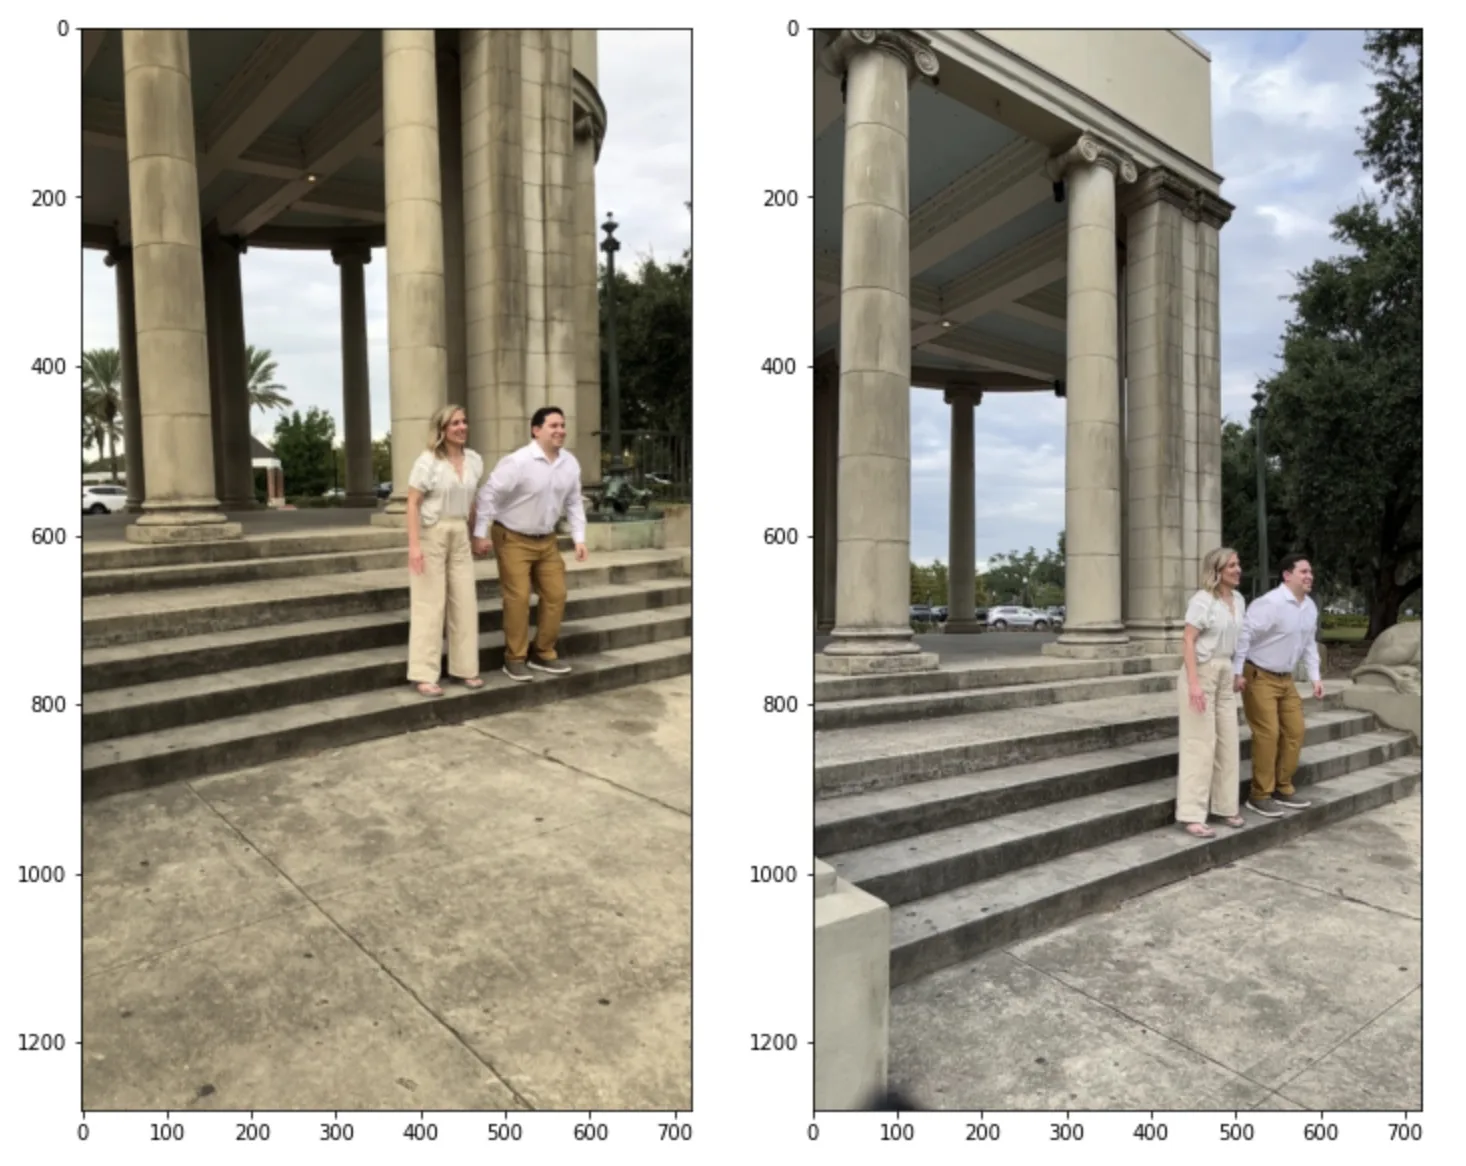
Abweichung der Farbtöne
Ein Kalibriermarker in den Bildern könnte es etwas leichter machen, dies automatisch zu lösen. Es gibt wahrscheinlich viele Möglichkeiten, das Problem zu lösen oder zu verbessern. Vielleicht könnten wir auf der Aufnahmeseite Weißabgleich / Belichtung über alle Telefone hinweg synchronisieren. Andere Techniken zur Lösung des Problems habe ich nicht untersucht.
Eine Idee war, dieselben Punkte über mehrere Bilder hinweg auszuwählen und dann eine Farbtransformation zu berechnen, die die Farbunterschiede zwischen den Bildern verringert.
Ein Problem könnte sein, in den verschiedenen Bildern nicht genau dasselbe Pixel zu treffen.
SIFT-Features aus COLMAP könnten helfen, aber da SIFT-Features oft auf Kanten / bei hohem Kontrast liegen, könnten wir für denselben 3D-Punkt, der in verschiedene Bilder projiziert wird, am Ende unterschiedliche Farben auswählen.
Optimaler Transport
Das Erste und Einzige, was ich zur Lösung dieses Problems versucht habe, war optimaler Transport von Farbhistogrammen.
Im Web habe ich einige schöne Codebeispiele aus der Bibliothek Python Optimal Transport / POT gefunden:
Meine einzige halbwegs clevere Änderung bestand darin, die Personen im Bild stärker abzutasten, da sie mir am wichtigsten sind, sie aber auch in jeder Aufnahme vorkommen.
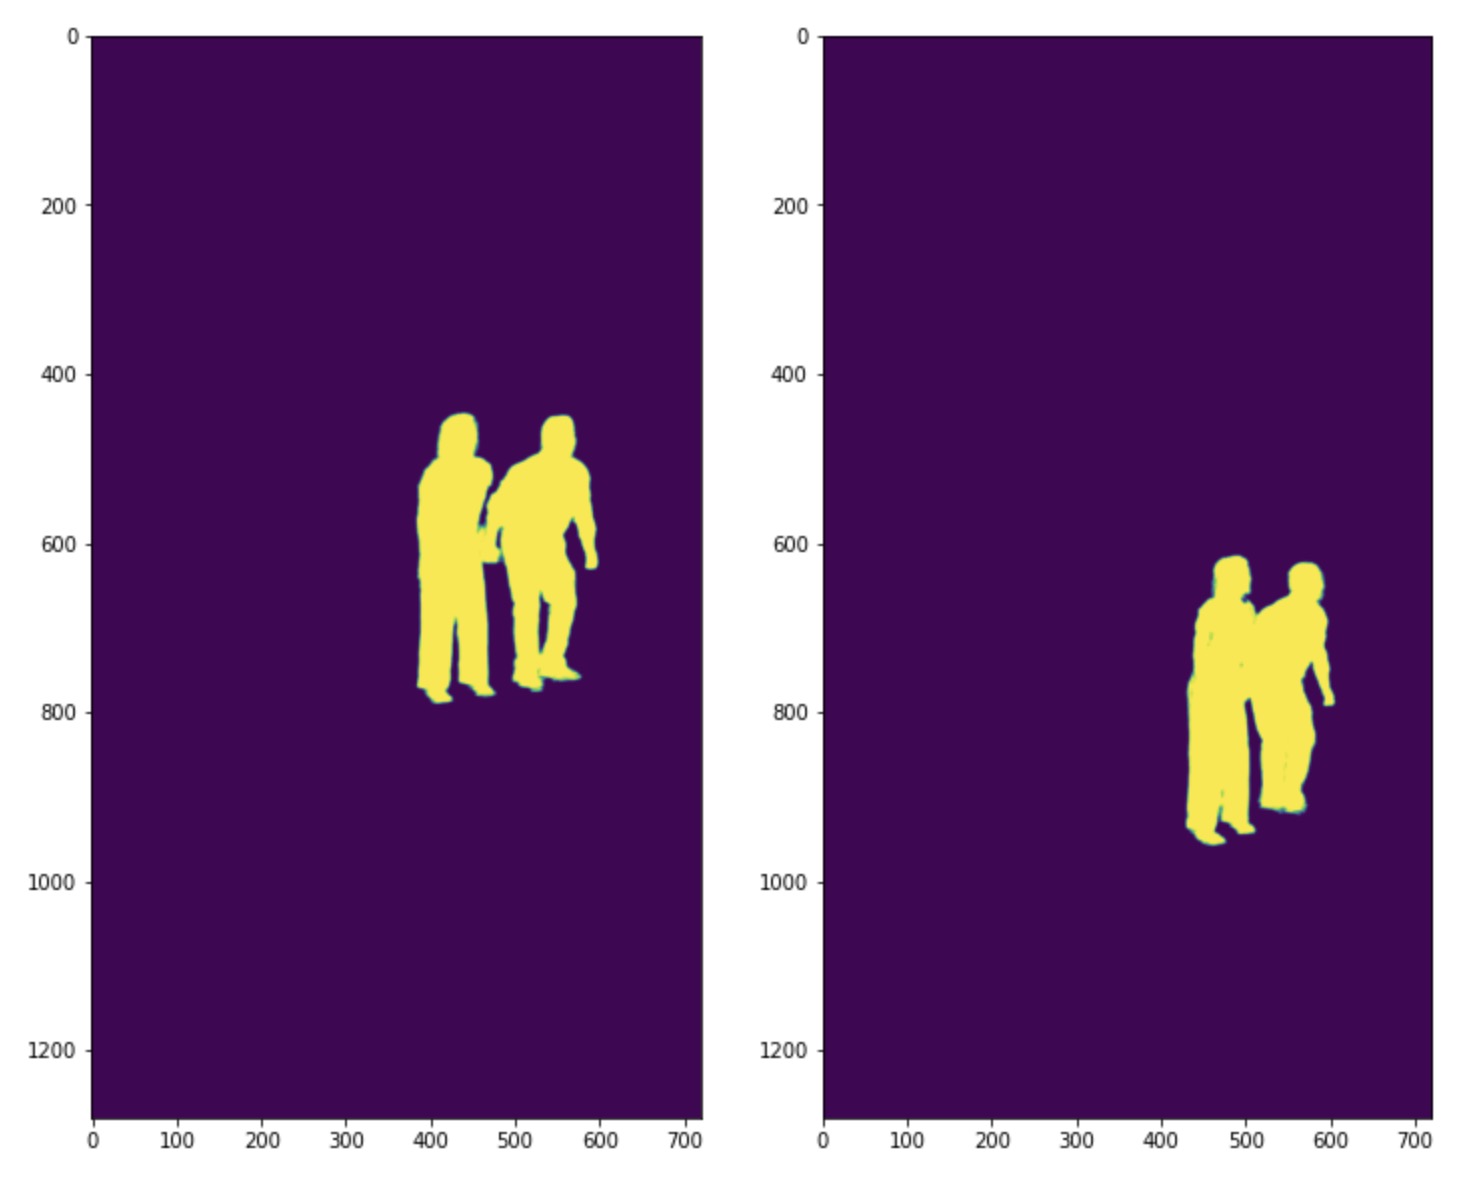
Personensegmentierungsmasken
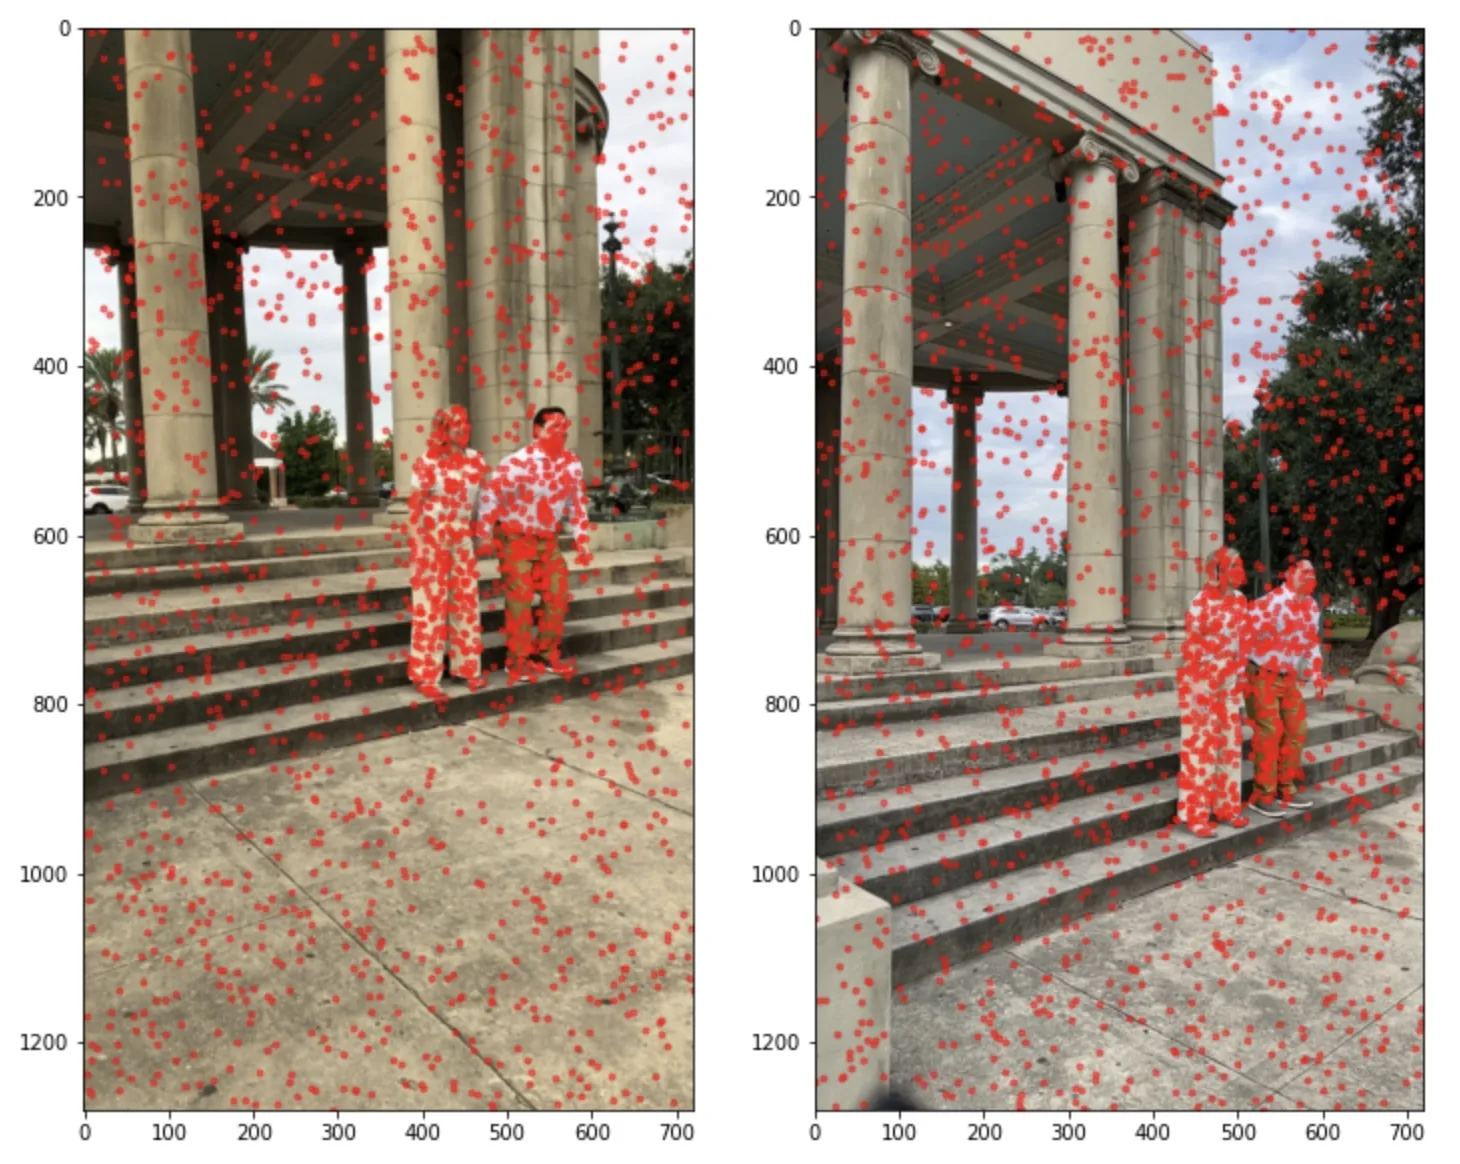
Abtastung der Personensegmentierung
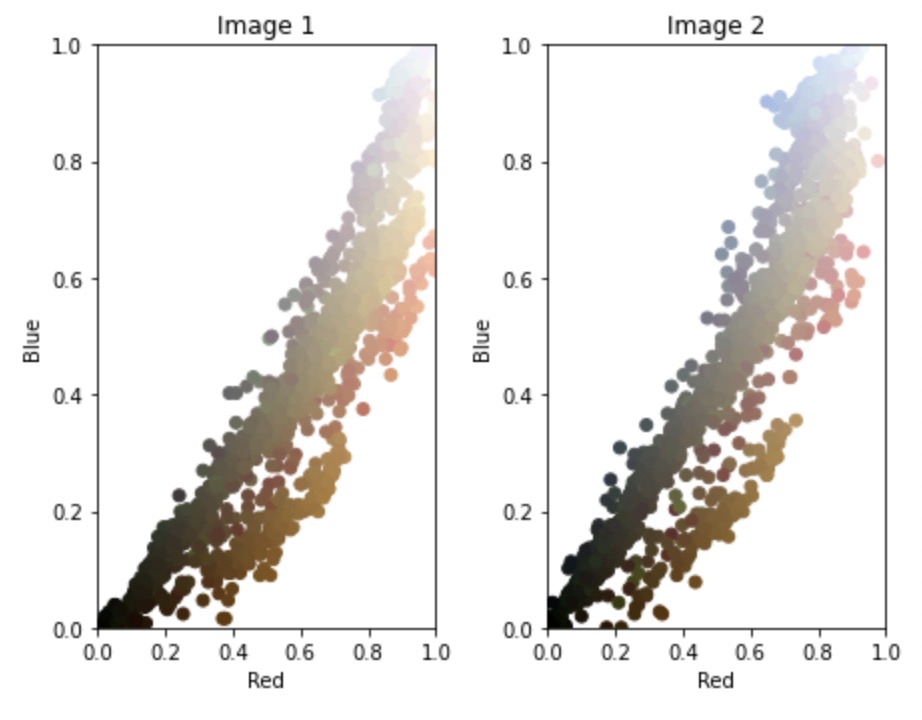
Farbdiagramme
Es ist eine subtile Änderung, aber ich glaube, sie macht einen Unterschied bei der NeRF-Rekonstruktion:
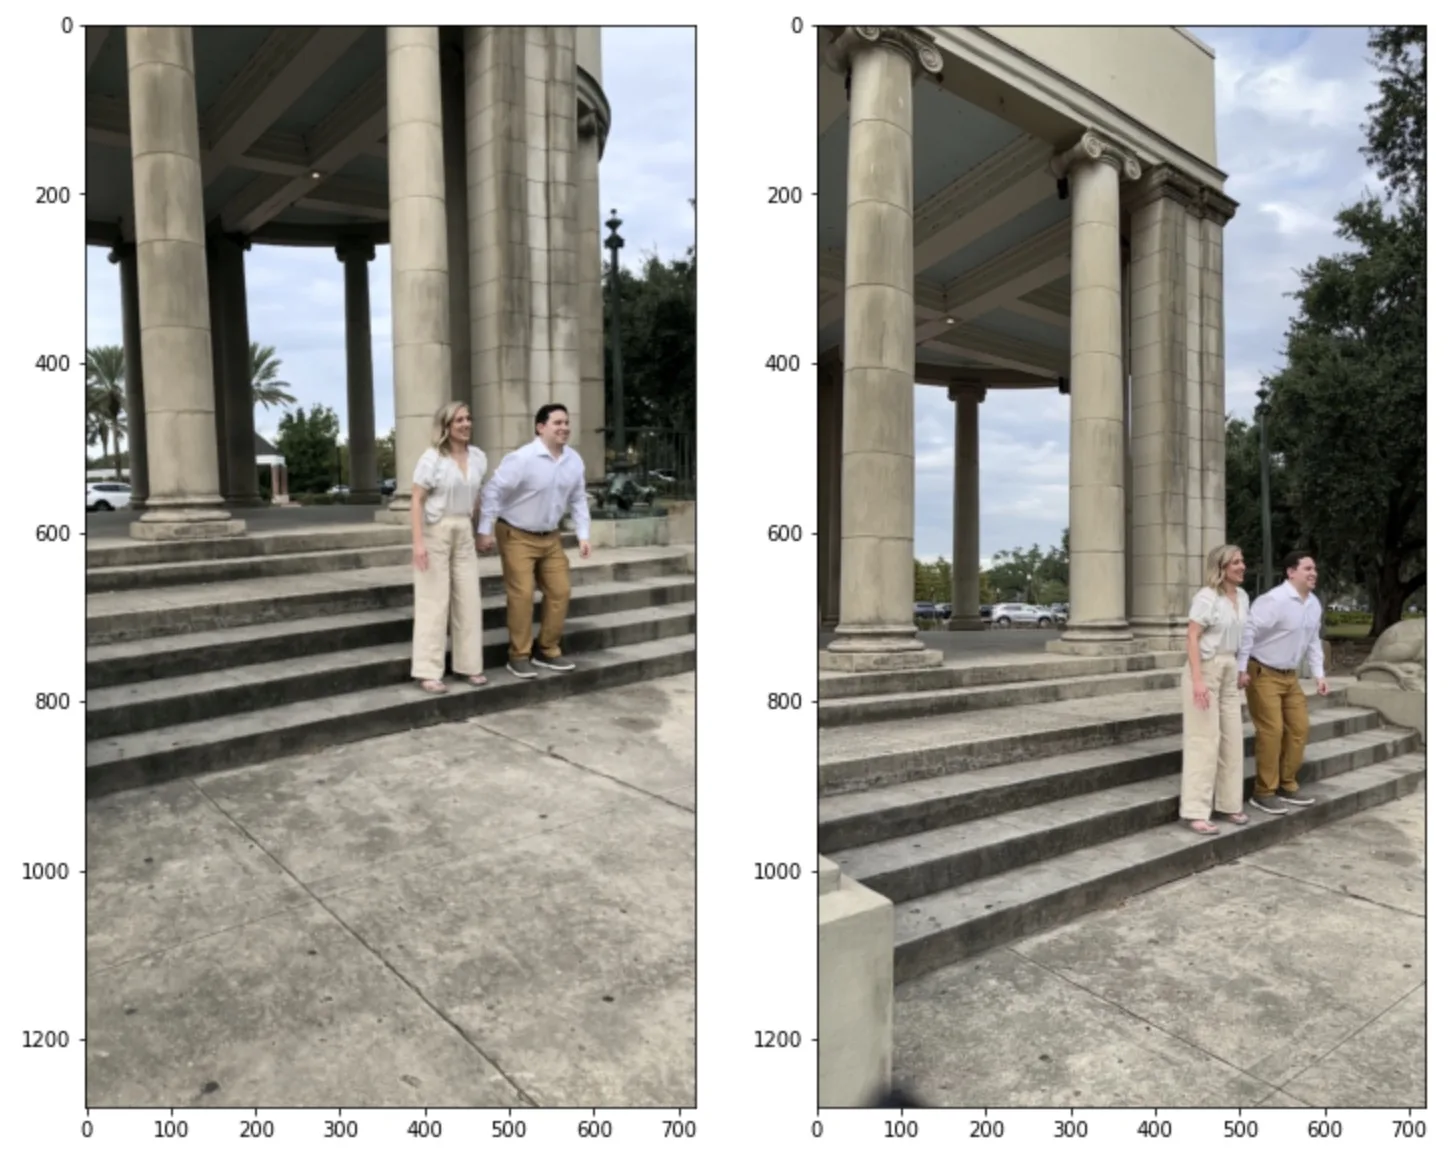
Angeglichene Bilder
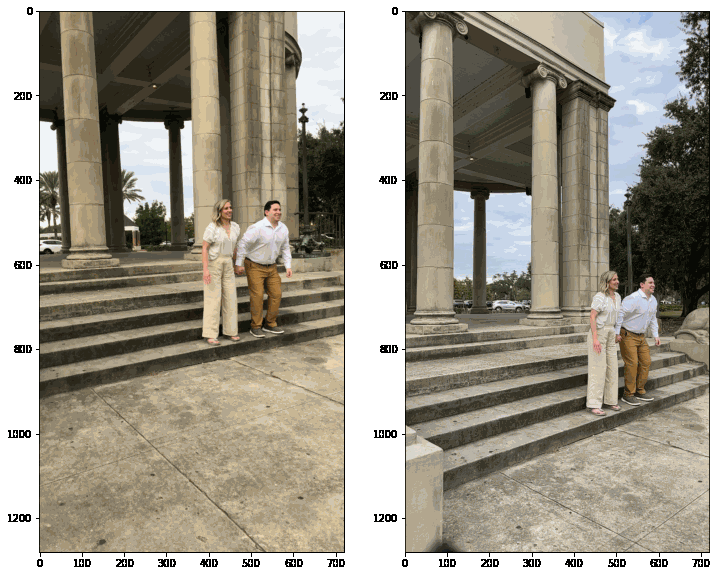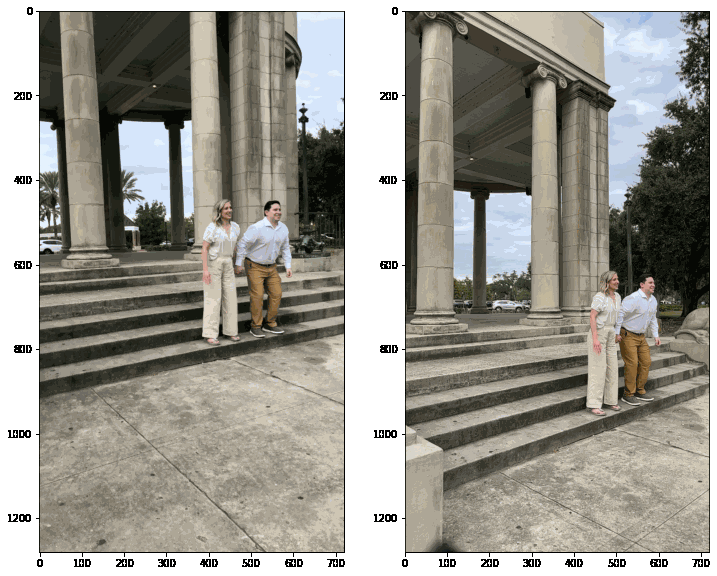
Animation der angeglichenen Bilder
Code
Wenn Sie daran interessiert sind, darauf aufzubauen, schreiben Sie uns eine E-Mail
Arbeiten Sie mit uns
Wenn Sie Hilfe bei der Nutzung von NeRF für ein Projekt brauchen, schreiben Sie uns eine E-Mail.
Zusammenarbeit mit Laan Labs
Gaussian Splatting & Radiance Fields
Fotorealistische 3D-Erfassung aus Fotos und Video, vom Erfassungsprotokoll über das Training bis zur Auslieferung im Browser oder auf einem Gerät.
Diesen Artikel herunterladen
Markdown-Quelltext zum Offline-Lesen herunterladen