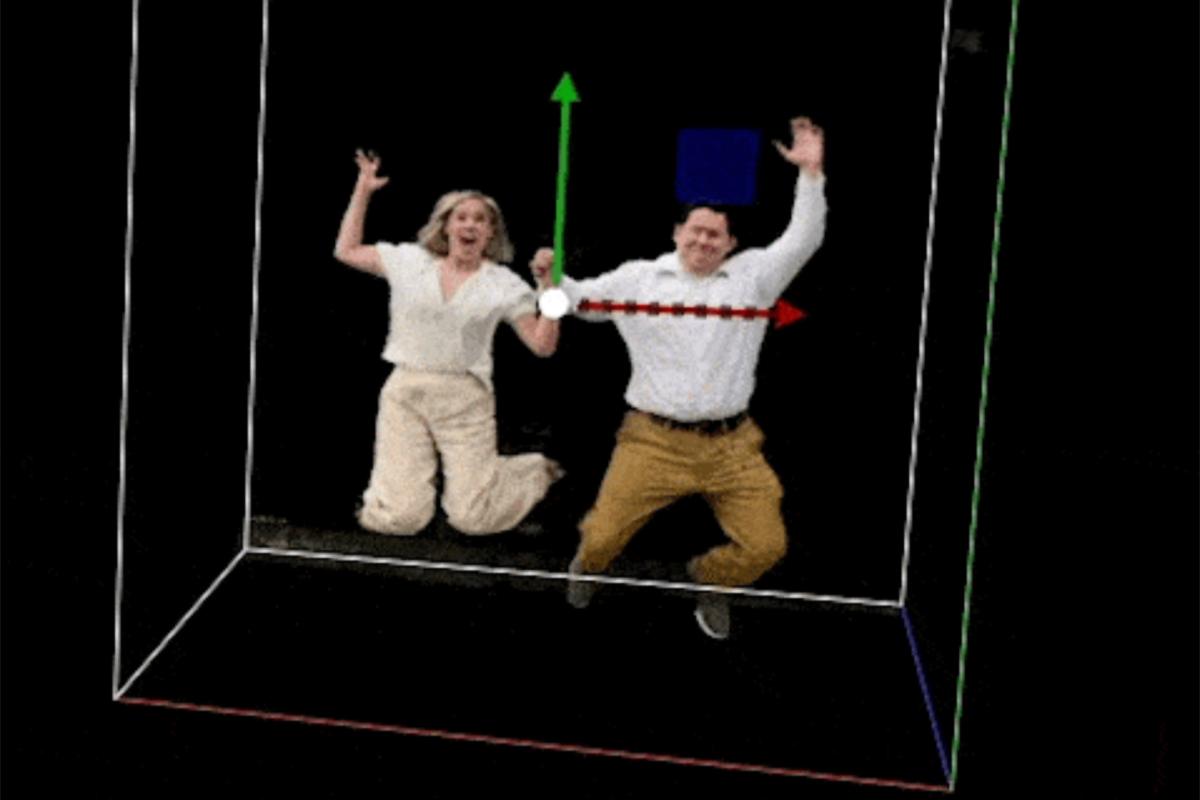
NeRF로 만드는 슬로 모션 "불릿 타임"

요약
NeRF와 iPhone 15대로 볼류메트릭 3D "불릿 타임" 비디오를 녹화했습니다
NeRF 불릿 타임
전체 영상
개요
지난달에 사촌이 결혼했고, 그 기념으로 가족 사진 촬영을 했습니다. 저는 이 기회에 한동안 만지작거리던 아이디어를 다시 해 보기로 했습니다. 기본 아이디어는 친구들을 모아 휴대폰으로 여러 각도에서 한 장면을 캡처하는 것이었습니다. 결과물은 매트릭스에 나오는 것과 같은 프리즈 프레임, 즉 불릿 타임 비디오입니다.
몇 년 전 이 아이디어를 처음 시도했을 때는 NeRF가 없었기 때문에 고품질 "뷰 합성"을 할 좋은 방법이 없었습니다. 여기서 '뷰 합성'이란 장면을 원래 캡처한 시점과 다른 시점에서 본 이미지를 렌더링하는 것을 뜻합니다.
NeRF
NeRF, 즉 Neural Radiance Field는 뷰 합성과 3D 재구성을 위한 놀라운 새 방법으로 빠르게 등장했습니다.
Neural Radiance Field는 딥러닝으로 3D 장면을 표현하고 렌더링하는 방법입니다. NeRF의 핵심 아이디어는 신경망으로 3D 공간의 각 지점에서 장면의 radiance를 예측하는 것입니다. 한 장면의 입력 이미지 집합이 주어지면 신경망은 장면의 3D 구조뿐 아니라 각 지점의 표면 반사율과 조명도 예측하도록 학습합니다. 결과로 얻은 표현은 3D 공간의 어느 지점에서든 평가할 수 있는 연속 함수이며, 어떤 시점에서든 장면을 매우 사실적으로 렌더링할 수 있습니다. NeRF는 복잡한 3D 장면의 고품질 포토리얼리스틱 렌더링을 만들 수 있으며, 컴퓨터 그래픽스 분야를 혁신할 잠재력이 있습니다.
이 분야는 매우 빠르게 움직여서 새로운 접근법과 개선 사항이 거의 매일 나오고 있습니다.
NeRF에 대해서는 여기에서 더 읽어 보시거나, 원 논문은 여기에서 보시거나, YouTube에서 멋진 NeRF 렌더링을 감상해 보세요.
2021년 NVIDIA는 이미지나 비디오로 NeRF를 빠르게 만드는 오픈 소스 툴킷 Instant NGP를 공개했습니다. Instant NGP는 NeRF 학습 시간을 며칠에서 몇 분으로 줄였습니다.
NeRF를 이용한 불릿 타임은 전에도 시도된 적이 있으며, 새로운 NeRF 확장 기법은 기존 NeRF 모델에 시간 성분을 더해 동적 장면을 표현할 수 있습니다. (DNerf 같은 'Dynamic Nerf' 참조)
재미 삼아 빠르게 진행한 사이드 프로젝트였기에 더 새로운 접근법은 시험해 보지 못했고, Instant NGP가 주는 사용 편의성과 빠른 학습 시간을 택했습니다.
Nerfstudio도 살펴볼 만한 또 다른 NeRF 학습 툴킷입니다. 동적 장면용 "DNerf"까지 지원하지만 아직 시험해 볼 기회는 없었습니다.
NeRF 연구의 속도가 워낙 빨라서 몇 달 뒤에는 이런 작업을 위한 더 나은 / 더 빠른 방법이 나올 가능성이 높습니다.
비디오 캡처
이 프로젝트의 첫 번째 요건은 장면을 여러 각도에서 찍은 슬로 모션 비디오를 캡처하는 것입니다. 최신 iPhone은 1920x1080 해상도에서 초당 240프레임으로 비디오를 촬영할 수 있으며, 이 정도면 NeRF를 학습시키기에 충분합니다.
테스트용 기기를 모두 모으고 가족들에게도 부탁해서 iPhone 15대를 구했습니다. (일반적으로 NeRF 장면에는 이미지 40~100장 정도가 사용되지만요.)
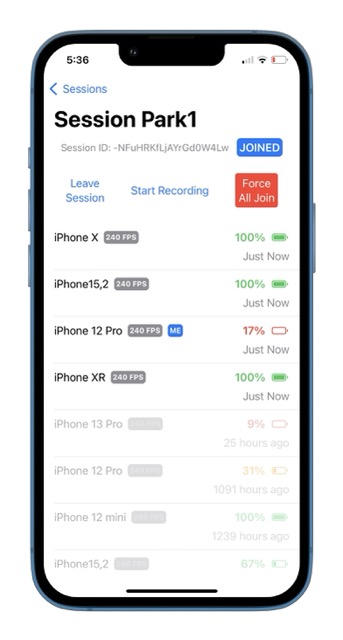
그다음 모든 휴대폰에서 동시에 녹화를 시작할 수 있게 해 주는 간단한 Firebase Realtime database 앱을 만들었습니다. 비디오가 캡처되면 google cloud storage로 자동 업로드됩니다.
한 휴대폰에서 녹화 버튼을 누르면 연결된 모든 기기에서 녹화가 시작됩니다.
휴대폰 간 동기화 녹화
이 앱은 각 기기의 배터리 잔량과 비디오 업로드 상태도 보여 줍니다.
iPhone 삼각대
저렴한 목재로 간단한 삼각대를 만들고, 나머지 휴대폰은 가족 몇 명에게 들고 있어 달라고 부탁했습니다.
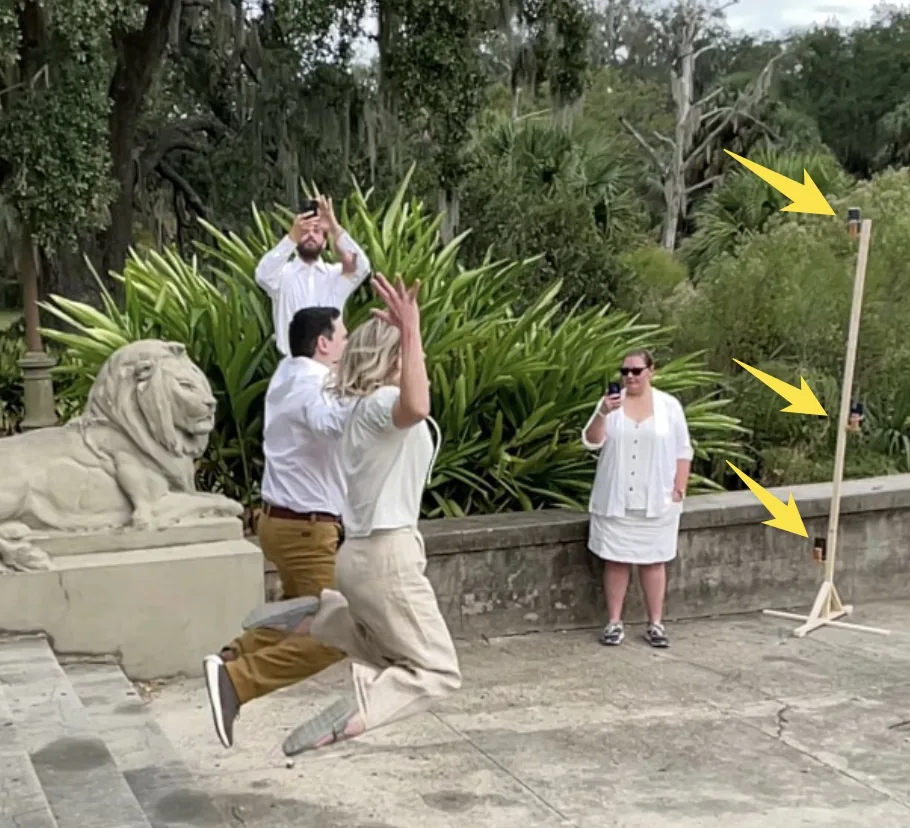
삼각대를 사용한 캡처 설정
다음은 여러 휴대폰에서 캡처한 이미지 일부입니다.
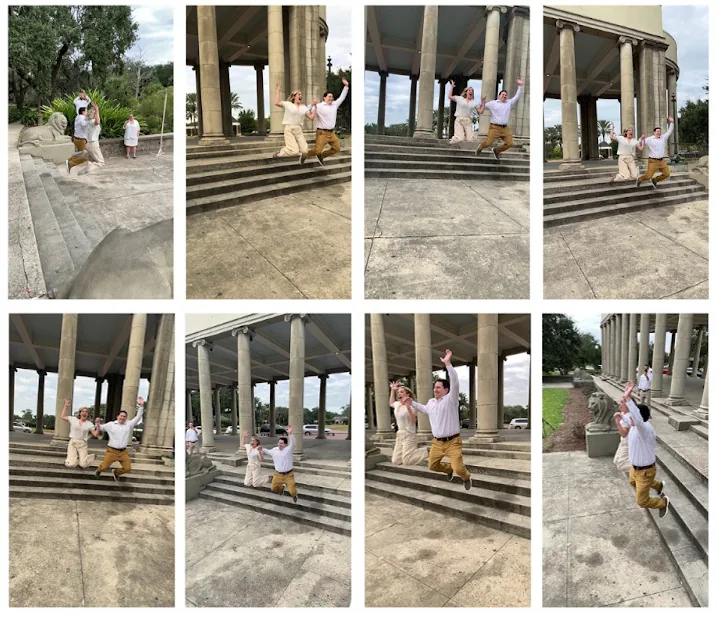
샘플 이미지
앱은 녹화할 때 초점과 노출을 고정했지만 그 값을 휴대폰 간에 동기화하지는 않았으므로, 이미지에서 색감 차이를 볼 수 있습니다. 이에 대해서는 아래에서 더 이야기하겠습니다.
장면을 설정하고 캡처할 수 있는 시간은 10분 정도로 꽤 짧았습니다. 시간이 더 있었다면 어떤 방식이 가장 좋은지 여러 카메라 구성을 시험해 보았을 것입니다.
비디오 시간 동기화
모든 비디오를 캡처한 뒤에는 시간을 동기화해야 합니다.
개발자로서 한 번만 할 거라면 수동으로 동기화하는 편이 빨랐겠지만, 이 과정을 자동화하고 싶었습니다.
결국 두 비디오 사이의 최적 시간 오프셋을 찾기 위해 오디오 스트림에 상호상관을 적용하는 작은 python 스크립트를 작성했습니다.
더 견고하게 만들려고 녹화를 시작할 때 서로 부딪쳐 소리를 내는 금속 막대 두 개를 가져갔습니다.
동기화되지 않은 두 비디오의 오디오 파형:
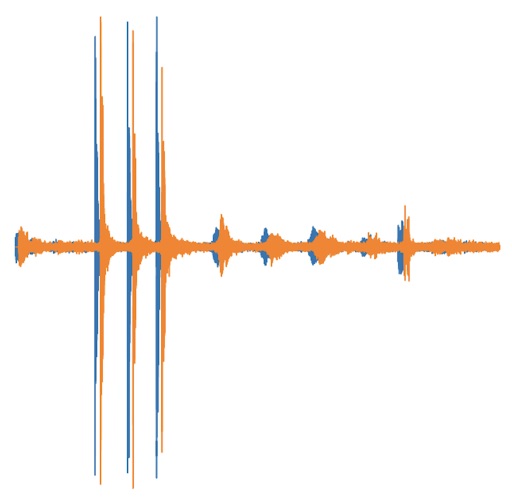
오디오 정렬
두 신호가 최대로 정렬되는 지점에서 상호상관이 뚜렷한 피크를 보입니다.
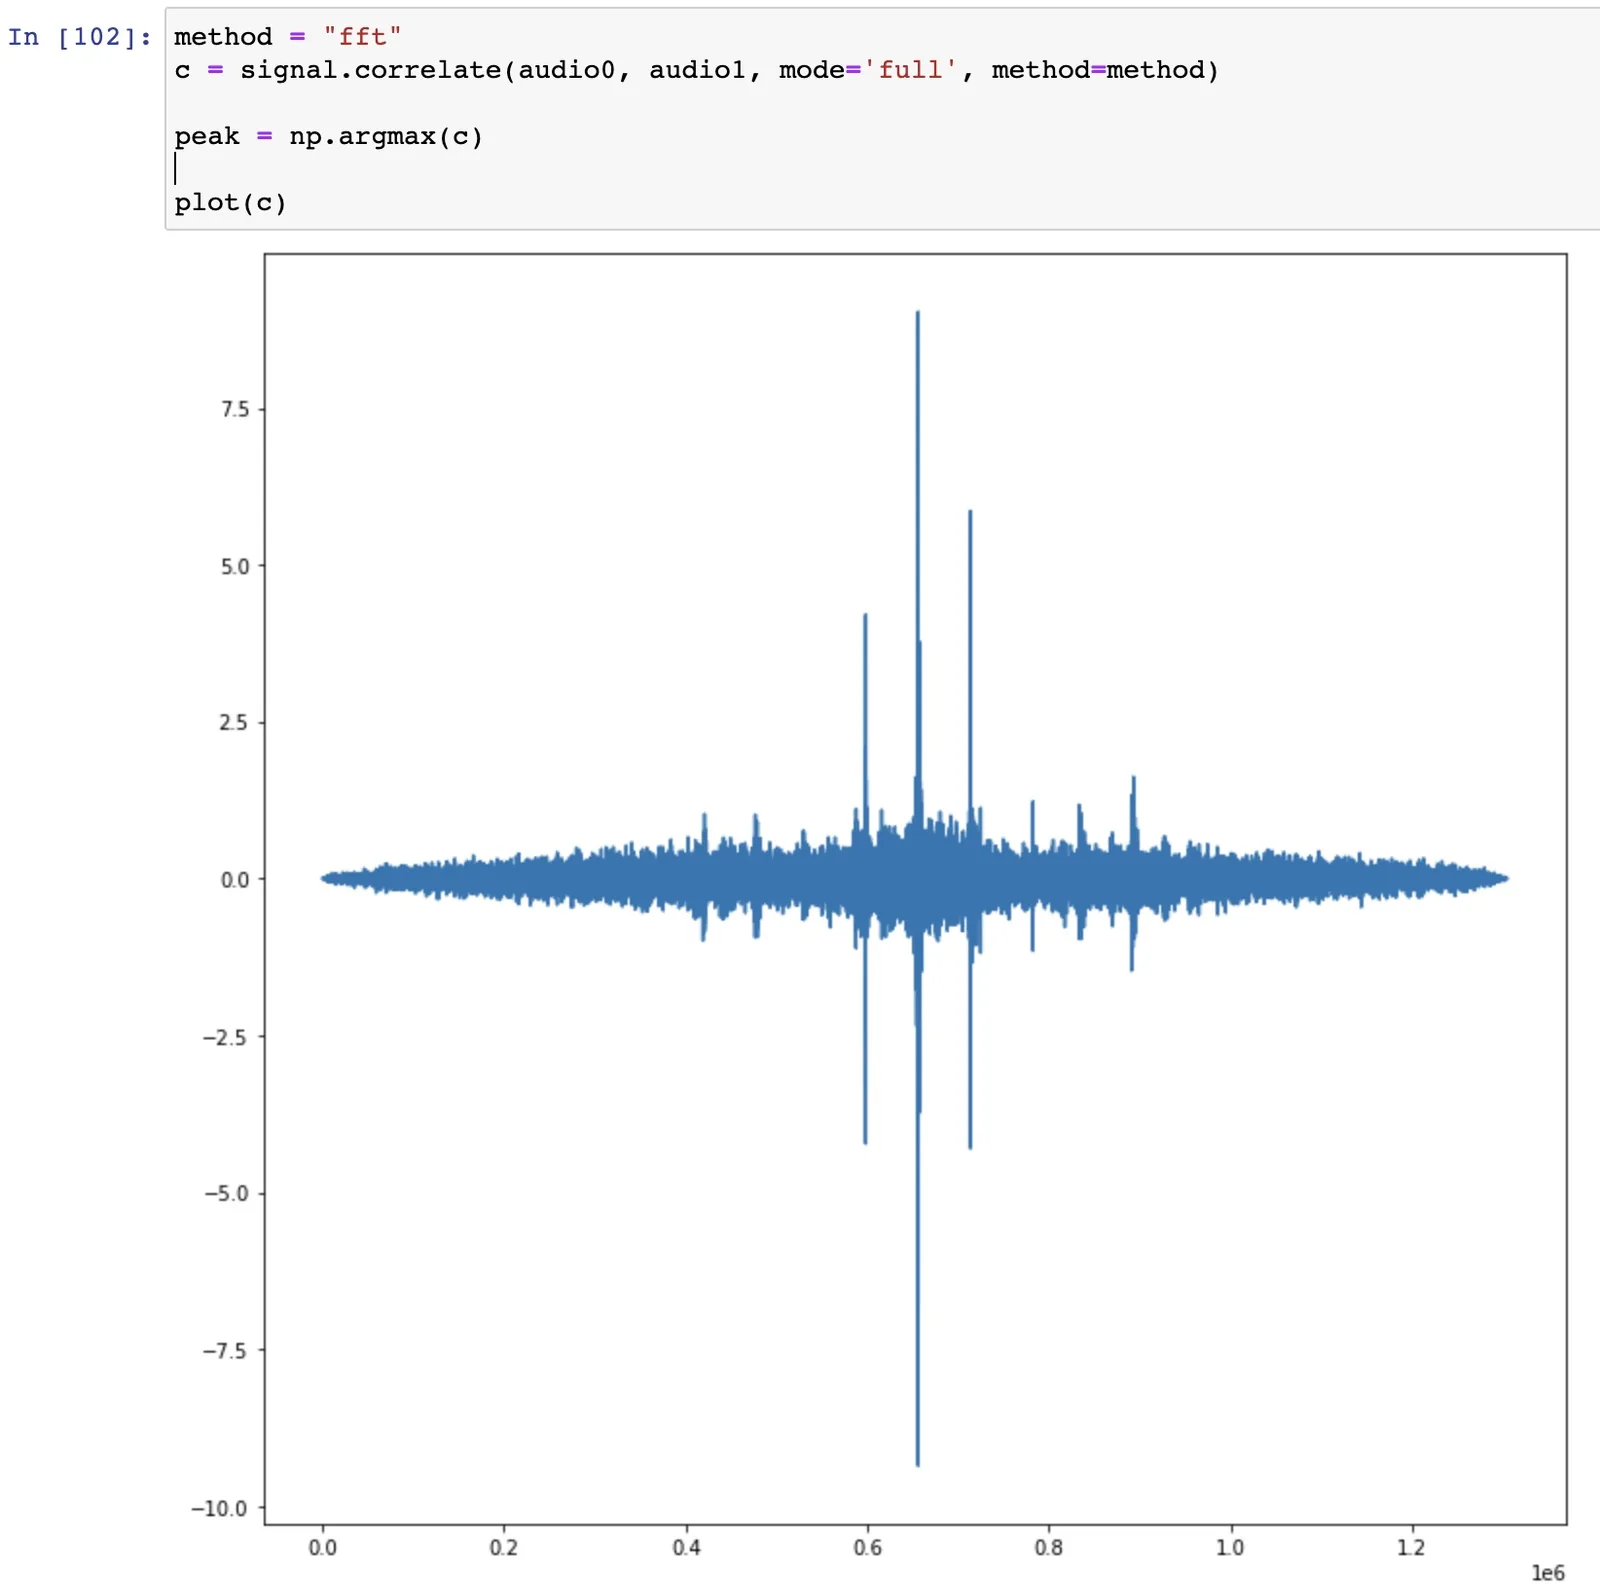
상호상관
비디오를 모두 같은 전역 시간에 맞춘 뒤, 15대의 휴대폰 모두에서 동기화된 프레임을 각각 약 200개씩, 총 3000장 정도 내보냈습니다.
NeRF 학습
다음 단계는 모든 데이터로 NeRF를 학습시키는 것입니다. 여기서 언급할 만한 문제가 몇 가지 생겼습니다.
타임스텝 결합
먼저 NeRF 학습 과정의 배경을 설명하겠습니다.
NeRF의 첫 단계는 장면의 모든 이미지에 대한 카메라 포즈를 계산하는 것입니다. 이를 위해 COLMAP을 사용합니다
불릿 타임의 경우 내보낸 비디오의 타임스텝 수만큼(즉 200개 타임스텝) "장면"이 있습니다.
따라서 비디오 전체에서 변하지 않는 전역 좌표계에 카메라 포즈가 정렬되도록 해야 합니다.
캡처하는 동안 모든 카메라가 움직이지 않는다면 간단합니다. 첫 프레임의 포즈를 계산해 이후 모든 프레임에 재사용하면 됩니다. 이번에는 몇몇 휴대폰을 사람이 들고 있었고, 그 휴대폰들은 촬영 중에 조금씩 움직였습니다.
카메라가 총 15대뿐이라 조금씩 움직인 휴대폰의 중요한 카메라 각도를 잃고 싶지 않았습니다. 그래서 움직이는 카메라에 대해 200개 타임스텝마다 카메라 포즈를 계산해야 했습니다.
선택할 수 있다면 다음에는 포즈 복원 과정이 크게 단순해지므로 삼각대에 올린 고정 카메라만 쓰겠습니다.
여러 접근법을 시도해 보았고, 결국 점진적 장면 재구성이 가능하도록 COLMAP을 약간 수정하기로 했습니다.
제가 택한 접근법은 카메라 포즈를 한 번 계산한 뒤 새 이미지가 추가되는 동안 고정해 두는 "배경" 장면에서 시작합니다. 배경 장면은 사람이 없는 상태로 촬영했으므로 휴대폰 한 대를 들고 자유롭게 돌아다니며 이미지를 많이 캡처할 수 있었습니다.
비디오의 각 "타임스텝"에는 녹화 중인 모든 카메라의 이미지 15장이 있습니다. 따라서 타임스텝마다 배경 장면에서 시작해, 배경 장면의 카메라 포즈를 고정한 채 새 이미지를 추가합니다. COLMAP은 "--Mapper.fix_existing_images" 옵션으로 기존의 정적 장면에 새 이미지를 추가하는 기능을 지원하지만, 안타깝게도 번들 조정 단계와 그 이후 정규화 단계에서 기준 카메라 포즈를 수정해 버립니다. 그래서 "fix_existing_images" 옵션을 지정하면 번들 조정 단계에서 기존 카메라 포즈를 고정하고 장면을 정규화하지 않도록 COLMAP을 수정했습니다.
배경 장면
다음으로 생긴 문제는 카메라가 15대뿐이라 학습된 NeRF가 피사체(사람들) 주변의 꽤 작은 3D 볼륨만 표현한다는 점이었습니다. 카메라를 움직여 장면의 다른 부분을 보여 주면 아티팩트 / 플로터가 많이 생겼습니다.
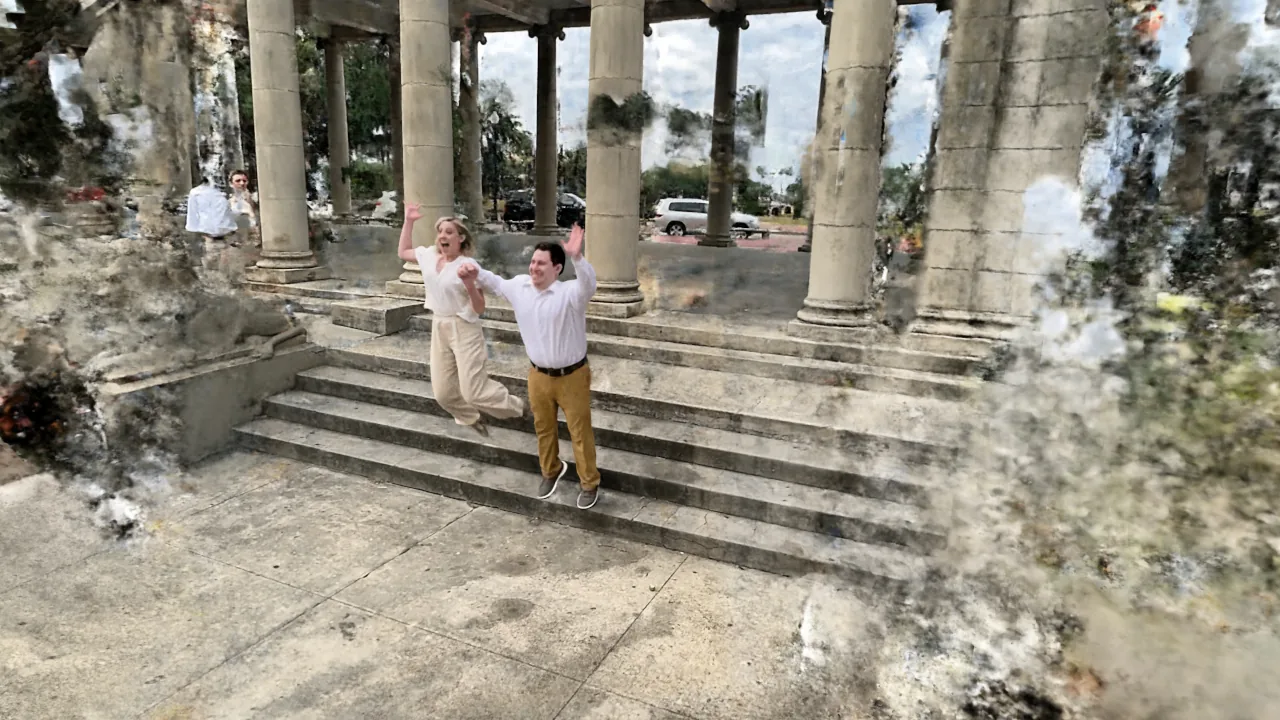
플로터가 있는 샘플 프레임
그래서 장면의 다른 부분을 렌더링하기 위해 사람이 없는 주변 영역의 이미지를 약 200장 캡처했습니다.
그다음 각 타임스텝의 NeRF와 합성할 별도의 NeRF를 학습시켰습니다.
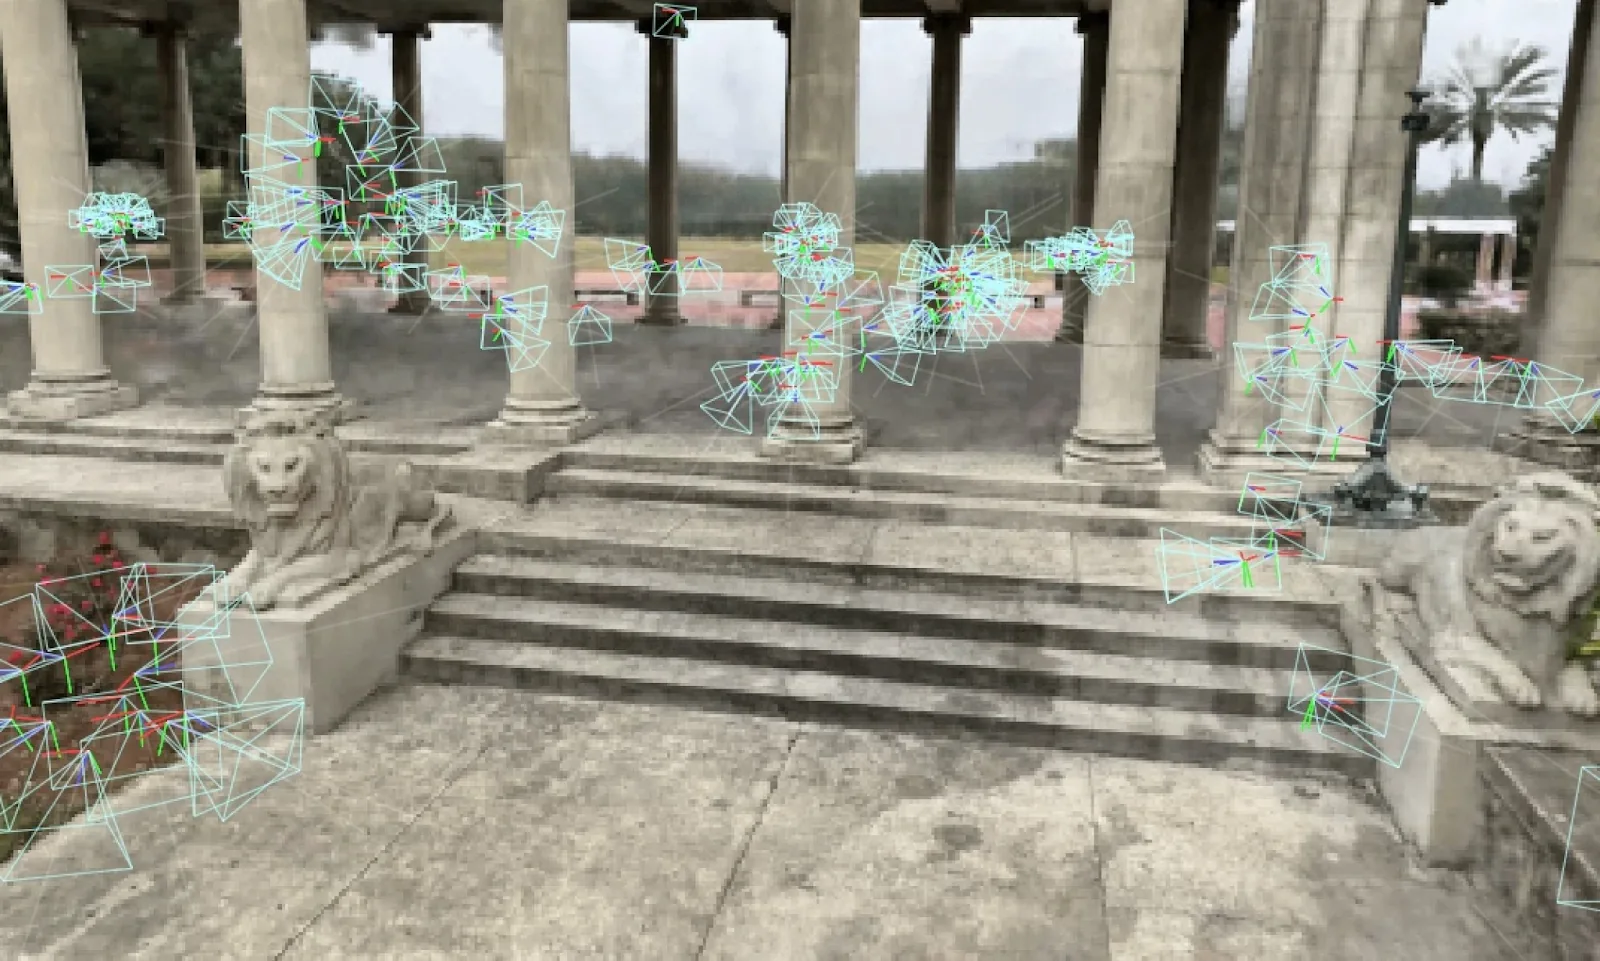
배경 장면 NeRF 렌더링
앞서 말했듯이 제가 수정한 COLMAP 설정 덕분에 배경 NeRF는 이미 각 타임스텝 NeRF와 같은 좌표계에 있었으므로, 카메라 경로를 렌더링할 때 서로 다른 렌더링이 완벽하게 합성됩니다.
장면 합성
다만 사람만 렌더링되도록 하려면 동적 NeRF를 크롭 볼륨과 투명도를 적용해 렌더링해야 했습니다.
전경 크롭 볼륨
장면 품질 메모
프로젝트 중에 생긴 품질 / 렌더링 문제에 관한 몇 가지 메모입니다.
깜빡임
처음에는 각 NeRF 타임스텝을 따로 학습시켰는데, 모든 NeRF로 애니메이션을 만들자 깜빡이는 아티팩트가 많이 생겼습니다.
시간에 따른 깜빡임
이전 타임스텝에서 학습한 네트워크를 다음 타임스텝의 초기값으로 재사용해 보았습니다(구체적으로는 약 500스텝 후의 스냅샷을 저장해 다음 타임스텝의 초기값으로 사용).
이렇게 하면 네트워크가 수렴하는 해가 타임스텝 사이에 비슷하게 유지되어 연속성이 확실히 좋아졌습니다. 카메라가 더 많았다면 장면에서 모호함이 줄어들므로 이 문제가 그렇게 크지는 않았을 것입니다.
플로터
플로터라고 부르는 아티팩트는 학습 중에 뷰에 모호함이 있을 때 생깁니다. 카메라 뷰를 늘리면 줄어들지만, 이번 경우에는 동적 장면에 카메라를 더 추가하기가 쉽지 않았습니다.
학습의 "근거리" 값을 조정하면 플로터가 확실히 줄었습니다. 플로터를 더 줄이기 위해 카메라별 근거리 값을 구현할 뻔했습니다.
고려했던 또 다른 아이디어는 마스킹 볼륨이나 평면을 만드는 것이었습니다. 기본 직관은 "여기는 빈 공간이니 이곳에 플로터나 밀도를 만들지 마라"입니다.
바닥 / 지면 평면이 한 예입니다. 이번 장면처럼 바닥 평면이 뚜렷한 장면에서는, 바닥 평면 아래에 밀도가 생기지 않도록 설정할 수 있다면 새로운 시점에서 지면의 재구성이 더 일관되게 보일 것입니다.
넓은 빈 공간도 마찬가지입니다. NeRF는 거대한 큐브 볼륨을 그려 그곳의 그래디언트를 "0으로 만들기" 쉬운 영역에서도 밀도를 학습하는 경우가 많습니다.
깊이 지도(depth supervision)를 적용하면 플로터도 줄어드는지 시험해 보고 싶기도 했습니다.
정규화
정규화는 후속 NeRF 방법들에 많이 반영되었지만, 제가 아는 한 Instant NGP 저장소에는 그다지 반영되어 있지 않습니다. 시간이 더 있다면 네트워크 학습을 올바른 방향으로 이끄는 몇 가지 기법을 탐구해 보고 싶습니다.
- MiDas 단안 깊이 지도(monocular depth supervision)
- 매끄러운 표면을 위한 노멀 일관성 prior
결국 많은 뷰로 학습한 깨끗한 배경 장면과 마스킹한 사람들을 함께 쓰자 플로터는 큰 문제가 아니었습니다.
카메라 각도가 제한적이라면 이런 아이디어를 탐구해 볼 만할 수 있습니다.
색상 매칭
서로 다른 휴대폰에서 캡처한 일부 프레임은 색조가 조금씩 다릅니다.
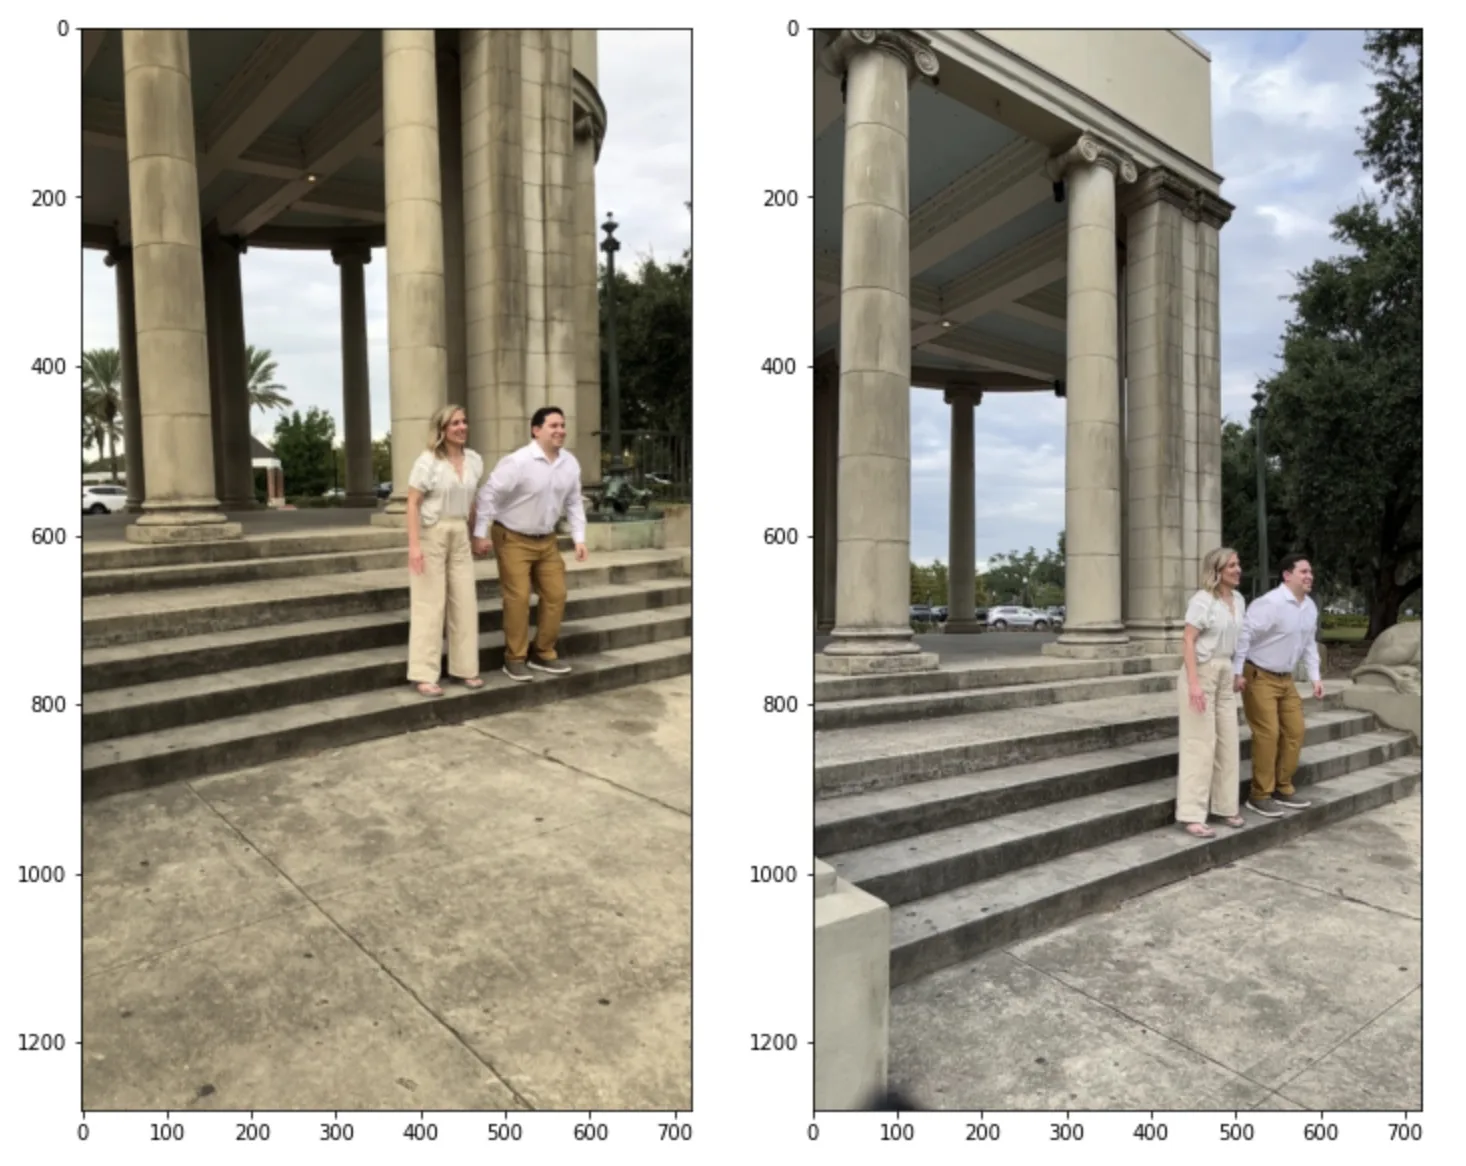
색조 불일치
이미지에 캘리브레이션 마커를 넣으면 이를 자동으로 해결하기가 조금 더 쉬울 수 있습니다. 이 문제를 해결하거나 개선하는 방법은 아마 아주 많을 것입니다. 캡처 단계에서 모든 휴대폰의 화이트 밸런스와 노출을 동기화할 수도 있습니다. 이 문제를 해결하는 다른 기법은 탐구하지 않았습니다.
한 가지 아이디어는 이미지들에서 같은 지점을 선택한 다음, 이미지 간 색 차이를 줄이는 색 변환 연산을 구하는 것이었습니다.
문제는 서로 다른 이미지에서 정확히 같은 픽셀을 짚지 못할 수 있다는 점입니다.
COLMAP의 SIFT 특징점을 쓰면 도움이 될 수도 있지만, SIFT 특징점은 대개 가장자리나 대비가 큰 곳에 위치하므로 서로 다른 이미지에 투영된 "같은" 3D 지점에서 서로 다른 색을 고르게 될 수 있습니다.
최적 수송
이 문제를 해결하려고 처음이자 유일하게 시도한 것은 색상 히스토그램의 최적 수송(optimal transport)이었습니다.
Python Optimal Transport / POT 라이브러리에서 좋은 코드 예제를 웹에서 찾았습니다.
제가 한 약간의 영리한 수정은 이미지의 사람에 더 많이 샘플링하도록 한 것입니다. 제가 가장 신경 쓰는 대상인 데다 사람은 모든 컷에 들어 있기 때문입니다.
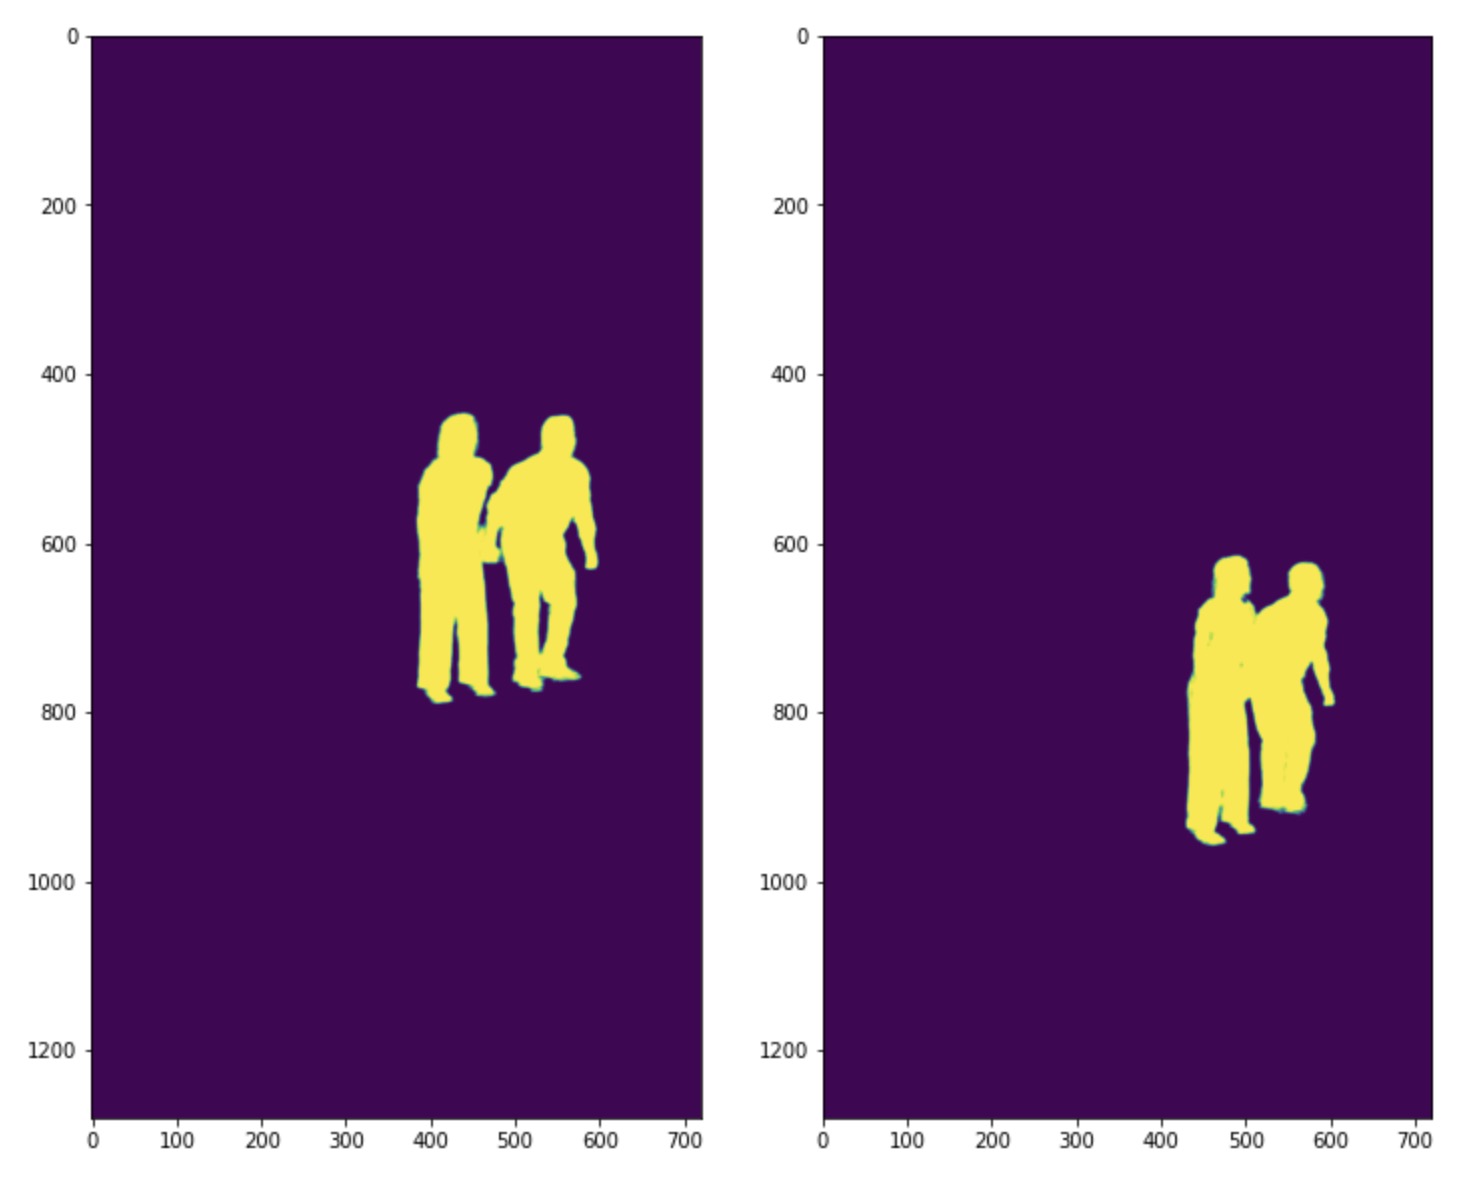
인물 분할 마스크
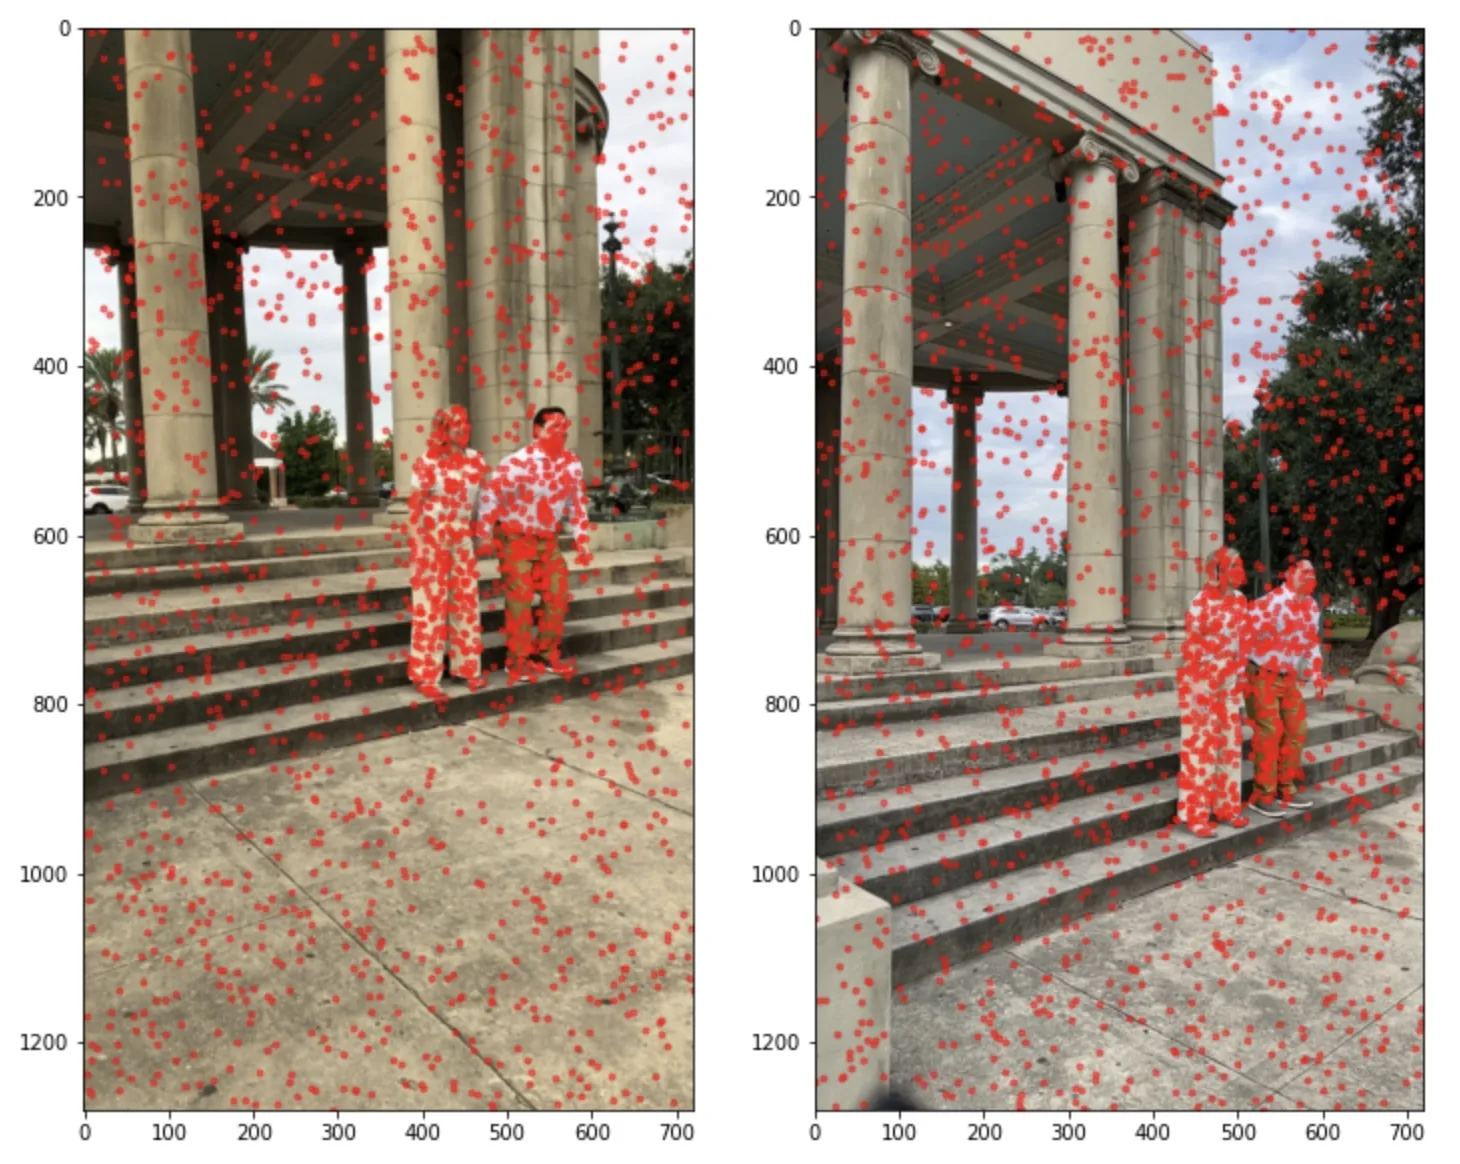
인물 분할 샘플링
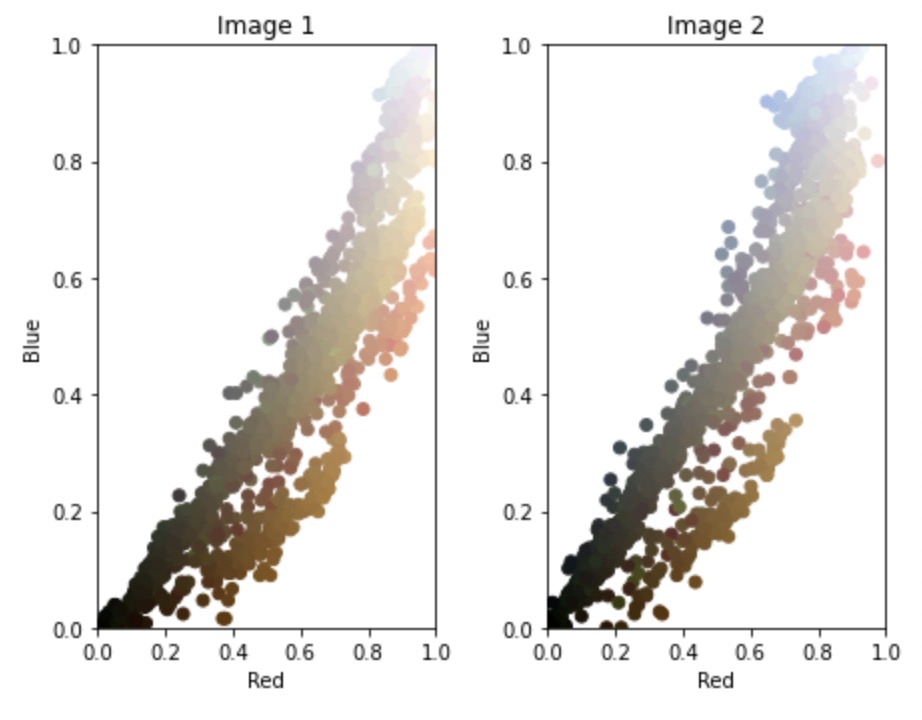
색상 플롯
미묘한 변화지만 NeRF 재구성에서는 차이를 만든다고 생각합니다.
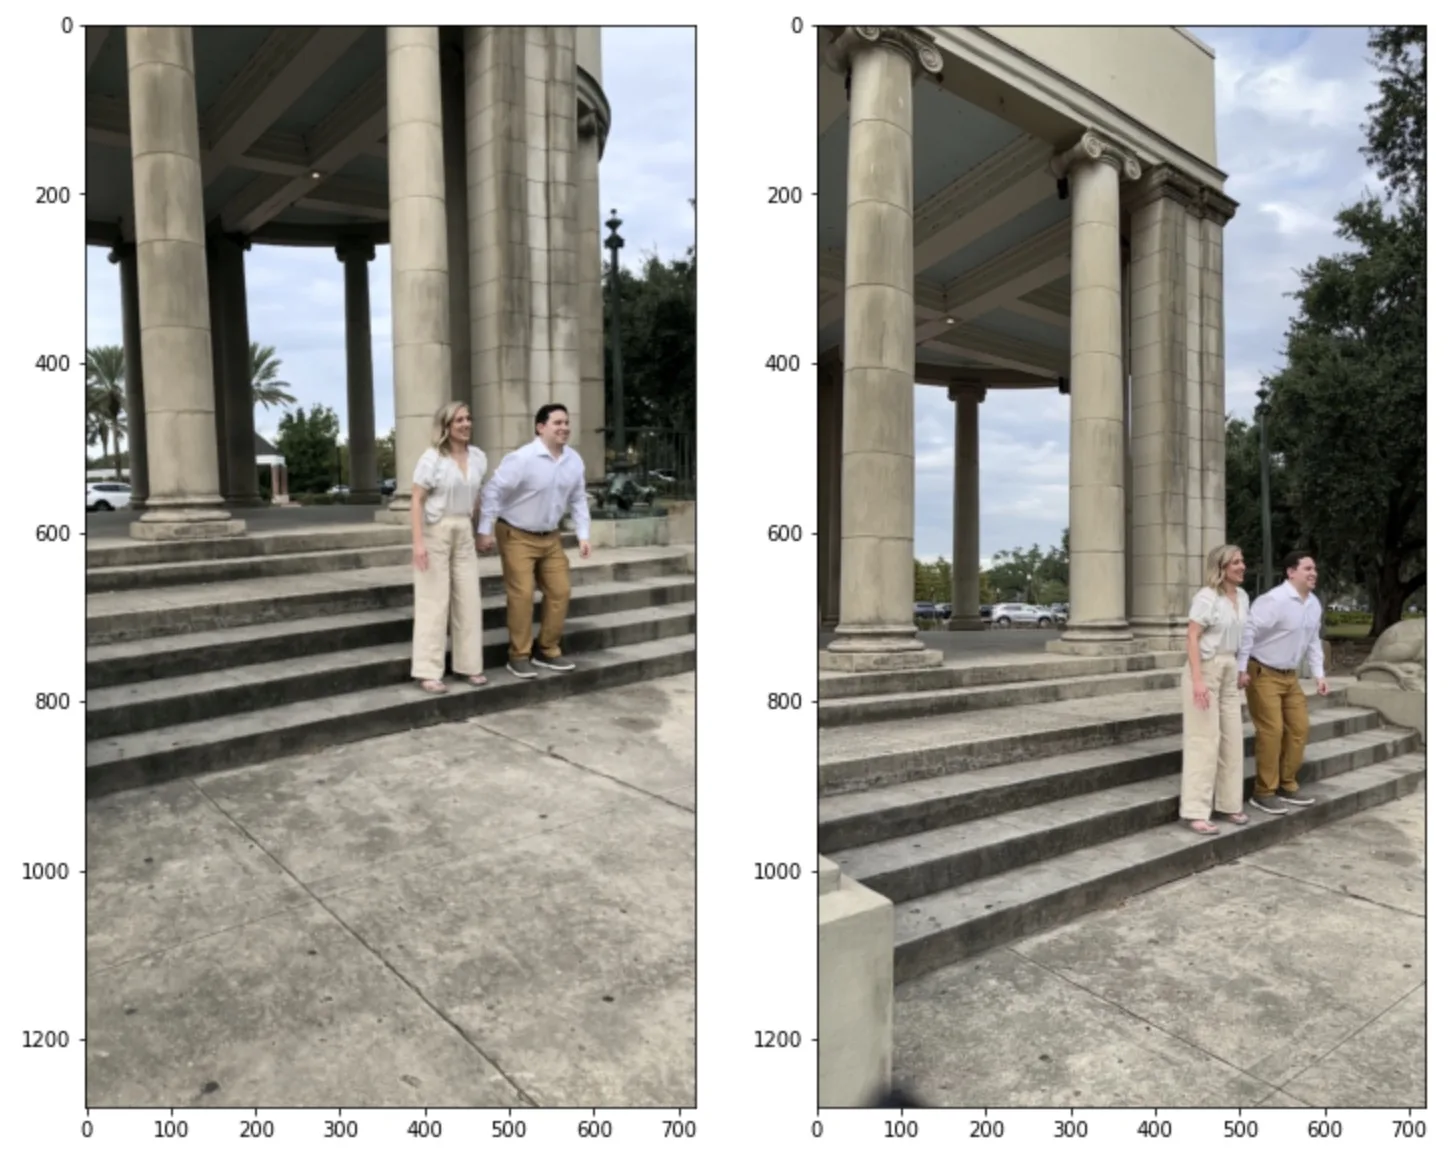
매칭된 이미지
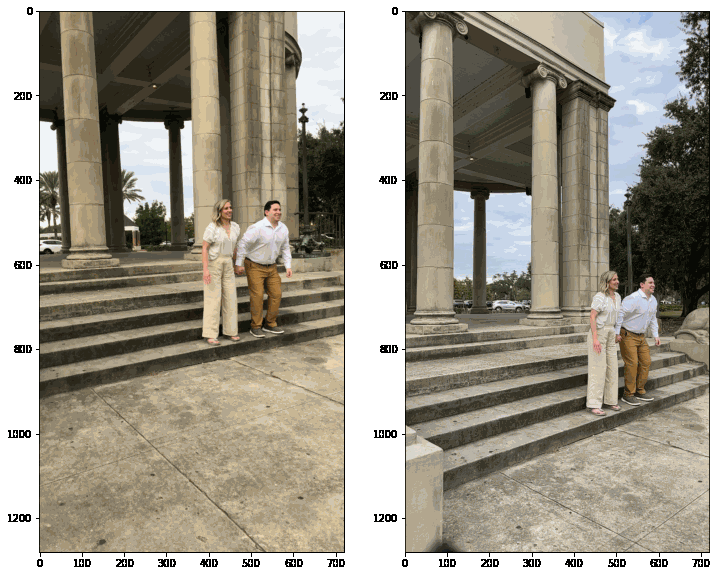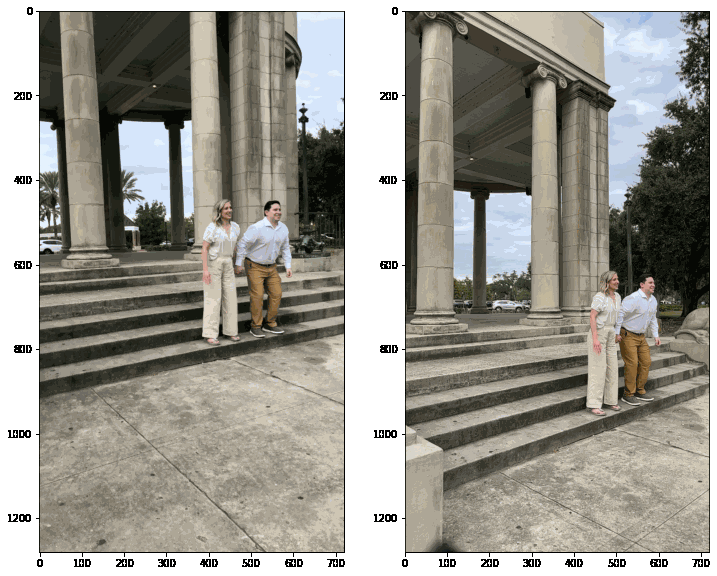
매칭된 이미지 애니메이션
코드
이를 바탕으로 만들어 보고 싶으시면 이메일로 연락해 주세요
함께 일하세요
프로젝트에 NeRF를 활용하는 데 도움이 필요하시면 이메일을 보내 주세요.
Laan Labs와 함께하기
가우시안 스플래팅 및 래디언스 필드
사진과 영상으로 구현하는 사실적인 3D 캡처로, 캡처 프로토콜부터 학습, 브라우저 또는 기기에서의 제공까지 아우릅니다.
이 글 다운로드
오프라인에서 읽을 수 있는 마크다운 원본을 받으십시오