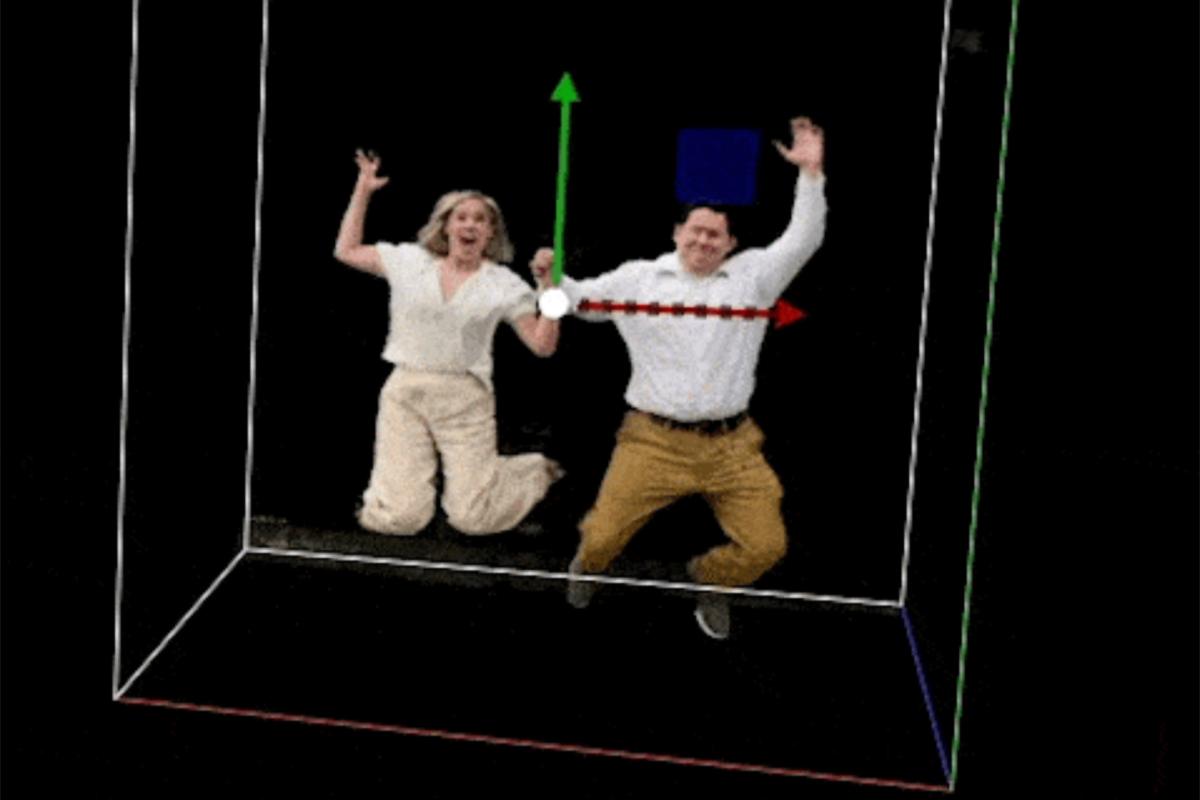
« Bullet Time » au ralenti avec les NeRF

En bref
Nous avons utilisé des NeRF et 15 iPhone pour enregistrer de la vidéo volumétrique 3D « Bullet Time »
Bullet Time avec les NeRF
Vidéo complète
Vue d'ensemble
Mon cousin se mariait le mois dernier, et nous faisions une séance photo de famille pour l'occasion. J'en ai profité pour reprendre une idée avec laquelle nous bricolons depuis un moment. Le principe de base : réunir un groupe d'amis pour capturer une scène sous différents angles avec des téléphones mobiles. Le résultat final serait une image figée, ou une vidéo « Bullet Time » comme dans Matrix.
Quand nous avons joué avec cette idée il y a des années, les NeRF n'existaient pas, et nous n'avions donc pas de bon moyen de réaliser une « synthèse de vues » de qualité. La « synthèse de vues » signifie simplement ici le rendu d'images d'une scène depuis des points de vue différents de ceux qui l'ont capturée à l'origine.
Les NeRF
Les NeRF, ou champs de radiance neuronaux (Neural Radiance Fields), se sont rapidement imposés comme une méthode nouvelle et étonnante de synthèse de vues et de reconstruction 3D.
Les champs de radiance neuronaux sont une méthode de représentation et de rendu de scènes 3D par apprentissage profond. L'idée principale des NeRF est d'utiliser un réseau de neurones pour prédire la radiance d'une scène en chaque point de l'espace 3D. À partir d'un ensemble d'images d'entrée d'une scène, le réseau de neurones apprend à prédire la structure 3D de la scène, ainsi que la réflectance de surface et l'éclairage en chaque point. La représentation obtenue est une fonction continue qui peut être évaluée en tout point de l'espace 3D, ce qui permet un rendu très réaliste de la scène depuis n'importe quel point de vue. Les NeRF peuvent produire des rendus photoréalistes de haute qualité de scènes 3D complexes, et ont le potentiel de révolutionner le domaine de l'infographie.
Le domaine évolue si vite que de nouvelles approches et améliorations apparaissent presque chaque jour.
Vous pouvez en savoir plus sur les NeRF ici, lire l'article original ici, ou regarder de superbes rendus de NeRF sur YouTube.
En 2021, NVIDIA a publié Instant NGP, une boîte à outils open source pour créer rapidement des NeRF à partir d'images ou de vidéos. Instant NGP a ramené le temps d'entraînement des NeRF de plusieurs jours à quelques minutes.
Le bullet time avec des NeRF a déjà été réalisé, et de nouvelles extensions des NeRF permettent de représenter des scènes dynamiques en ajoutant une composante temporelle aux modèles NeRF existants. (voir les « NeRF dynamiques » comme DNerf)
Comme il s'agissait d'un projet annexe amusant et rapide, je n'ai pas pu tester les approches plus récentes et j'ai opté pour la facilité d'utilisation et les temps d'entraînement courts d'Instant NGP.
Nerfstudio est une autre boîte à outils d'entraînement de NeRF qui mérite le détour. Elle prend même en charge « DNerf » pour les scènes dynamiques, mais je n'ai pas encore eu l'occasion de la tester.
La recherche sur les NeRF avance si vite que, dans quelques mois, il y aura probablement des méthodes meilleures et plus rapides pour créer quelque chose comme ceci.
Capture des vidéos
La première exigence du projet est de capturer des vidéos au ralenti d'une scène sous différents angles. Les iPhone récents peuvent filmer à 240 images par seconde en résolution 1920x1080, ce qui suffit pour entraîner le NeRF.
Après avoir rassemblé tous nos appareils de test et sollicité des membres de la famille, nous avons réuni 15 iPhone. (Même si une scène NeRF utilise généralement plutôt 40 à 100 images.)
J'ai ensuite créé une application simple basée sur Firebase Realtime Database qui me permet de lancer l'enregistrement simultanément sur tous les téléphones. Une fois les vidéos capturées, elles étaient automatiquement envoyées vers Google Cloud Storage.
Appuyer sur enregistrer sur un téléphone lance l'enregistrement sur tous les appareils connectés.
Enregistrement synchronisé sur plusieurs téléphones
L'application affiche aussi le niveau de batterie et l'état d'envoi de la vidéo pour chaque appareil :
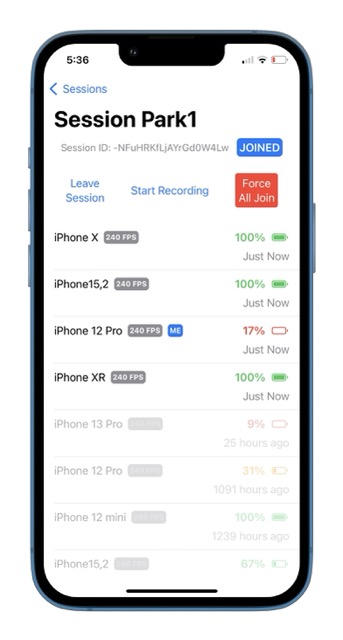
Trépieds pour iPhone
Nous avons fabriqué quelques trépieds rudimentaires avec du bois bon marché et demandé à quelques membres de la famille de tenir les autres téléphones :
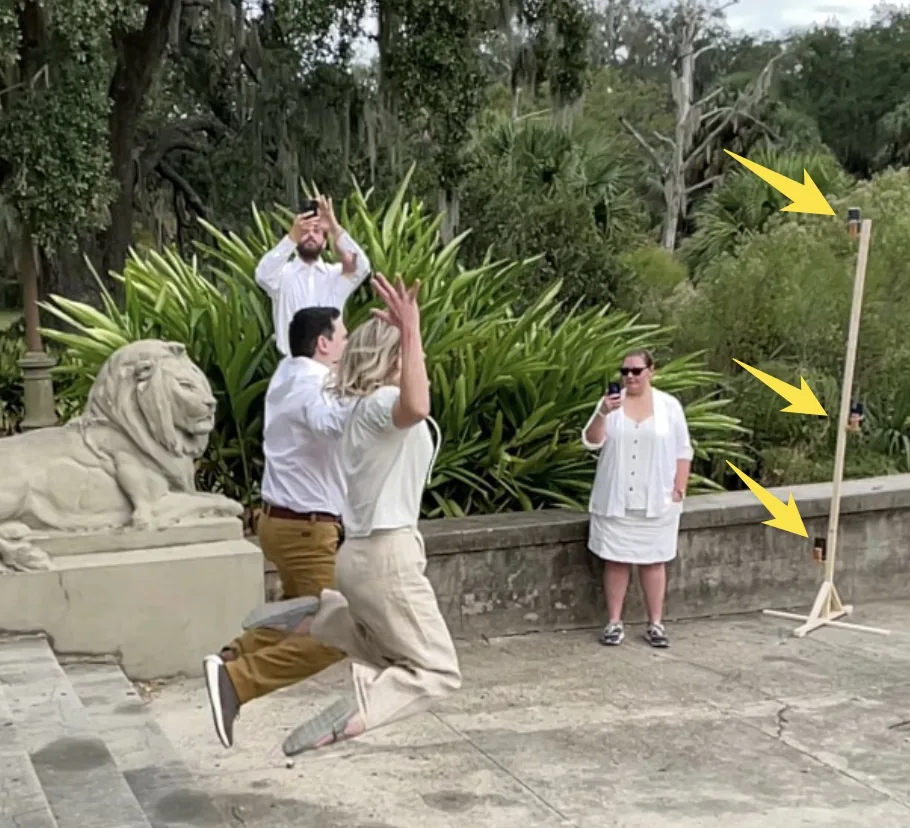
Dispositif de capture avec trépied
Voici quelques-unes des images capturées par les différents téléphones :
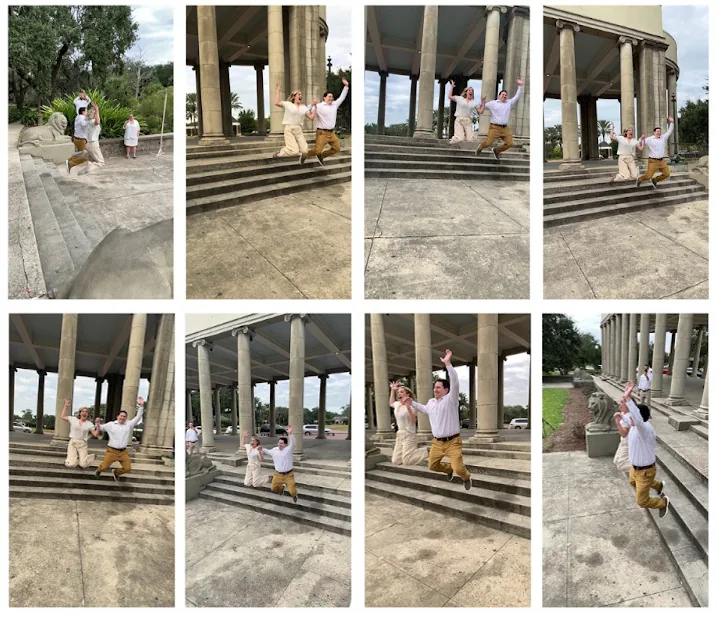
Exemples d'images
L'application verrouillait bien la mise au point et l'exposition à l'enregistrement, mais ne synchronisait pas ces valeurs entre les téléphones, ce qui explique les différences de couleur visibles sur les images. Nous y reviendrons plus bas.
Nous avions une fenêtre de temps assez courte, une dizaine de minutes peut-être, pour installer le dispositif et capturer la scène. Avec plus de temps, je testerais probablement différentes configurations de caméras pour voir ce qui marche le mieux.
Synchronisation temporelle des vidéos
Une fois toutes les vidéos capturées, il faut les synchroniser dans le temps.
En tant que développeur, je voulais automatiser ce processus, même si la synchronisation manuelle des vidéos était plus rapide pour une seule fois.
J'ai fini par écrire un petit script Python qui effectue une corrélation croisée des flux audio pour trouver le meilleur décalage temporel entre deux vidéos.
Pour rendre cela plus robuste, nous avons apporté deux barres métalliques que nous avons entrechoquées au début de l'enregistrement.
Formes d'onde audio de deux vidéos non synchronisées :
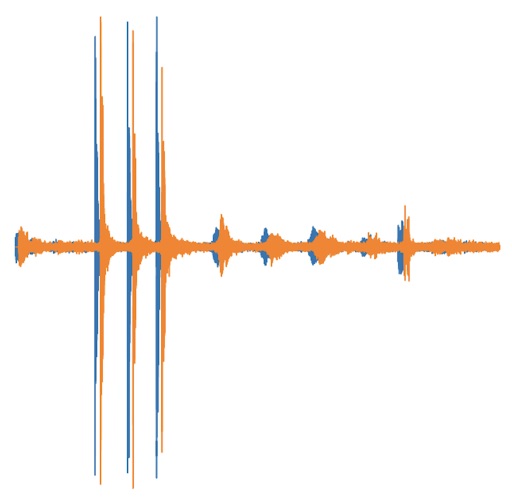
Alignement audio
La corrélation croisée montre un pic net là où les deux signaux sont alignés au maximum :
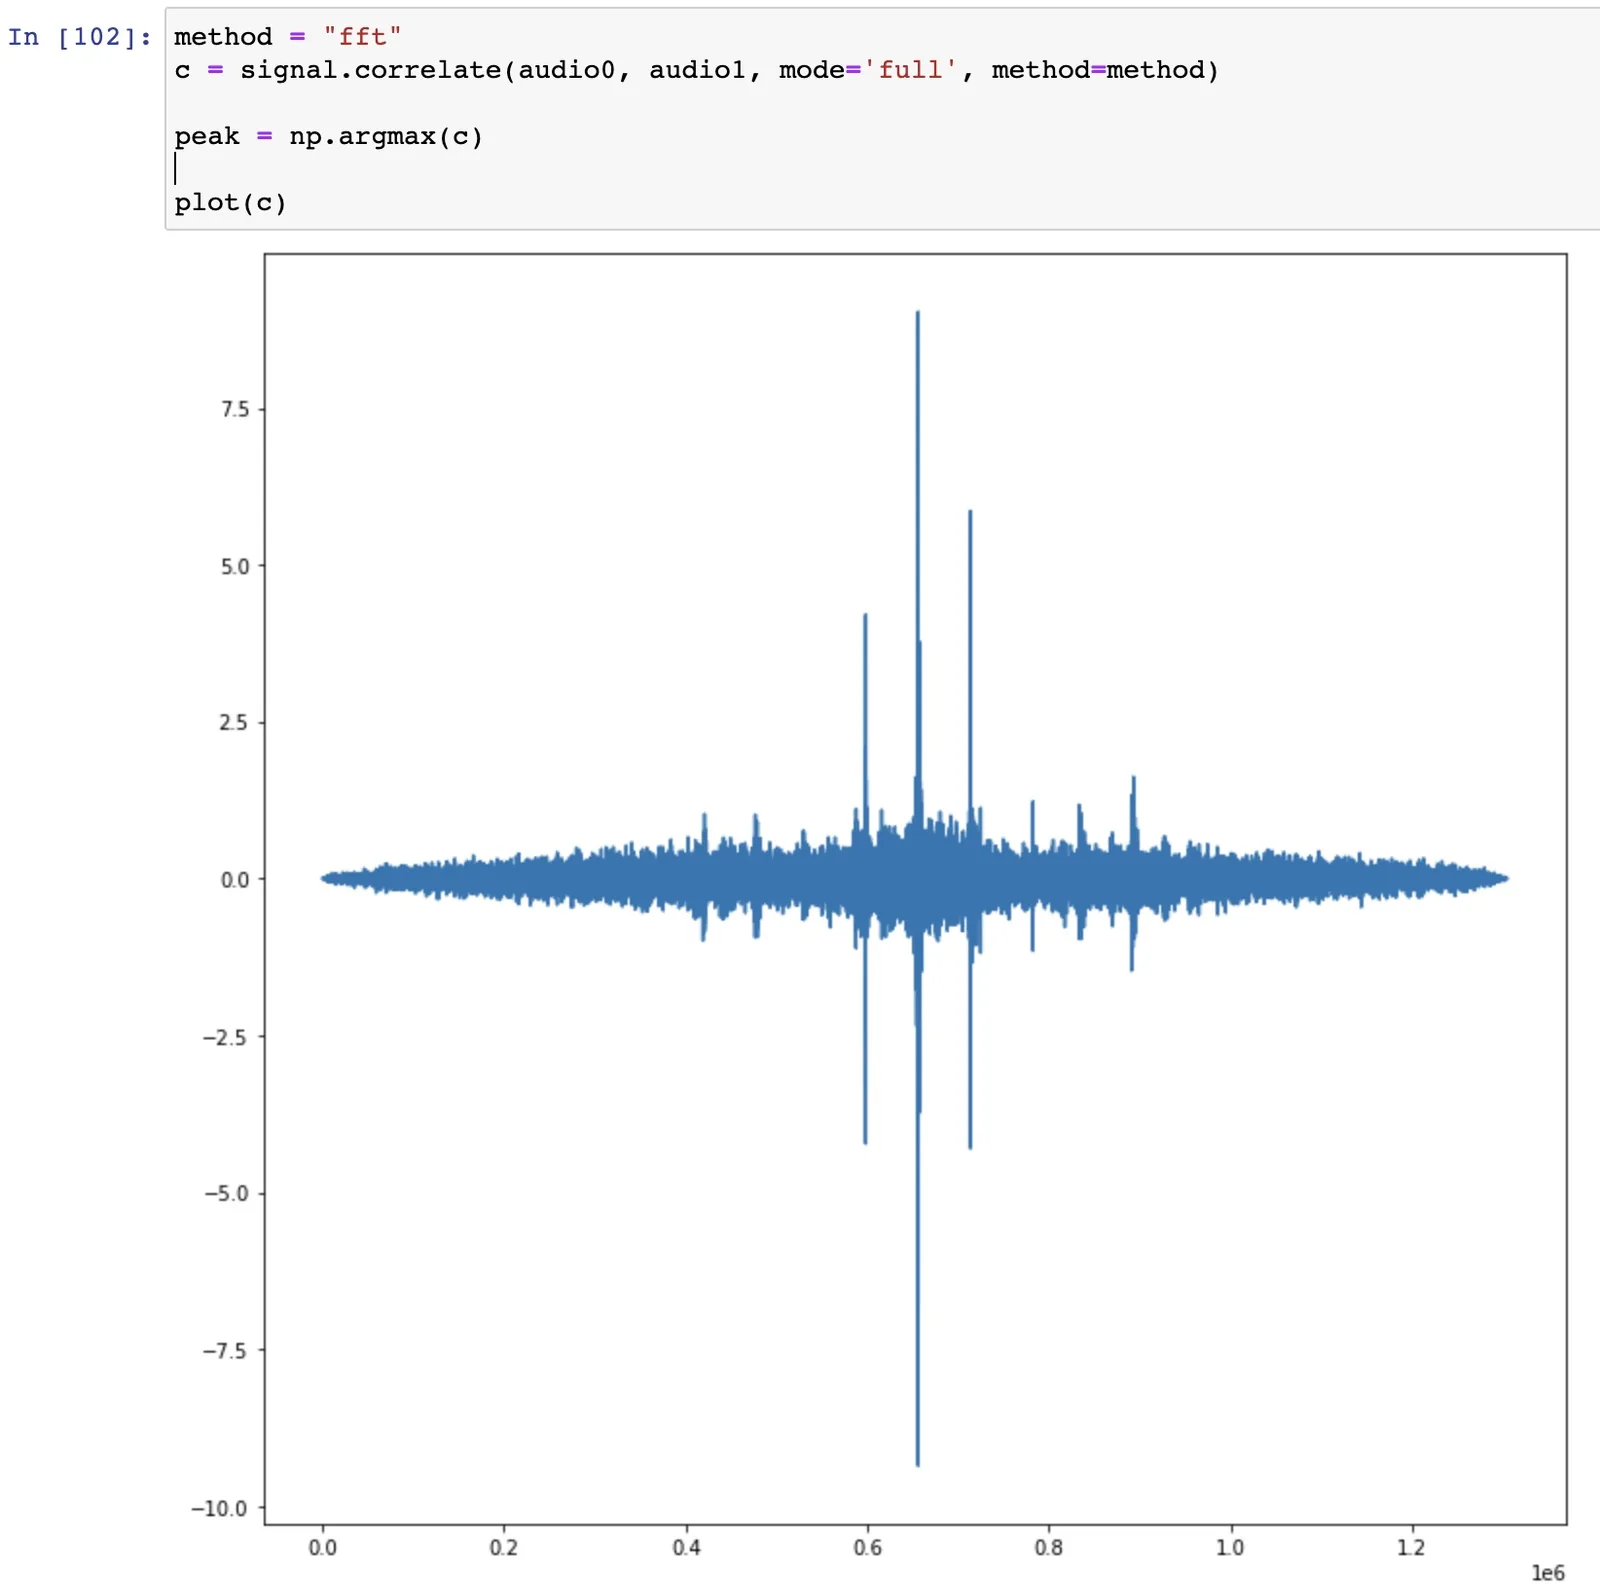
Corrélation croisée
Une fois toutes les vidéos alignées sur le même temps global, j'ai exporté un ensemble d'environ 200 images synchronisées pour les 15 téléphones. Soit environ 3000 images.
Entraînement des NeRF
L'étape suivante consiste à entraîner les NeRF sur toutes les données ; quelques problèmes méritent d'être mentionnés ici.
Combiner les pas de temps
D'abord, un peu de contexte sur le processus d'entraînement d'un NeRF :
La première étape d'un NeRF consiste à calculer les poses de caméra de toutes les images de la scène. COLMAP sert à cela
Dans le cas du bullet time, nous avons autant de « scènes » qu'il y a de pas de temps dans nos vidéos exportées (soit 200 pas de temps)
Il nous faut donc un moyen de nous assurer que les poses de caméra sont alignées dans un système de coordonnées global qui ne change pas tout au long de la vidéo.
Si aucune caméra ne bouge pendant la capture de la scène, c'est assez simple : il suffit de calculer les poses pour la première image et de les réutiliser pour toutes les suivantes. Dans mon cas, des personnes tenaient quelques-uns des téléphones pendant la capture, et ces téléphones ont légèrement bougé pendant le tournage.
Avec seulement 15 caméras au total, je ne voulais pas perdre les angles de vue essentiels des téléphones qui avaient légèrement bougé. Cela a nécessité de calculer les poses de caméra des caméras dynamiques pour chacun des 200 pas de temps.
Si j'avais le choix, la prochaine fois, j'opterais pour des caméras toutes statiques sur trépieds, car cela simplifie vraiment le processus de récupération des poses.
J'ai essayé plusieurs approches, mais j'ai fini par personnaliser légèrement COLMAP pour permettre la reconstruction incrémentale de la scène.
L'approche que j'ai retenue part d'une scène « d'arrière-plan » dont les poses de caméra sont calculées une seule fois et restent fixes pendant que de nouvelles images y sont ajoutées. La scène d'arrière-plan a été capturée sans personne, je pouvais donc me promener librement avec un seul téléphone et capturer beaucoup d'images.
Chaque « pas de temps » de la vidéo comporte 15 images, issues de toutes les caméras qui enregistrent. Pour chaque pas de temps, nous partons donc de la scène d'arrière-plan, puis y ajoutons de nouvelles images en fixant les poses de caméra de la scène d'arrière-plan. COLMAP permet d'ajouter de nouvelles images à une scène statique existante avec l'option « --Mapper.fix_existing_images », mais il modifie malheureusement quand même les poses de caméra de base lors de l'étape d'ajustement de faisceaux (bundle adjustment), et ensuite lors de l'étape de normalisation. J'ai modifié COLMAP pour qu'il fixe les poses de caméra existantes lors des étapes d'ajustement de faisceaux, et ne normalise pas la scène quand l'option « fix_existing_images » est passée.
Scène d'arrière-plan
Le problème suivant est que, avec seulement 15 caméras, le NeRF entraîné ne représentait qu'un volume 3D assez réduit autour du sujet (les personnes). Déplacer la caméra pour montrer d'autres parties de la scène produisait beaucoup d'artefacts / d'éléments flottants (floaters) :
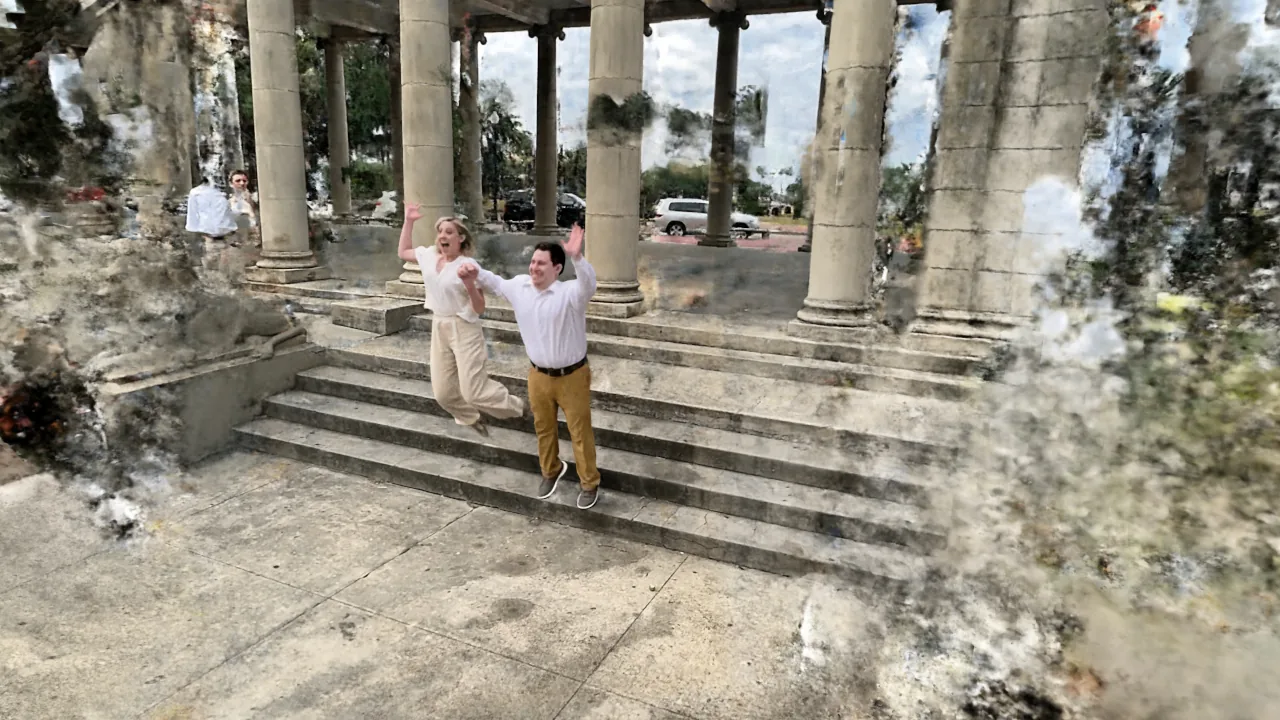
Image exemple avec éléments flottants
Pour pouvoir rendre les autres parties de la scène, j'ai donc capturé environ 200 images de la zone environnante sans aucune personne.
J'ai ensuite entraîné un NeRF distinct, qui serait composité avec le NeRF de chaque pas de temps :
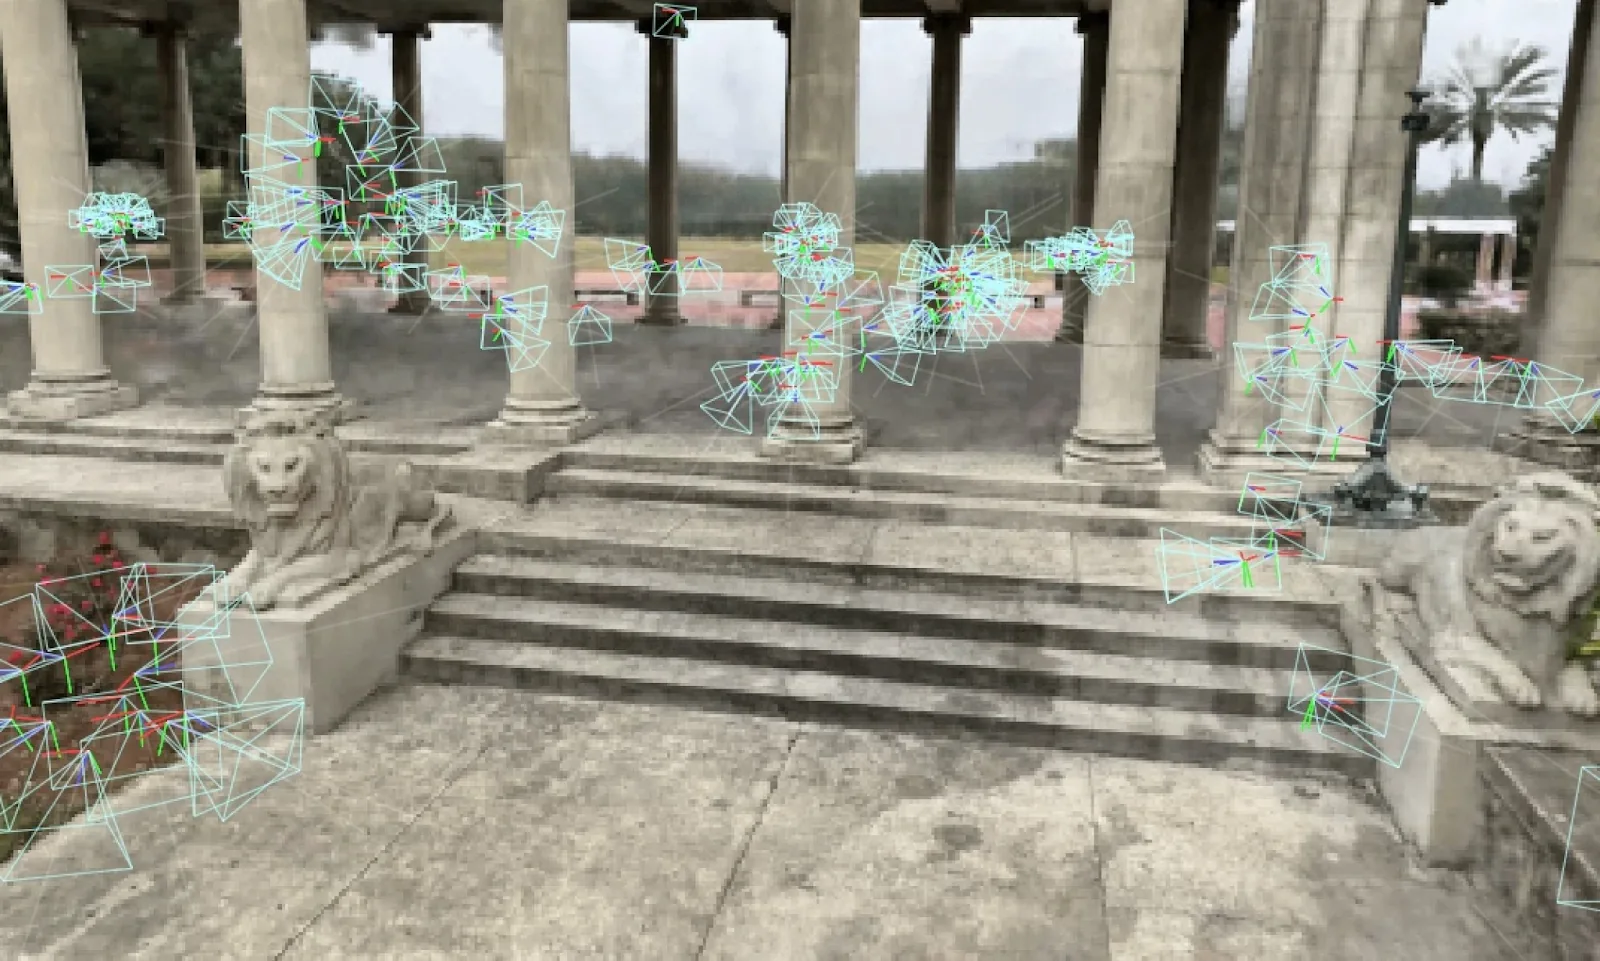
Rendu du NeRF de la scène d'arrière-plan
Comme indiqué plus haut, ma configuration COLMAP personnalisée faisait que le NeRF d'arrière-plan se trouvait déjà dans le même système de coordonnées que chacun des NeRF de pas de temps ; les différents rendus se composent donc parfaitement lors du rendu des trajectoires de caméra :
Composition de la scène
J'ai toutefois dû rendre les NeRF dynamiques avec un volume de découpe et de la transparence, pour que seules les personnes soient rendues :
Volume de découpe du premier plan
Notes sur la qualité de la scène
Quelques notes sur les problèmes de qualité / de rendu rencontrés pendant le projet.
Scintillement
À l'origine, j'ai entraîné chaque pas de temps de NeRF séparément, mais lors de la création de l'animation à partir de tous les NeRF, il y avait beaucoup d'artefacts de scintillement :
Scintillement temporel
J'ai testé la réutilisation du réseau entraîné d'un pas de temps précédent comme initialisation du pas de temps suivant (en enregistrant précisément un instantané après environ 500 itérations pour servir d'initialisation au pas de temps suivant)
Cela a nettement amélioré la continuité de la solution à laquelle le réseau aboutit, qui devient similaire d'un pas de temps à l'autre. Si j'avais eu plus de caméras, je ne pense pas que ce serait un si gros problème, puisqu'il y aurait moins de place pour l'ambiguïté dans la scène.
Éléments flottants
Les artefacts appelés « floaters » apparaissent lorsqu'il y a de l'ambiguïté dans les vues pendant l'entraînement. Ajouter des vues de caméra la réduit, mais dans notre cas, ajouter des caméras n'est pas simple pour la scène dynamique.
Régler la « distance proche » (near distance) d'entraînement a nettement aidé à réduire les floaters. J'ai failli implémenter une distance proche par caméra afin de les réduire encore.
Une autre idée que j'envisageais de construire était des volumes ou des plans de masquage. L'intuition de base est : « je sais qu'il y a du vide ici, donc ne mets ni floaters ni densité à cet endroit »
Un exemple est le sol / plan du sol. Pour des scènes avec un plan de sol évident comme celle-ci, si je pouvais faire en sorte qu'aucune densité ne soit autorisée sous le plan du sol, la reconstruction du sol paraîtrait plus cohérente dans les vues inédites.
Il en va de même pour de grands volumes de vide : le NeRF apprend souvent de la densité dans des zones où il serait facile de tracer un cube géant pour « mettre à zéro » tous les gradients à cet endroit.
Je voulais aussi tester une supervision par la profondeur, pour voir si elle réduirait elle aussi les floaters.
Régularisation
La régularisation a été intégrée à de nombreuses méthodes NeRF ultérieures, mais pas beaucoup, à ma connaissance, au dépôt Instant NGP. Avec plus de temps, j'aimerais explorer quelques techniques pour orienter l'entraînement du réseau dans la bonne direction.
- Supervision de profondeur monoculaire avec MiDas
- A priori de cohérence des normales pour des surfaces lisses
Au final, l'utilisation d'une scène d'arrière-plan propre, entraînée sur de nombreuses vues, avec les personnes masquées, a fait que les floaters n'étaient pas un gros problème.
Si vous disposez d'un nombre limité d'angles de caméra, ces idées pourraient valoir la peine d'être explorées.
Harmonisation des couleurs
Certaines images capturées par des téléphones différents présentent des tons de couleur légèrement différents :
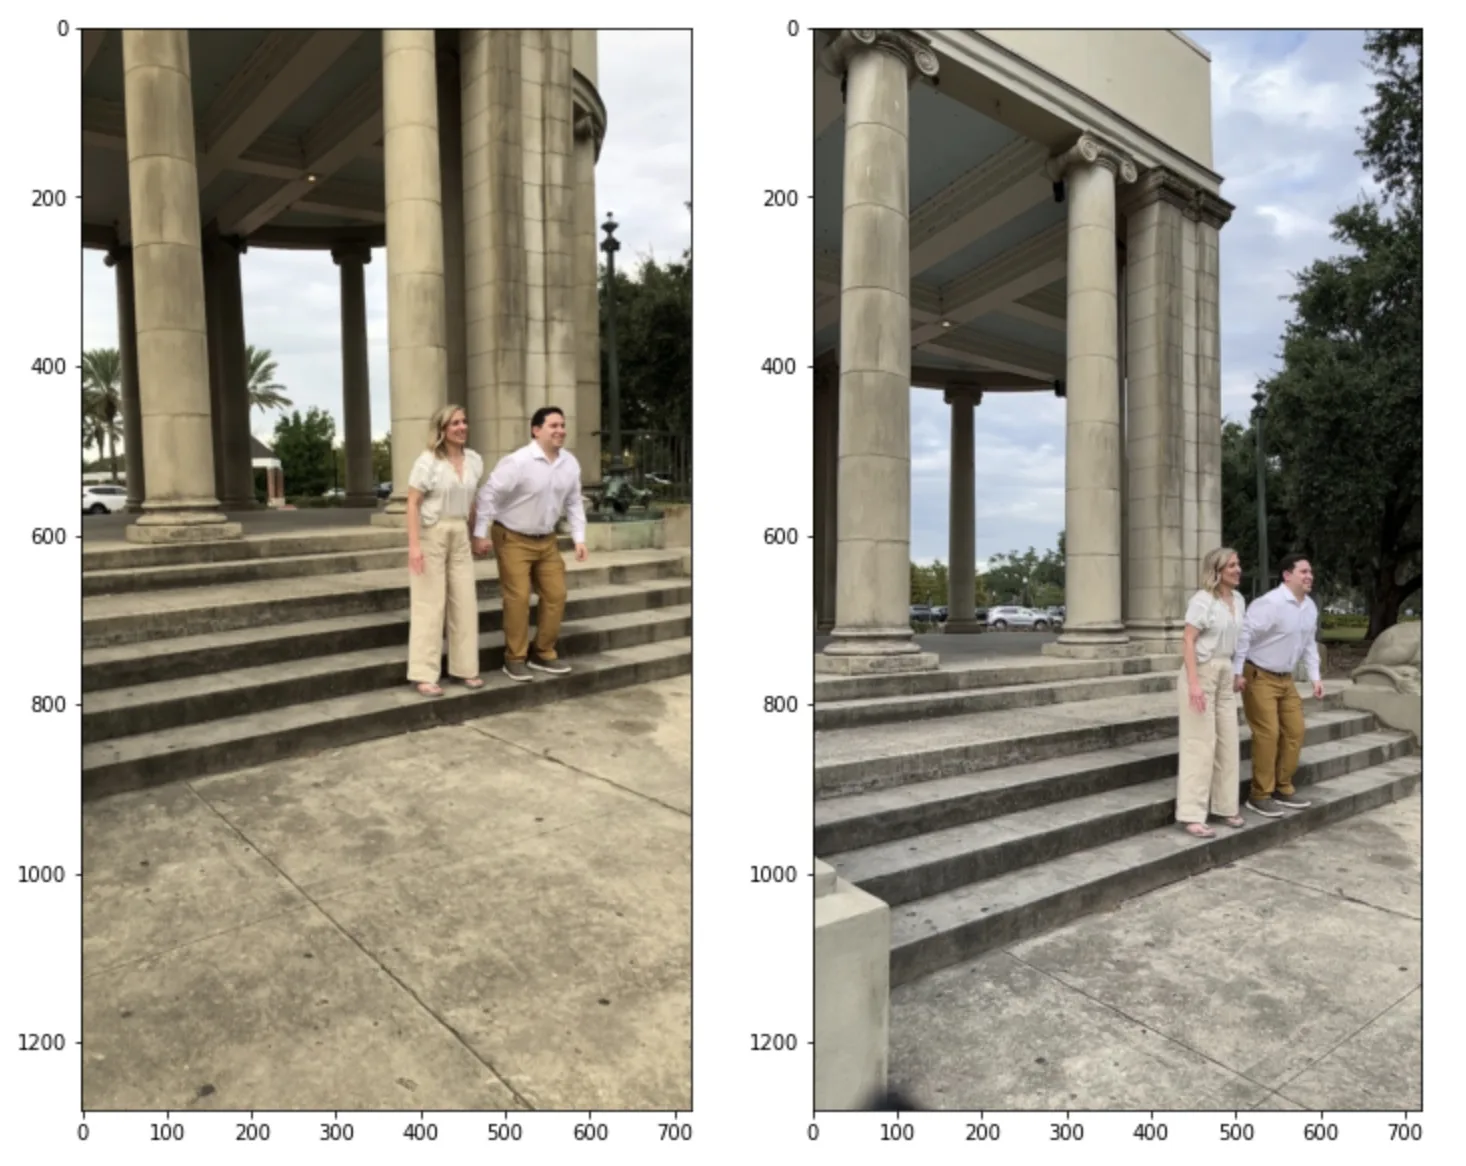
Écart de tonalité des couleurs
Inclure un repère de calibration dans les images pourrait faciliter un peu la résolution automatique de ce problème. Il existe probablement de nombreuses façons de le résoudre ou de l'atténuer. Peut-être qu'à la capture, nous pourrions synchroniser la balance des blancs et l'exposition sur tous les téléphones. Je n'ai pas exploré d'autres techniques pour résoudre ce problème.
Une idée était de sélectionner les mêmes points dans les différentes images, puis de calculer une transformation de couleur qui réduise les écarts de couleur entre les images.
Un problème possible serait de ne pas tomber exactement sur le bon pixel d'une image à l'autre.
Utiliser les caractéristiques SIFT de COLMAP pourrait aider, mais comme les caractéristiques SIFT se trouvent souvent sur des contours / zones de fort contraste, on risque de sélectionner des couleurs différentes pour le « même » point 3D projeté dans différentes images.
Transport optimal
La première et seule chose que j'ai essayée pour résoudre ce problème a été le transport optimal des histogrammes de couleur.
J'ai trouvé de bons exemples de code sur le web, issus de la bibliothèque Python Optimal Transport / POT, ici :
Ma seule modification un tant soit peu astucieuse a été d'échantillonner plus fortement sur les personnes dans l'image, puisque c'est ce qui m'importe le plus, mais aussi parce que les personnes sont présentes sur chaque prise de vue.
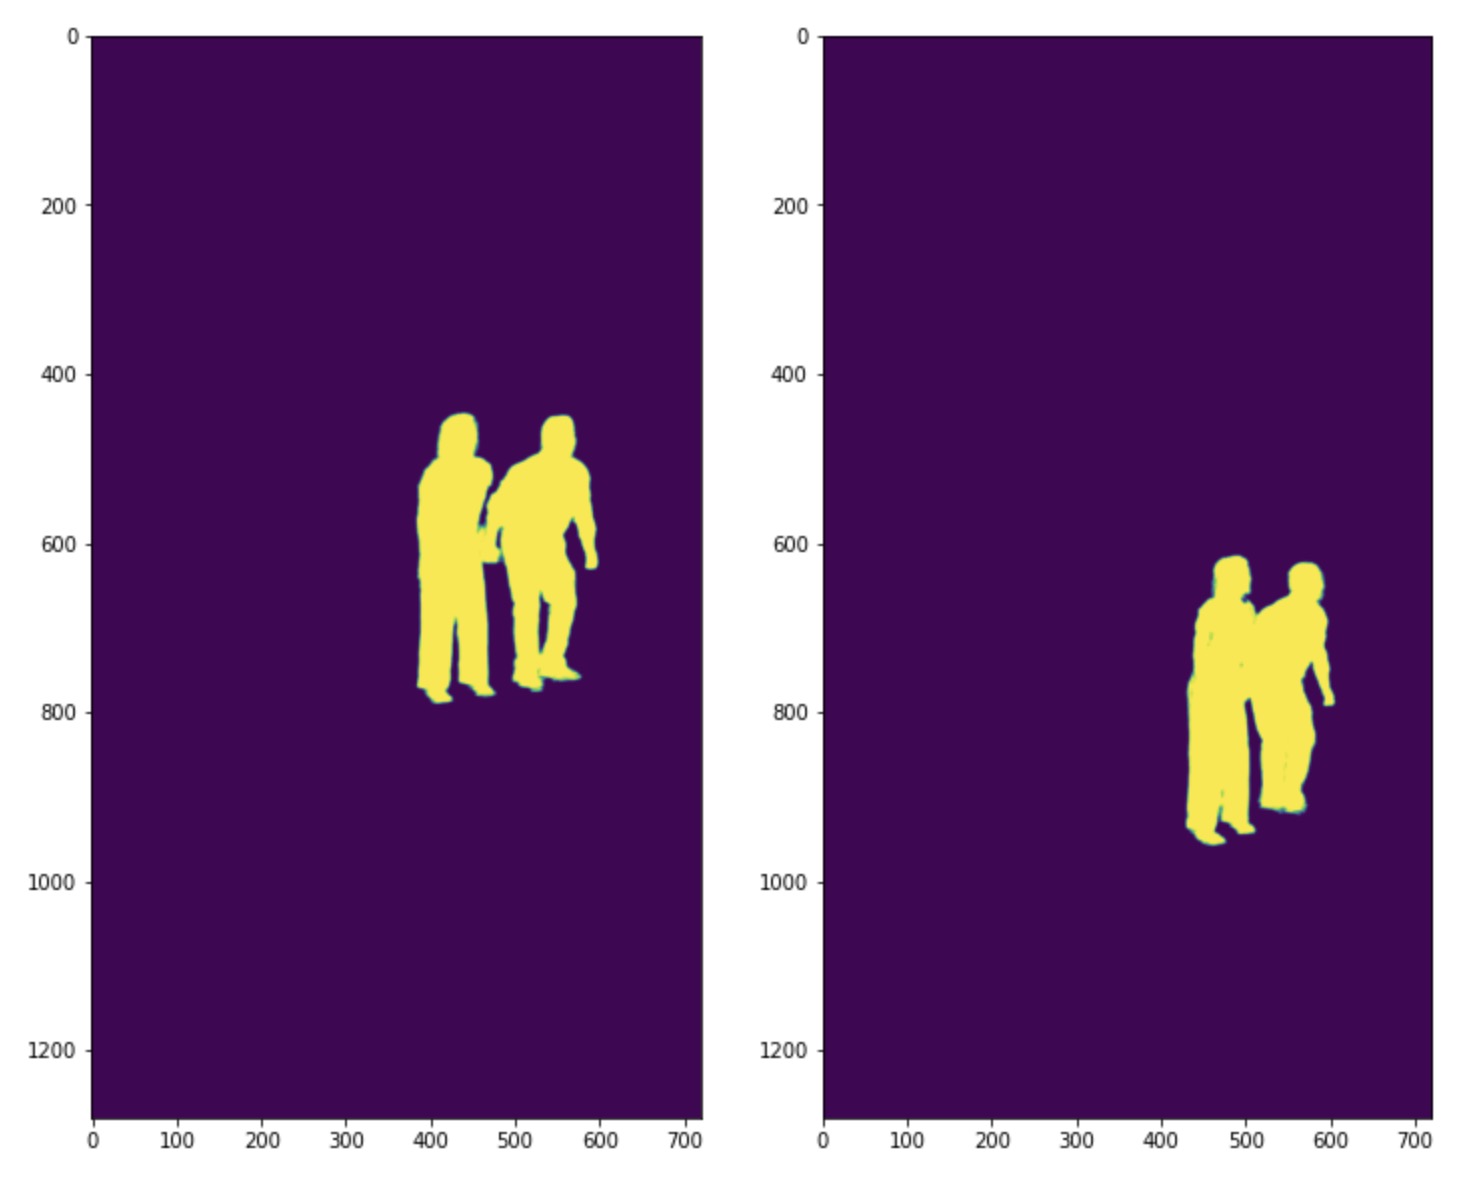
Masques de segmentation des personnes
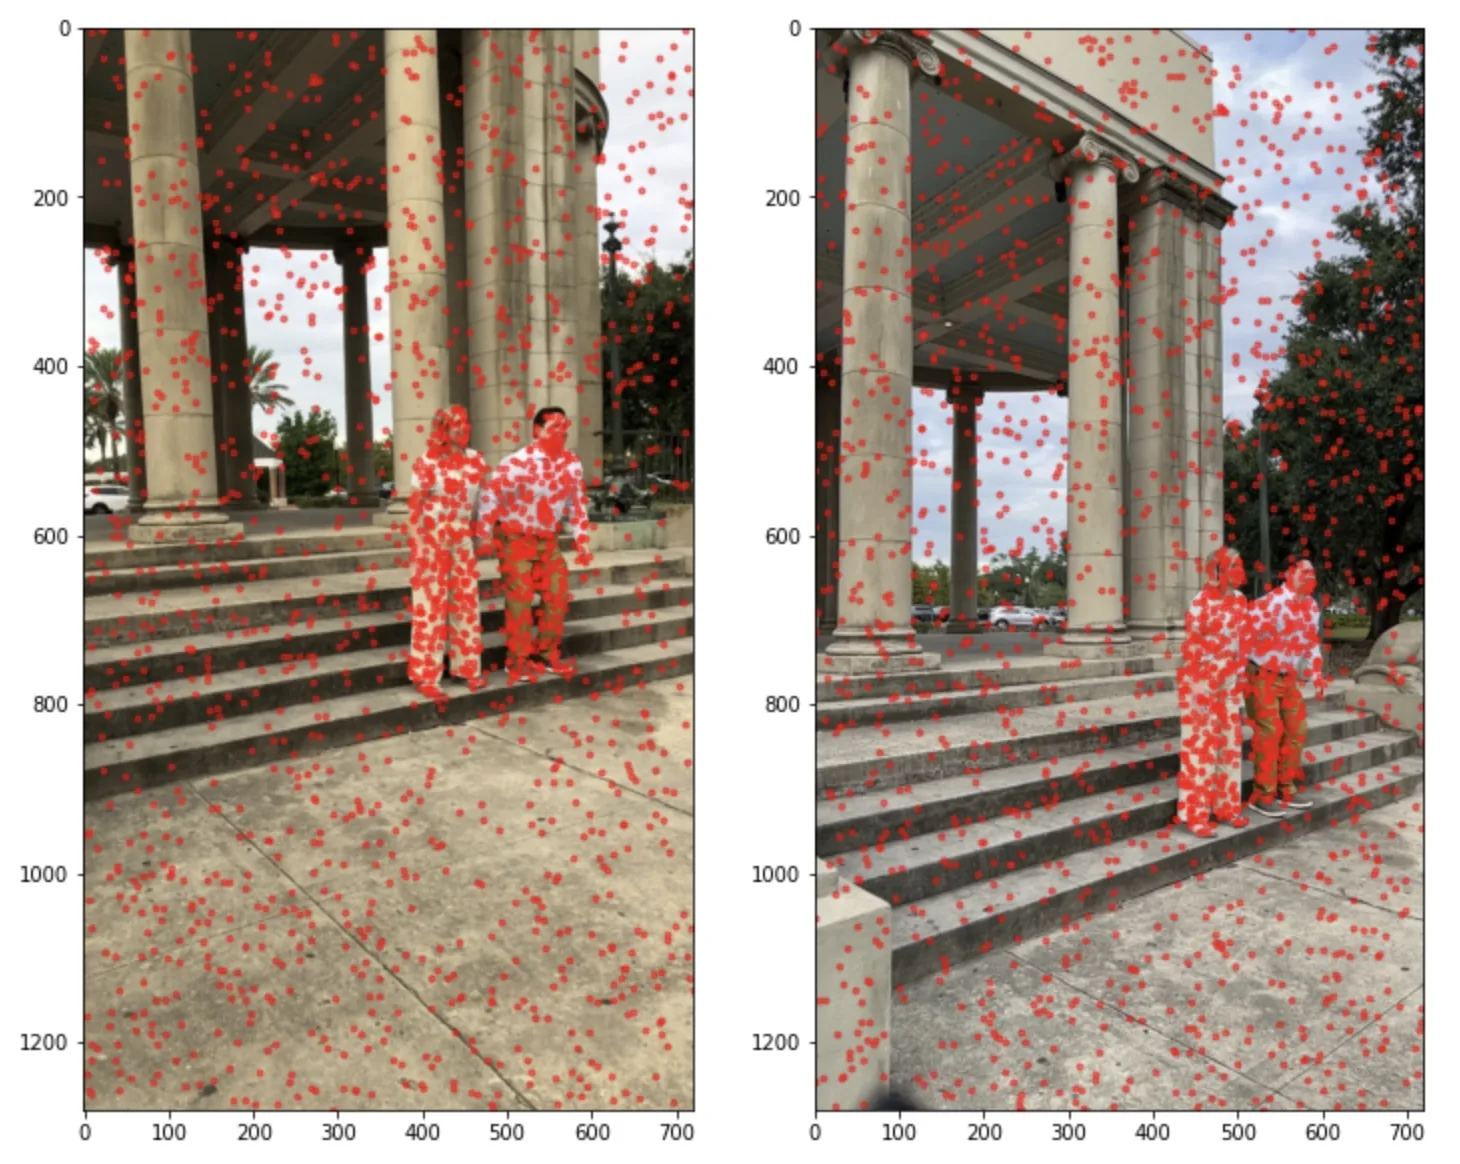
Échantillonnage de la segmentation des personnes
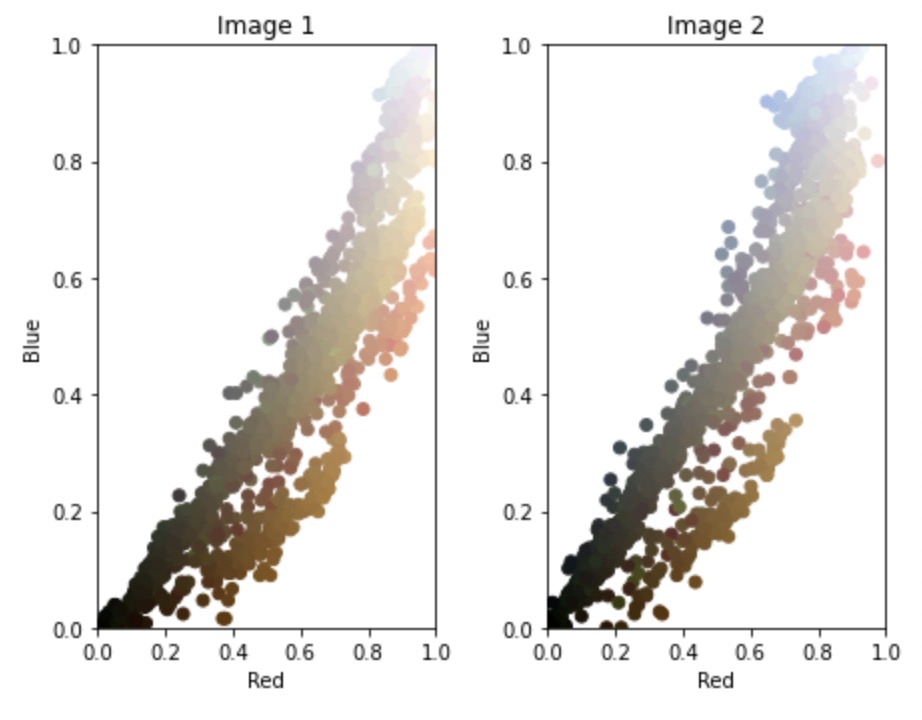
Graphiques de couleurs
C'est un changement subtil, mais je pense qu'il fait une différence dans la reconstruction du NeRF :
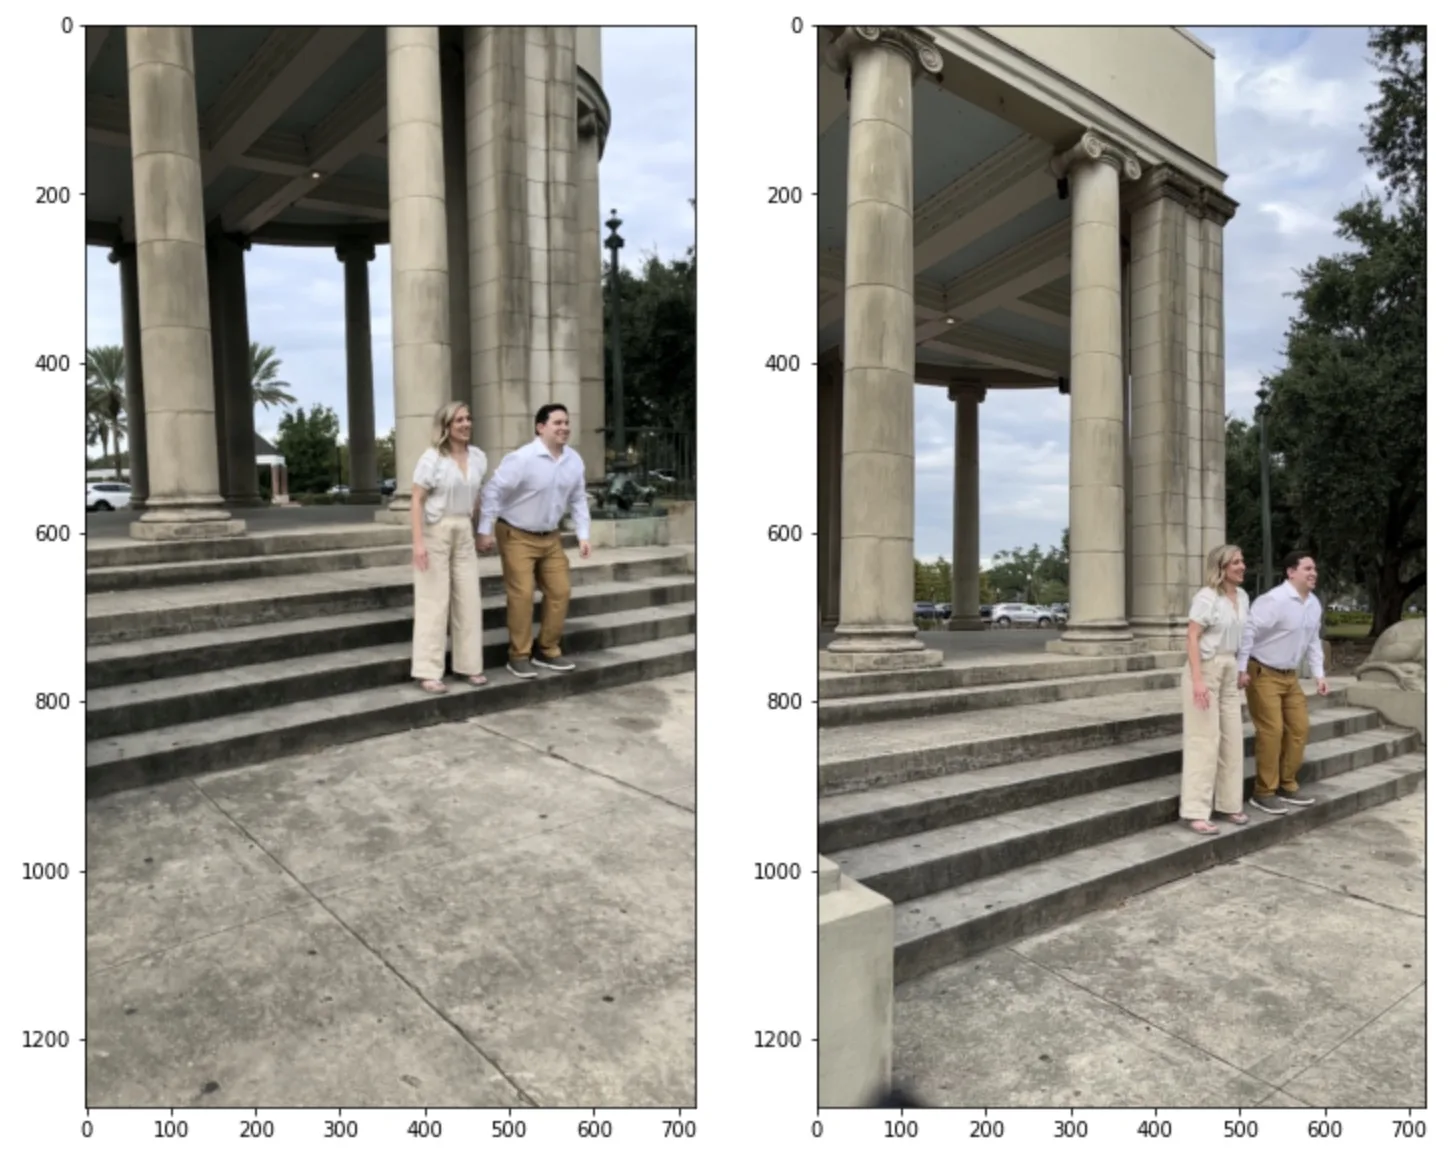
Images harmonisées
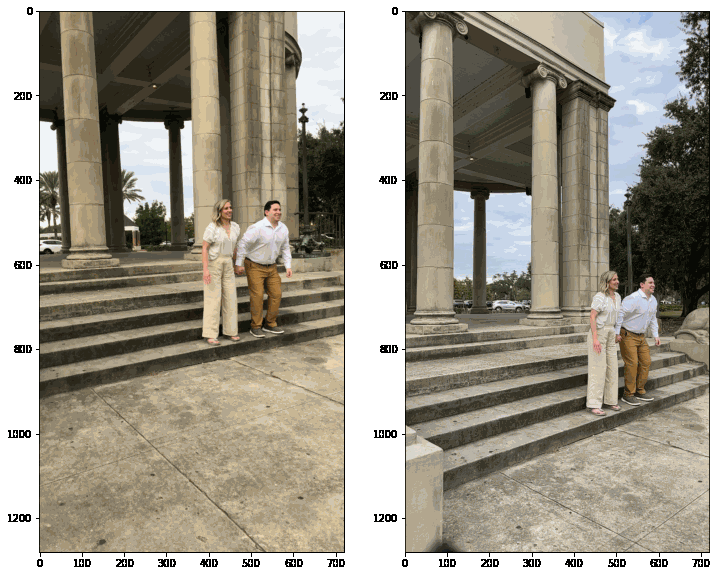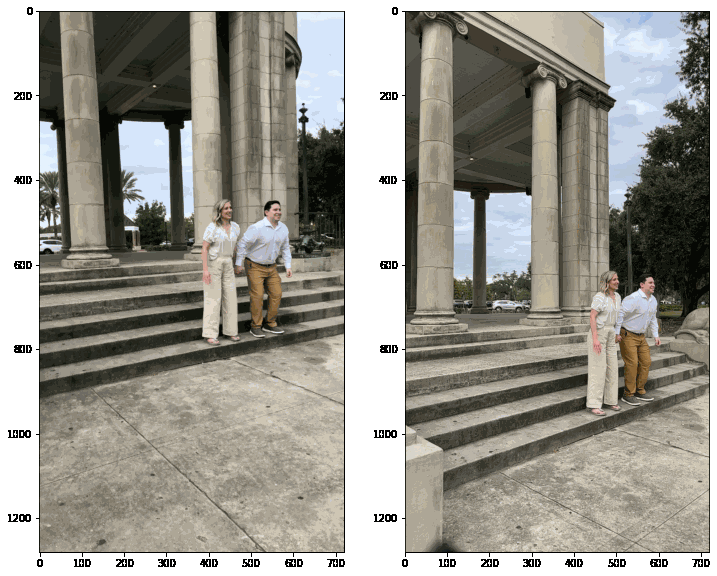
Animation des images harmonisées
Code
Si vous souhaitez vous appuyer sur ce travail, écrivez-nous par e-mail
Travaillez avec nous
Si vous avez besoin d'aide pour utiliser les NeRF dans un projet, envoyez-nous un e-mail.
Travailler avec Laan Labs
Gaussian Splatting et champs de radiance
Une capture 3D photoréaliste à partir de photos et de vidéos, du protocole de capture à l’entraînement, puis à la diffusion dans un navigateur ou sur un appareil.
Télécharger cet article
Récupérez la source Markdown pour le lire hors ligne