
构建火车鸣笛检测神经网络

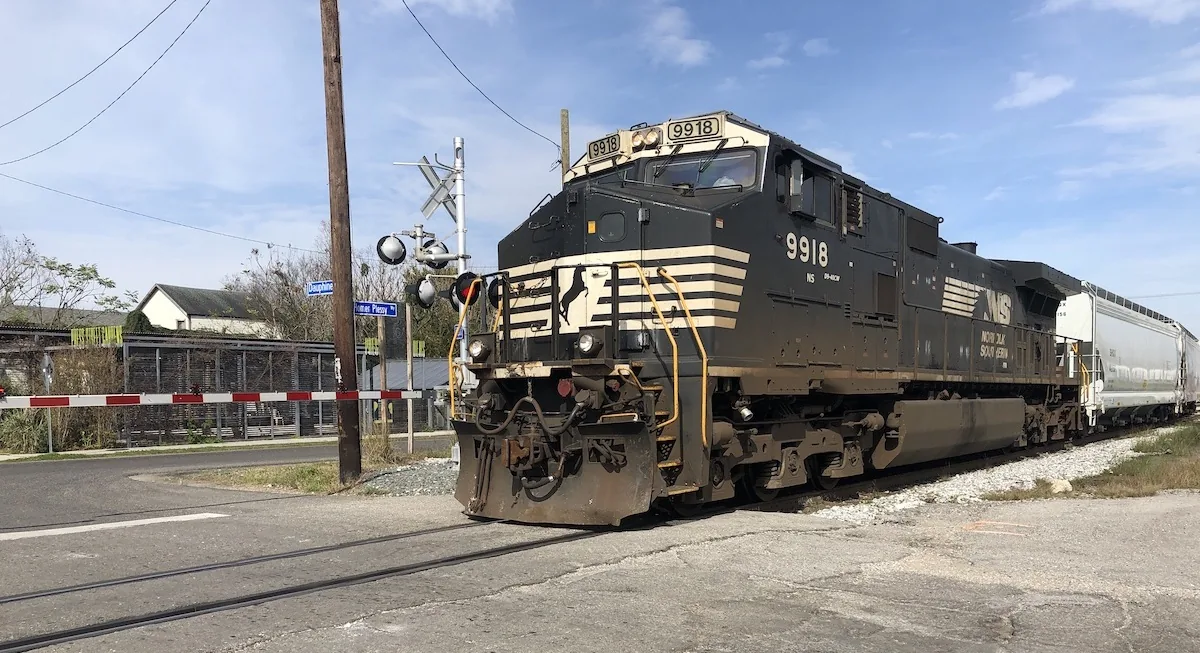
罪魁祸首
我碰巧住在一条铁路附近,这趟火车白天黑夜都鸣笛不断。而且铁路穿过社区,横跨五六条街道,却没有任何自动栏杆来阻止行人车辆通行,所以火车在通过每个路口之前,都必须长时间鸣笛。于是,作为一种自我疗愈,我决定尝试检测并量化这种鸣笛行为。我还希望能实时查看火车是否正堵着路口。如果你赶时间却被火车堵在后面,那真的很烦。这篇文章详细介绍了我为此做的周末项目。
太长不看
经过一个周末的折腾,我做出了一个准确的火车鸣笛检测器,并用窗外的麦克风实时运行。你可以在 GitHub 上获取训练这个网络的代码。
我还把检测结果实时发布在网上:BywaterTrain.com
神经网络
我对音频分类并不熟悉,所以先上网随便搜了搜,希望已经有人解决过类似的问题。我的限制条件是模型要足够快,能处理来自麦克风的实时音频。由于没有大量的标注数据,我想找一个类似“音频版 ImageNet”的网络,可以在很小的数据集上做微调。Google 的 Yamnet 似乎满足其中几条,于是我选了它。
Yamnet
Google 的介绍是这样的:“YAMNet 是一个预训练的深度网络,基于 AudioSet-YouTube 语料库预测 521 个音频事件类别,并采用 Mobilenet_v1 深度可分离卷积架构。”它使用 Mobilenet_v1,说明速度大概够快;而且是在大数据集上预训练的,那就更好了。
Google 的 AudioSet-YouTube 数据集本身就很有意思。它由 YouTube 视频片段中的音频构成,你可以下载 .csv 文件(指向 YouTube 视频中的对应时间点),也可以下载由他们的 VGG 风格架构输出的 128 位特征向量(见这里)。
这个数据集本身已经包含各种与火车相关的类别,但它在我的数据上的准确率不够好,所以我决定在 yamnet 的输出之上再微调一个网络。
如果你的数据属于这 521 个类别之一,也许可以直接使用 yamnet 的输出,根本不需要训练任何东西。
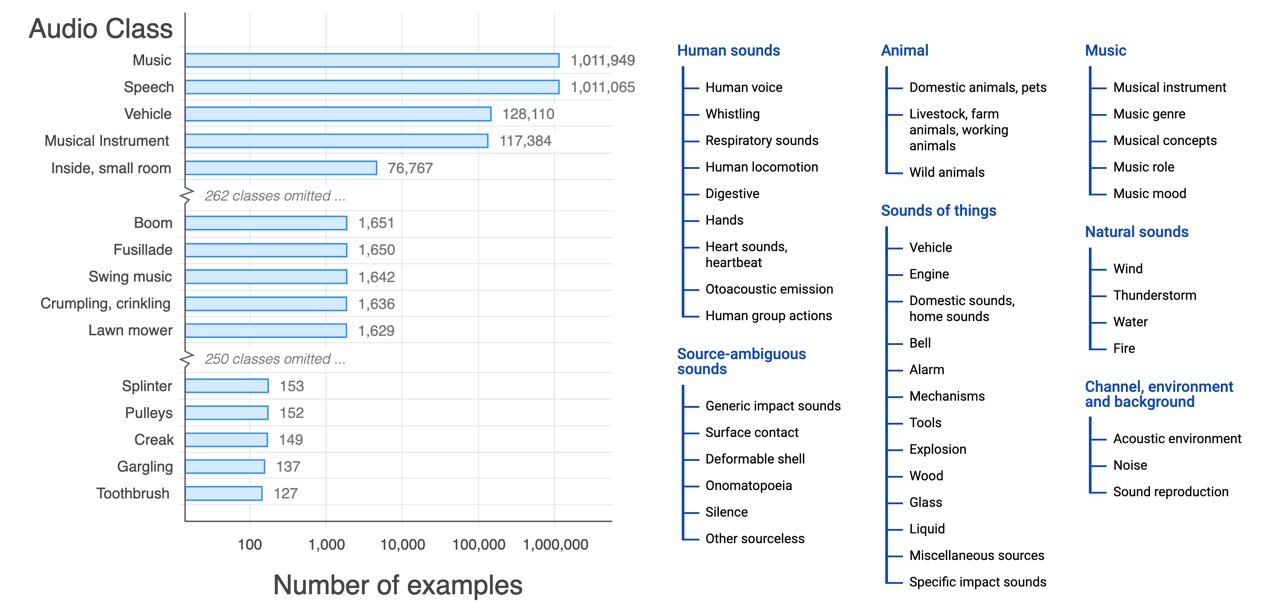
YouTube 音频数据集
创建训练数据
我用电脑的麦克风录制了一些短音频片段,并把它们标注为正例(火车鸣笛)或负例(其他所有声音)。最后总共得到大约 200 个短片段,数量不算多,但用于微调似乎已经足够。
yamnet 模型以 0.96 秒为窗口处理音频,所以我把录音切成这个长度的片段。对每个片段,我先用 yamnet 得到 1024 维的嵌入向量,再把它作为输入,在上面训练一个简单的分类器。
结果
最终的模型效果出乎意料地好!它能实时检测火车鸣笛,准确率很高。误报很少,一天当中的大多数鸣笛事件它都能捕捉到。
我一直让它在一台 Raspberry Pi 上连续运行,配一个便宜的 USB 麦克风,把所有检测结果记录到数据库中。数据显示出火车经过社区的时间有一些有趣的规律。
欢迎到 BywaterTrain.com 查看实时检测结果!
代码
训练代码和模型架构都已在 GitHub 上开源:github.com/laanlabs/train_detector
欢迎把这种方法用于检测其他声音,比如汽车警报、施工噪音,或任何你想追踪的音频事件!
与 Laan Labs 合作
计算机视觉与 AI 开发
定制计算机视觉与机器学习,从概念验证到正式投产,支持设备端与云端。
下载本文
获取 Markdown 源文件,方便离线阅读