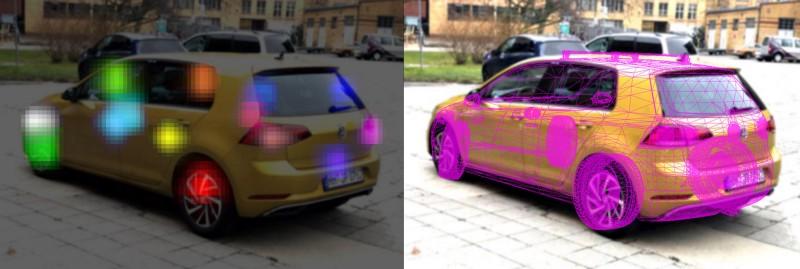
3D-Posenschätzung von Autos in Echtzeit, trainiert mit synthetischen Daten

Posen von Autos schätzen
3D-Posen von Autos in freier Umgebung mit einem gewöhnlichen iPhone schätzen
Projektüberblick
Unser Kunde hatte die Vision einer App, die Nutzer mithilfe von AR-Hilfslinien und automatischer Fotoaufnahme dazu anleitet, hochwertigere Autofotos aufzunehmen. Dieser Artikel konzentriert sich auf die Technik, die in die Komponente zur Posenschätzung des Autos eingeflossen ist. In der App werden Nutzer angeleitet, sich in bestimmten Winkeln und Abständen zum Auto zu positionieren, um die besten Bilder auf standardisierte Weise aufzunehmen. Befindet sich der Nutzer in der richtigen Position, werden automatisch hochauflösende Fotos aufgenommen.
Wir brauchten eine Möglichkeit, ungefähr zu wissen, wo im 3D-Raum ein Nutzer relativ zum Auto steht, das er fotografiert. Da es sich um eine Prototyp-App handelte, hatten wir nur wenige Wochen, um eine funktionierende Lösung zu entwickeln. Um die Entwicklung zu verkürzen, haben wir die Erkennung außerdem auf ein bestimmtes Automodell beschränkt.
Ziele und Randbedingungen
- Kurzer Zeitrahmen für die Entwicklung einer funktionierenden Lösung
- Posenschätzung des Autos in ungefährer Echtzeit (< 150 ms)
- Umfang auf ein bestimmtes Automodell mit unterschiedlichen Farben / Optionen begrenzen
- Die App soll hochwertige Fotos aufnehmen
Was wir ausprobiert haben, bevor wir etwas Neues gebaut haben
In der Hoffnung auf eine schnelle Standardlösung für die 3D-Posenschätzung von Objekten haben wir einige Ansätze getestet.
Apples ARKit-3D-Objekterkennung
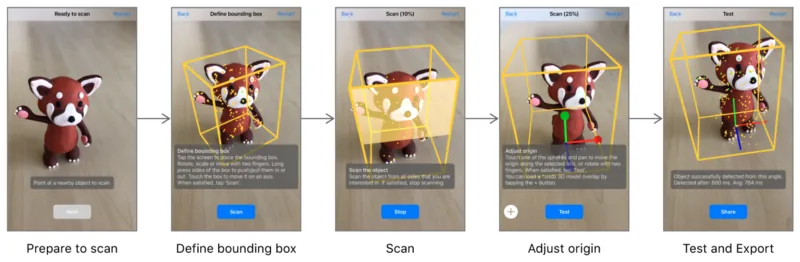
ARKit-Objekterkennung: App zum Scannen von Objekten
ARKit enthält APIs, um starre 3D-Objekte innerhalb von ARKit zu scannen und zu erkennen. Das schien ideal für uns: in Echtzeit und in ARKit integriert, würde das den Entwicklungsaufwand für diese Funktion auf null senken. Unsere größte Sorge war, verschiedene Autofarben zu erkennen. Um zu testen, wie gut ARKit damit umgeht, haben wir ein kleines Modellauto in mehreren Farben gekauft.
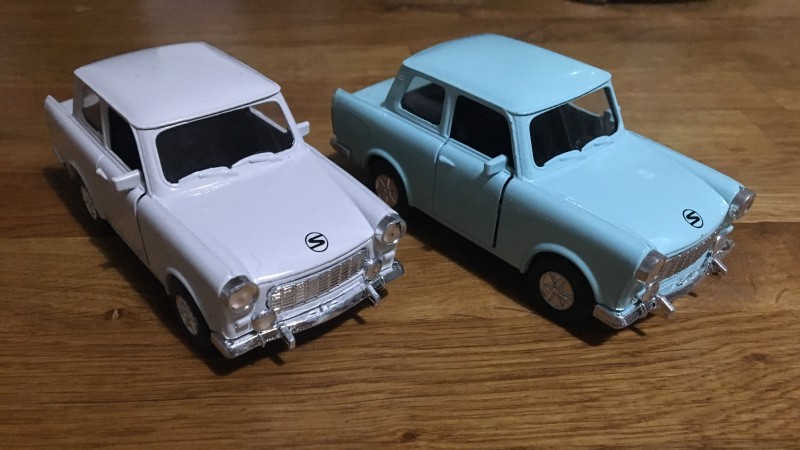
Modellautos zum Testen
Wir haben eine Farbe gescannt und dann an einer ähnlichen Farbe getestet (z. B. Weiß gescannt, an Hellblau getestet). In manchen Fällen funktionierte die Erkennung. Perfekt war sie nicht, aber vielleicht würde das Scannen einiger Grundfarben genügend Invarianz liefern, um jede Farbe des Autos zu erkennen, mit der wir rechnen müssen.
Der nächste Schritt war, es an echten Autos auszuprobieren. Es zeigte sich, dass sich echte Autos etwas anders verhielten. Selbst das Scannen und Testen am exakt selben Auto war nicht zuverlässig. Manchmal war das erkannte Auto leicht in die eine oder andere Richtung gedreht oder verschoben. Unsere Vermutung ist, dass die stark reflektierenden Lackierungen von Autos das merkmalsbasierte Scannen und Erkennen erschweren (Apple erwähnt in der Dokumentation ausdrücklich, dass reflektierende Objekte für die 3D-Erkennung nicht geeignet sind.)
SDKs von Drittanbietern
Wir haben auch einige andere SDKs getestet und ähnliche Ergebnisse wie mit ARKit erhalten. Manche Bibliotheken benötigten bestimmte „Initialisierungsvorlagen“ oder Positionen, die der Nutzer einnehmen muss, um das 3D-Objekt-Tracking in Gang zu bringen. Das war nicht ideal, da wir den Nutzer zu bestimmten Positionen führen wollten, die Erkennung also aus vielen verschiedenen Winkeln / Positionen funktionieren muss.
Fotoqualität
Ein weiterer Nachteil sowohl von ARKit als auch von den getesteten SDKs ist die Qualität und Auflösung der Fotos, die sich bei ihrer Verwendung aufnehmen lassen. Die höchste für die Aufnahme verfügbare Auflösung bei ARKit beträgt 1920x1440. Außerdem hat man bei ARKit nur sehr eingeschränkte Kontrolle über Fokus und Belichtung. Da es in der App darum geht, hochwertige Autofotos aufzunehmen, wollten wir neben einer hohen Bildauflösung auch eine feine Kontrolle über Fokus und Belichtung.
Einen auf einem neuronalen Netz basierenden Posenschätzer bauen
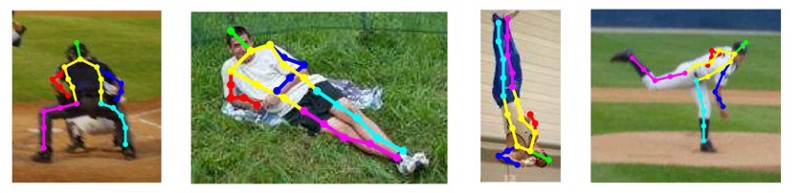
Posenschätzung beim Menschen
Da Lösungen von Drittanbietern keinen Erfolg brachten und die Einschränkung bei der Fotoqualität hinzukam, beschlossen wir, eine eigene Lösung zu entwickeln, die mit Apples AVFoundation-Kamera-APIs zusammenarbeitet. Wir haben uns für ein neuronales Netz entschieden, weil diese bei der Posenschätzung dem Stand der Technik entsprechen und es viele Open-Source-Projekte und viel Forschung gibt, auf die wir aufbauen konnten.
Ansätze zur Posenschätzung
Wie sagt man bei einem gegebenen Bild die 3D-Pose eines Objekts im Bild voraus? Ein verbreiteter Ansatz besteht darin, die Bildpositionen einer Menge bekannter Punkte auf einem kanonischen Modell des Objekts vorherzusagen. Zum Beispiel: Wo befindet sich auf dem Foto eines Autos der linke Scheinwerfer im Bild? Mit genügend solcher Vorhersagen können wir die 3D-Pose des ursprünglichen Automodells relativ zur Kamera schätzen, die das Foto aufgenommen hat.
Netzarchitektur
Neuronale Netze zeigen heute bei vielen unterschiedlichen Aufgaben eine beeindruckende Genauigkeit, können dank verbesserter Netzarchitekturen und schnellerer Geräte aber auch in Echtzeit auf mobilen Geräten laufen.
Kürzlich sind wir auf einige Projekte zur Echtzeit-Körperposenschätzung auf Mobilgeräten gestoßen, die auf den Architekturen CPM und Stacked Hourglass basieren.
- https://github.com/edvardHua/PoseEstimationForMobile
- https://github.com/tucan9389/PoseEstimation-CoreML
Diese Projekte enthalten viele nützliche Informationen zum Trainieren und Ausführen eines eigenen Posenschätzers auf mobilen Plattformen.
Das von ihnen verwendete CPM-Netz hat eine MobileNetV2-Basis und gibt für jedes der 14 Körperteile (linker Ellbogen, rechtes Knie usw.) eine 2D-Heatmap aus
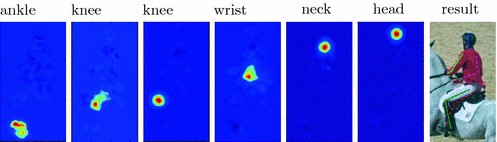
Heatmaps für verschiedene Körperteile
Von hier aus können wir im Wesentlichen die Orte maximaler Aktivierung für jede Keypoint-Schicht nehmen und dann die 3D-Pose des Autos mit der Methode SolvePnP von OpenCV schätzen. Hier ist eine Visualisierung unseres finalen neuronalen Netzes, das auf einem echten Autofoto läuft, zusammen mit der geschätzten 3D-Pose. Aufgrund der begrenzten Auflösung der Ausgabe-Heatmaps passt sie nicht perfekt. Unser Modell gibt Heatmaps mit einer Auflösung von 192x192 aus, sodass die Genauigkeit eines einzelnen Durchlaufs begrenzt ist.
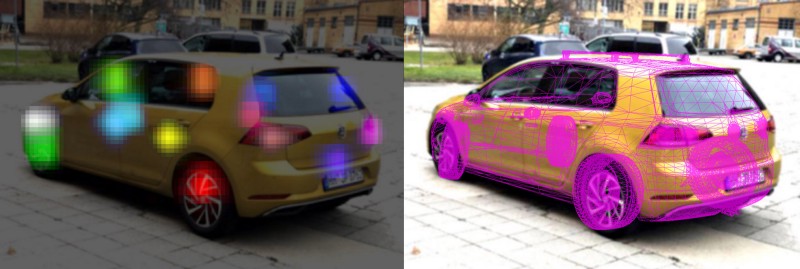
Endergebnis des Modells
Andere Ansätze und Ressourcen
Wir haben uns für CPM entschieden, um schnell loslegen zu können, aber es gibt auch andere Wege, dieses Problem zu lösen. Ein weiterer Keypoint-basierter Ansatz besteht darin, die 2D-Keypoints direkt als Liste von x,y-Koordinaten auszugeben. Das beschränkt uns zwar auf die Schätzung eines einzelnen Autos, für unseren Anwendungsfall wäre das aber in Ordnung. Inspiriert von Hart Wooleys Beitrag zur Handposenschätzung haben wir getestet, einfach ein paar Dense-Schichten auf MobileNet zu setzen, die schließlich einen 1x28-Satz von x,y-Keypoint-Positionen ausgeben. Überraschenderweise funktionierte das schon ohne Weiteres ziemlich gut. Mit mehr Zeit würden wir dieses Netz vielleicht weiter untersuchen, da es etwas schneller war als das von uns gewählte CPM-Modell.
Wenn Sie nur nach Posenschätzung beim Menschen suchen, lesen Sie Jameson Tooles aktuellen Beitrag über den Posenschätzer für Menschen von fritz.ai: https://heartbeat.fritz.ai/pose-estimation-on-ios-with-fritz-60c8e5f7d195
Eine andere Methode besteht darin, dass das Netz die Posenparameter des Autos direkt ausgibt, statt den Umweg über 2D-Keypoints zu gehen (siehe BoxCars, MultiBin). Bei dem knappen Zeitplan haben wir nicht jede mögliche Richtung gründlich geprüft, aber diese anderen Ansätze erscheinen durchaus sinnvoll.
Einen Auto-Datensatz finden
Nachdem die Netzarchitektur gewählt war, bestand der nächste Schritt darin, einen Datensatz zum Trainieren zu finden. An Datensätzen zur Körperposenschätzung herrscht kein Mangel (COCO, DensePose, MPII, Überblick über Körperposen-Datensätze), aber annotierte Autodaten sind etwas seltener. Einige Datensätze existieren (Apollo, PASCAL 3d+), doch jeder schien seine eigenen Einschränkungen zu haben. Die meisten Datensätze sind auf selbstfahrende Autos ausgerichtet, daher gibt es eine starke Verzerrung hin zu Bildern aus der Perspektive eines Autos, das eine Straße entlangfährt, was sich deutlich von den Bildern unterscheidet, die unser Netz verarbeiten soll. PASCAL 3D hat Annotationen für 3D-Automodelle, aber die Autos sind meist deutlich ältere Modelle, die aus Internetfotos zusammengetragen wurden. Da wir das Automodell vorab kannten, war es nicht nötig, mit Tausenden anderer Modelle zu trainieren (auch wenn wir unser Netz mit mehr Zeit gern auf mehr Automodelle erweitern würden). Und schließlich unterliegen manche Datensätze einer Lizenzbeschränkung auf nicht kommerzielle Nutzung. Wegen dieser Mängel haben wir synthetische Daten als Möglichkeit untersucht, die Daten direkt auf unsere erwartete Testumgebung zuzuschneiden.
Einen synthetischen Auto-Datensatz erstellen
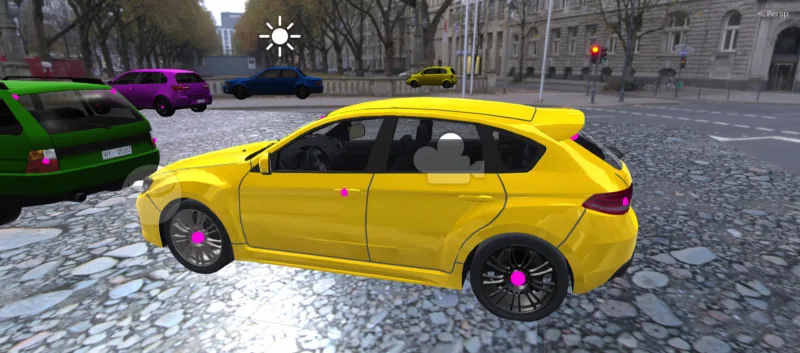
Screenshot des Unity-Editors
Synthetische Daten sind nützlich, wenn es unmöglich oder unpraktisch ist, die große Menge an Trainingsdaten zu erzeugen, die viele Machine-Learning-Methoden benötigen. Dank der Videospielindustrie können wir Grafik-Engines wie Unity oder Unreal Engine zum Rendern nutzen und 3D-Assets verwenden, die ursprünglich für Spiele entwickelt wurden. Auch wenn wir die Renderqualität eines Raytracing-Ansatzes noch nicht erreichen, machen Geschwindigkeit sowie die schiere Menge an Beispielcode und kostenlosen/günstigen Assets diesen Weg sehr attraktiv. Wir haben uns für Unity entschieden, weil wir damit mehr Erfahrung hatten und Zeit ein Faktor war.
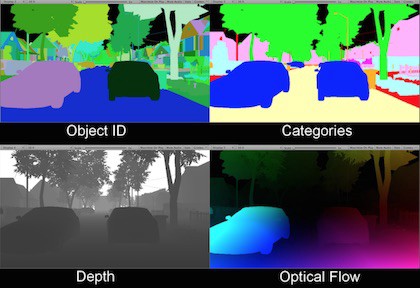
Beispiele für mit Unity synthetisierte Daten
Unity hat sogar ein praktisches Demoprojekt veröffentlicht, das einige häufige Anforderungen rund um synthetische Daten abdeckt. Außerdem haben wir kürzlich einen kurzen Vortrag darüber gehalten, wie man mit SceneKit ein Netz zur Fußsegmentierung für ein AR-Fußballspiel trainiert.
Wir haben etwa 10 Automodelle gesammelt, die in ihrer Form unserem Zielmodell ähnelten, sowie zwei Varianten genau des Autos, an dem wir testeten.
Automodelle finden
Zum Glück gibt es eine ganze Reihe hochwertiger 3D-Automodelle. Für sehr hochwertige Modelle zahlt man vielleicht einige hundert Dollar (siehe https://squir.com/), aber es gibt viele günstige oder kostenlose direkt im Unity Asset Store:
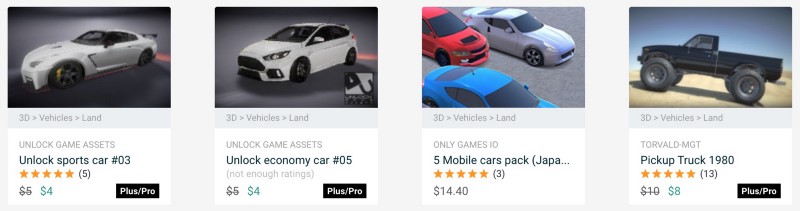
Annotation
Mit den fertigen Modellen bestand der nächste Schritt darin, die Keypoints zu annotieren, die unser Netz erkennen soll. Da das Körperposen-Netz 14 Keypoints hatte, erschien das als vernünftiger Ausgangspunkt, weil sich so Änderungen an der bestehenden Trainingspipeline minimieren ließen. Dieser Schritt erforderte, für jedes Automodell 14 leere Game Objects zu erstellen und zu positionieren:
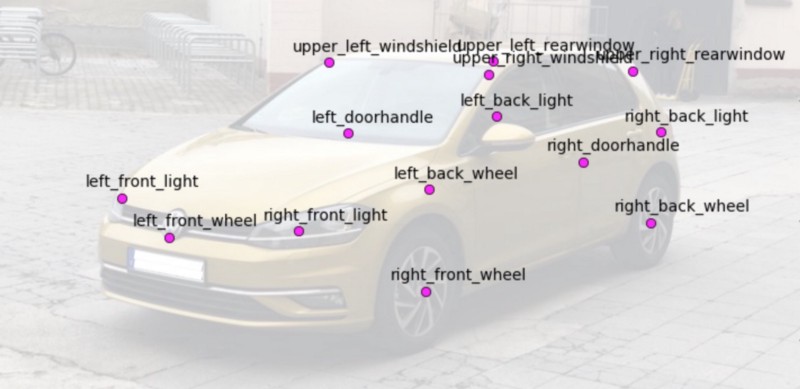
14 Auto-Keypoints
Variationen im Datensatz erzeugen
Eine große Sorge beim Training mit synthetischen Daten ist, ob das Modell auf reale Bilder verallgemeinert. Das ist ein aktives, sich entwickelndes Forschungsgebiet mit vielen interessanten Ansätzen. Das Machine-Learning-Team von Apple hat einen interessanten Beitrag darüber veröffentlicht, wie sich der Realismus synthetischer Augenbilder mit GANs verbessern lässt. Der von uns gewählte Ansatz heißt Domain Randomization. Indem man die Verteilung der Trainingsdaten stark variiert, sollte das Modell ohne Fine-Tuning auf die (reale) Zielverteilung verallgemeinern.
Um das zu erreichen, haben wir versucht, möglichst viele Aspekte der Szene zu randomisieren, bevor ein Bild gerendert wird. Eine große Sorge war von Anfang an, dass das Netz kleine Details der 3D-Automodelle aufgreifen würde, die sich nicht auf Fotos echter Autos übertragen lassen. Es gibt eine oft erwähnte (und möglicherweise unwahre) Anekdote über Forscher, die einen Panzerdetektor trainierten, der lediglich lernte, zu welcher Tageszeit die Panzer im Trainingsdatensatz fotografiert wurden. Ob dieses Beispiel stimmt oder nicht: Wenn Trainings- und Testdaten aus unterschiedlichen Verteilungen stammen, muss man sorgfältig darauf achten, dass die Übertragung auf die neuen Daten gelingt.
Variationen des Autos
Für jedes Automodell haben wir einige Zeit damit verbracht, skriptbare Variationen kleiner Details an der Karosserie zu erstellen. Dazu gehören Lackreflexion, Position und Nummerierung des Kennzeichens, Scheibentönung, Felgenstil und -position und einiges mehr. Außerdem haben wir das Auto selbst entlang seiner lokalen Achsen leicht skaliert.
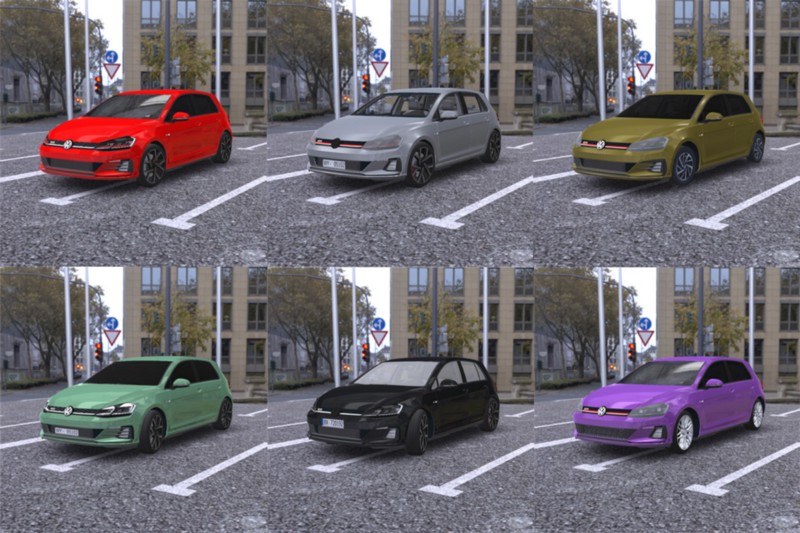
Renderings nur mit Variationen der Karosserie
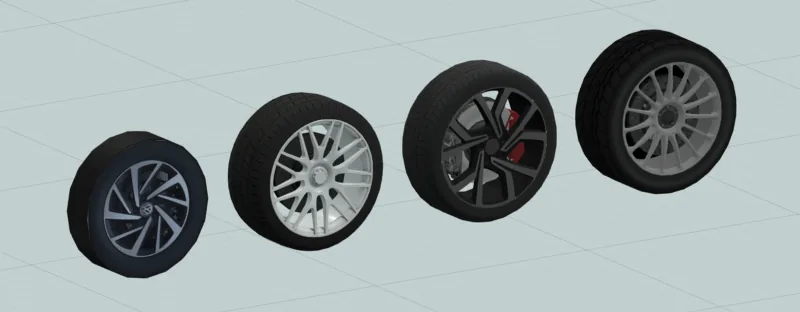
Verschiedene Reifenoptionen
Umgebung / Hintergrund
Anfangs haben wir begonnen, einige Szenen mit Gebäuden und echter 3D-Struktur selbst zu bauen und zu kaufen. Hochwertige fotorealistische Szenen zu finden erwies sich als schwierig und wäre teuer und zeitaufwendig geworden. Zum Glück sind wir auf die großartige Website https://hdrihaven.com/ gestoßen, die kostenlose Umgebungskarten in sehr hoher Auflösung bereitstellt. Das sind im Wesentlichen 360°-HDR-Panoramen, die hinter Ihrer Geometrie gerendert werden und für Objekte in der Szene Beleuchtung und Reflexionen liefern können. Außerdem variieren wir über unsere Rendering-Skripte parametrisch die Intensität von Reflexionen und Belichtung.
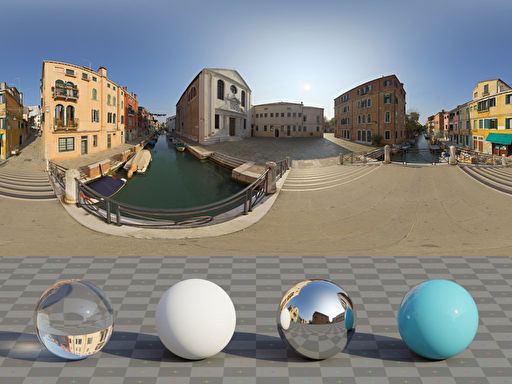
Umgebungskarte von HDRI Haven
Zusammen mit der Skybox haben wir eine einfache Ebene als Boden unter dem Auto erstellt. Das Anwenden verschiedener Materialien auf den Boden und das gelegentliche vollständige Ausblenden sorgen für viel visuelle Vielfalt:
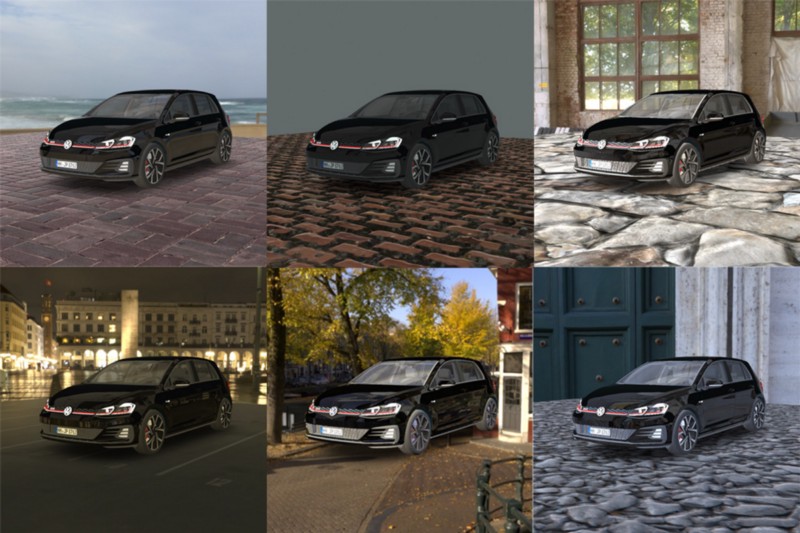
Variationen von Szene und Beleuchtung
Nachbearbeitungseffekte
Unity hat eine Funktion namens „Post Processing Stack“, im Grunde Instagram-Filter für Ihre 3D-Szene. Zu diesen Effekten gehören zum Beispiel Unschärfe, Color Grading usw. Je nach Unity-Version können Sie ihn über den Package Manager oder den Asset Store zu Ihrer Szene hinzufügen. Zusätzlich zum integrierten Post Processing Stack haben wir für 25 $ einen weiteren Satz Filter aus dem Asset Store heruntergeladen, das SC Post Effects Pack. Hier einige Renderings, bei denen nur die Kombination der Nachbearbeitungsfilter variiert wurde:
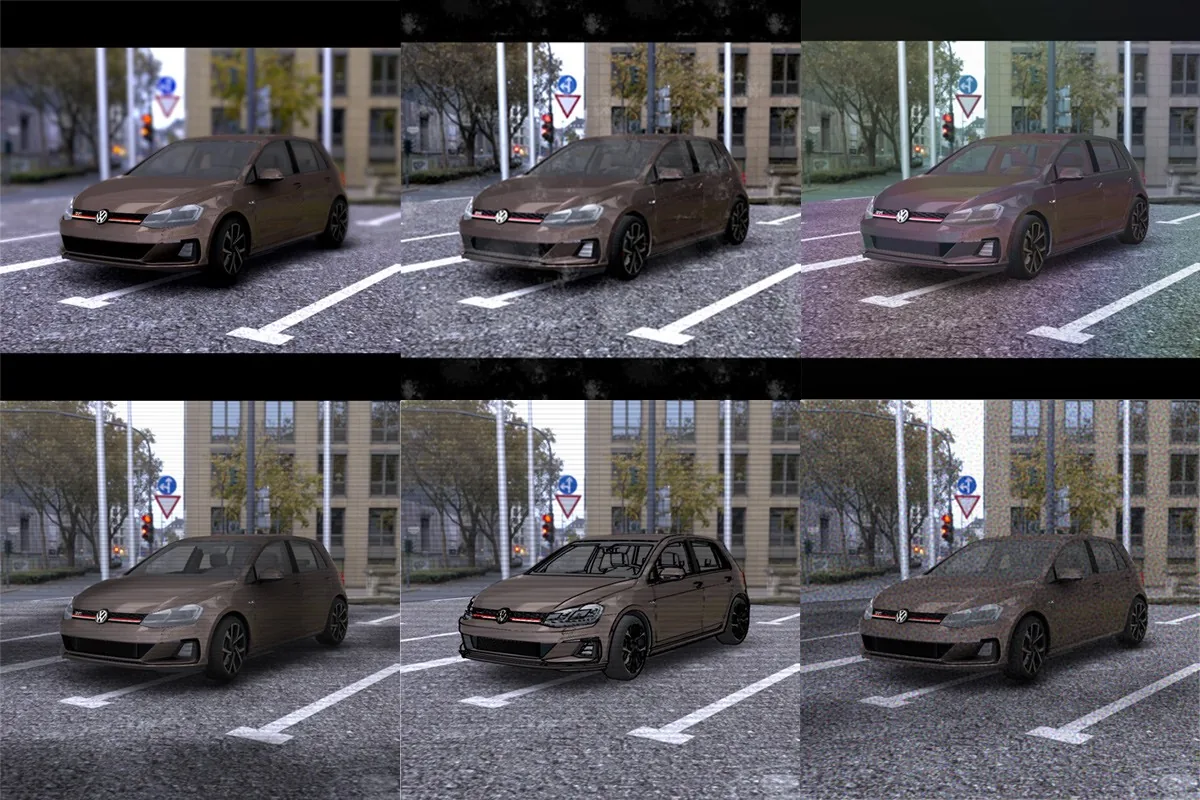
Variationen der Nachbearbeitungsfilter
Die Effekte sind subtil und vielleicht schwer zu erkennen. Zu den hier sichtbaren gehören Tiefenunschärfe, Rauschen, Wolkenschatten, Ambient Occlusion, Kantenhervorhebung, Farbtonverschiebung und schwarze Balken. Bei jedem davon passen wir die Parameter zufällig an, um noch mehr Variationen zu erhalten.
Alles zusammenführen
Wenn wir alle Variationen anwenden, erhalten wir Bilder wie diese:
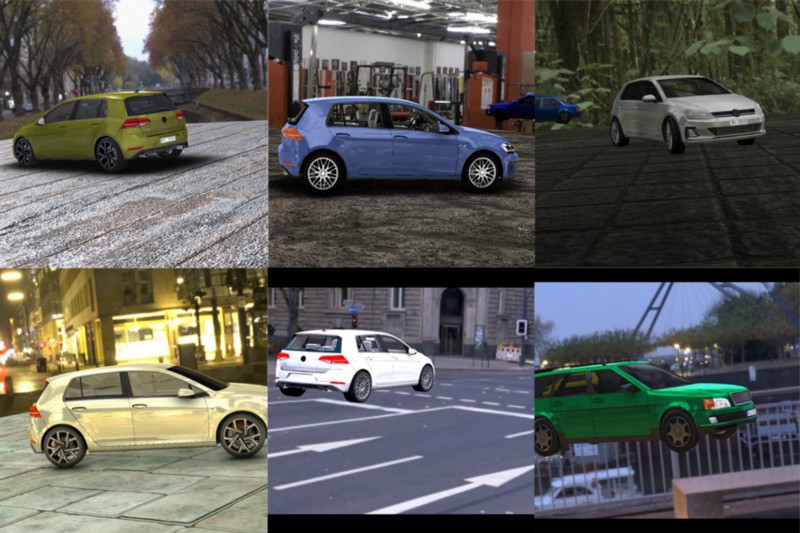
Renderings mit allen aktivierten Variationen
Auch wenn diese nicht wie echte Straßenszenen aussehen, sollten die vielen Variationen von Hintergrund und Beleuchtung das Netz zwingen, sich auf Merkmale des Autos zu stützen, die in allen Fotos konstant bleiben. Hätten wir nur eine Straßenszene verwendet, würde unser Detektor wahrscheinlich Aspekte der Straßenszene in seine Merkmale aufnehmen und erwarten, dass bestimmte Schatten- und Lichteigenschaften stets zum Auto gehören.
Einen kleinen Validierungsdatensatz erstellen
In Python geschriebenes Annotationswerkzeug
Unsere Sorge vor einer Verzerrung im Datensatz führte dazu, dass wir einige echte Autobilder manuell mit 3D-Keypoints annotiert haben. 14 Keypoints einzeln von Hand zu annotieren, ist ziemlich zeitaufwendig, besonders bei verdeckten Keypoints. Um das zu beschleunigen, haben wir eine sehr einfache wxPython-Anwendung zusammengebaut, bei der pro Bild nur wenige Keypoints gelabelt werden müssen. Dazu verwenden wir SolvePnP von OpenCV, um das 3D-Automodell anhand dieser ersten Keypoints anzupassen und die übrigen Keypoints dann ins Bild zu projizieren. Nach der Annotation haben wir mit der Bibliothek imgaug zufällige Bildaugmentierungen angewendet. Zum Glück unterstützt imgaug die Transformation der 2D-Keypoints zusammen mit dem Bild, sodass man die Punktpositionen nicht manuell transformieren muss. Nach der Augmentierung hatten wir etwa 1500 Bilder zur Validierung unseres Netzes.
Funktioniert es?
Für unseren Anwendungsfall mit einer kleinen Menge bekannter Automodelle waren wir mit den Ergebnissen gleich im ersten Durchlauf recht zufrieden. Wir hatten angenommen, mehr reale Bilder ins Training einbeziehen oder stärker auf Transfer Learning setzen zu müssen, doch das war am Ende nicht nötig. Selbst bei Tests an einer ziemlich großen Bandbreite von Autos erhalten wir vernünftige Ergebnisse, wie Sie im Video sehen. Die Anpassung des 3D-Modells funktioniert bei anderen Karosserieformen nicht perfekt, da wir ein starres 3D-Objekt an ein anderes Auto mit anderen Abmessungen anpassen. Es gibt Literatur zum Anpassen eines flexiblen parametrischen Automodells anhand von Keypoints, die wir uns für einen generischeren Autodetektor vielleicht ansehen werden.
Code
Wir planen, einige Teile der Pipeline zu veröffentlichen, wenn wir Zeit finden, sie aufzuräumen und auf mehr Automodellen zu trainieren. Vorerst haben wir den Code für eine Demo einer iOS-App veröffentlicht, die die geschätzte Pose des Autos mit ARKit anzeigt (beachten Sie, dass das Modell auf einen festen Blickwinkelbereich und ein festes Automodell trainiert ist). Wenn Sie eine konkrete Frage zu einem Teil des Projekts haben oder einen individuellen Datensatz oder ein individuelles Modell benötigen, melden Sie sich gern bei uns.
Zusammenarbeit mit Laan Labs
Computer-Vision- & KI-Entwicklung
Individuelle Computer Vision und maschinelles Lernen, vom Proof of Concept bis zur Produktion, auf dem Gerät und in der Cloud.
Diesen Artikel herunterladen
Markdown-Quelltext zum Offline-Lesen herunterladen