Estimation de pose 3D de voitures en temps réel, entraînée sur des données synthétiques

Estimation de la pose de voitures
Estimation de la pose 3D de voitures en conditions réelles avec un iPhone ordinaire
Présentation du projet
Notre client avait imaginé une application qui guiderait les utilisateurs pour qu'ils prennent de meilleures photos de voitures, grâce à des guides en AR et à une prise de vue automatique. Cet article se concentre sur la technologie utilisée pour construire le composant d'estimation de pose de la voiture. Dans l'application, les utilisateurs sont guidés pour se placer à certains angles et à certaines distances de la voiture afin de réaliser les meilleures photos de manière standardisée. Quand l'utilisateur est bien positionné, des photos haute résolution sont capturées automatiquement.
Il nous fallait un moyen de savoir à peu près où se trouve l'utilisateur dans l'espace 3D par rapport à la voiture qu'il photographie. Comme il s'agissait d'un prototype, nous n'avions que quelques semaines pour trouver une solution fonctionnelle. Nous avons aussi limité la reconnaissance à un modèle de voiture précis pour raccourcir le développement.
Objectifs et contraintes
- Délai court pour construire une solution fonctionnelle
- Estimation de la pose de la voiture approximativement en temps réel (< 150 ms)
- Périmètre limité à un modèle de voiture précis, avec des couleurs / options variables
- L'application doit capturer des photos de haute qualité
Ce que nous avons essayé avant de construire du neuf
Dans l'espoir d'une solution prête à l'emploi pour l'estimation de pose d'objets 3D, nous avons testé plusieurs approches.
La reconnaissance d'objets 3D d'ARKit d'Apple
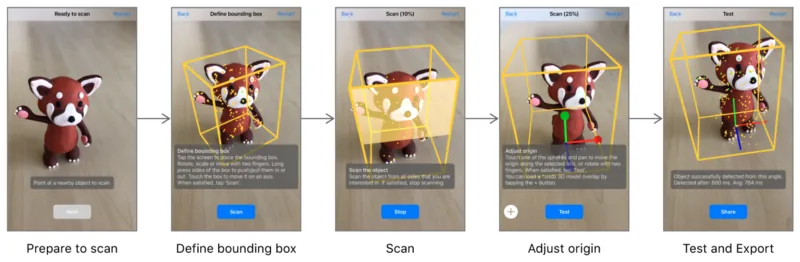
Reconnaissance d'objets ARKit : application de numérisation d'objets
ARKit contient des API pour numériser et reconnaître des objets 3D rigides au sein d'ARKit. Cela nous semblait idéal : en temps réel et intégré à ARKit, cela ramènerait à zéro le temps de développement de cette fonctionnalité. Notre principale préoccupation était la reconnaissance des différentes couleurs de voiture. Pour tester la façon dont ARKit s'en sortait, nous avons acheté une petite voiture miniature en plusieurs couleurs.
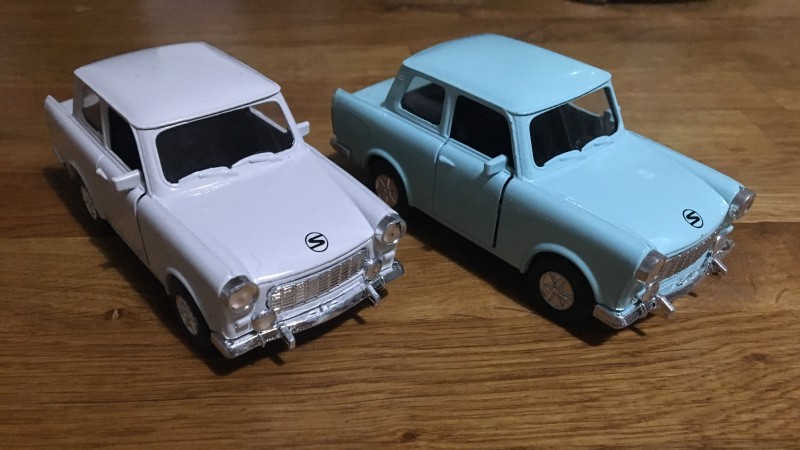
Voitures miniatures pour les tests
Nous avons numérisé une couleur, puis testé sur une couleur proche (par exemple numérisation en blanc, test sur du bleu clair). Dans certains cas, la reconnaissance fonctionnait. Elle n'était pas parfaite, mais peut-être qu'en numérisant un ensemble de couleurs de base, on obtiendrait assez d'invariance pour reconnaître n'importe quelle couleur de voiture que nous pourrions rencontrer.
L'étape suivante a été d'essayer sur de vraies voitures. Il s'est avéré que les vraies voitures se comportaient un peu différemment. Même en numérisant et en testant sur exactement la même voiture, ce n'était pas fiable. Parfois, la voiture reconnue était légèrement tournée ou décalée dans un sens ou dans l'autre. Notre hypothèse est que les peintures très réfléchissantes des voitures compliquent le fonctionnement de la numérisation et de la reconnaissance fondées sur les caractéristiques visuelles (Apple mentionne explicitement dans sa documentation que les objets réfléchissants ne conviennent pas à la reconnaissance 3D).
SDK tiers
Nous avons testé quelques autres SDK et obtenu des résultats similaires à ceux d'ARKit. Certaines bibliothèques exigeaient des « modèles d'initialisation » spécifiques, ou des positions que l'utilisateur doit reproduire pour lancer le suivi de l'objet 3D. Ce n'était pas idéal, car nous voulions guider l'utilisateur vers certaines positions, et la reconnaissance doit donc fonctionner depuis une grande variété d'angles et de positions.
Qualité des photos
Un autre inconvénient, tant d'ARKit que des SDK que nous avons essayés, est la qualité et la résolution des photos qu'ils permettent de capturer. La résolution maximale disponible pour la capture avec ARKit est de 1920x1440. Le contrôle de la mise au point et de l'exposition est lui aussi très limité avec ARKit. Comme toute l'application repose sur la capture de photos de voitures de haute qualité, nous voulions un contrôle fin de la mise au point et de l'exposition, en plus d'une grande résolution d'image.
Construire un estimateur de pose basé sur un réseau de neurones
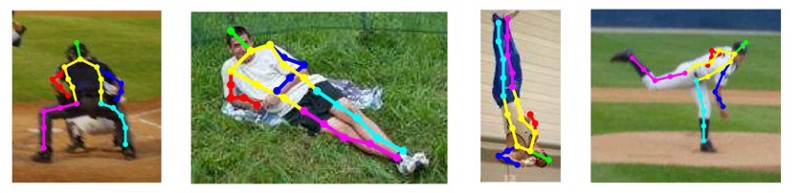
Estimation de pose humaine
Faute de succès avec les solutions tierces, et compte tenu de la limitation sur la qualité des photos, nous avons décidé d'étudier la construction de notre propre solution, qui fonctionnerait aux côtés des API de caméra AVFoundation d'Apple. Nous avons choisi une solution à base de réseau de neurones parce que ces réseaux représentent l'état de l'art pour l'estimation de pose, et qu'il existe de nombreux projets open source et travaux de recherche à exploiter.
Approches de l'estimation de pose
À partir d'une image, comment prédire la pose 3D d'un objet qu'elle contient ? Une approche courante consiste à prédire les positions dans l'image d'un ensemble de points connus d'un modèle canonique de l'objet. Par exemple, à partir d'une photo de voiture, où se trouve le phare gauche dans l'image ? Avec suffisamment de ces prédictions, nous pouvons estimer la pose 3D du modèle de voiture d'origine par rapport à la caméra qui a pris la photo.
Architecture du réseau
De nos jours, les réseaux de neurones affichent une précision impressionnante sur une grande variété de tâches, mais peuvent aussi s'exécuter en temps réel sur des appareils mobiles grâce aux progrès des architectures de réseaux et à des appareils plus rapides.
Nous sommes récemment tombés sur des projets d'estimation de pose du corps humain en temps réel sur mobile, fondés sur les architectures CPM et stacked hourglass.
- https://github.com/edvardHua/PoseEstimationForMobile
- https://github.com/tucan9389/PoseEstimation-CoreML
Ces projets contiennent beaucoup d'informations utiles pour entraîner et exécuter votre propre estimateur de pose sur des plateformes mobiles.
Le réseau CPM qu'ils utilisent a une base MobileNetV2 et produit une carte de chaleur 2D pour chacune des 14 parties du corps (coude gauche, genou droit, etc.)
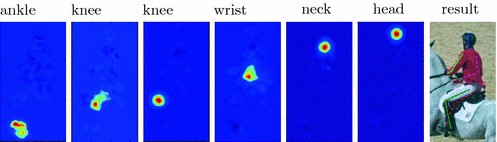
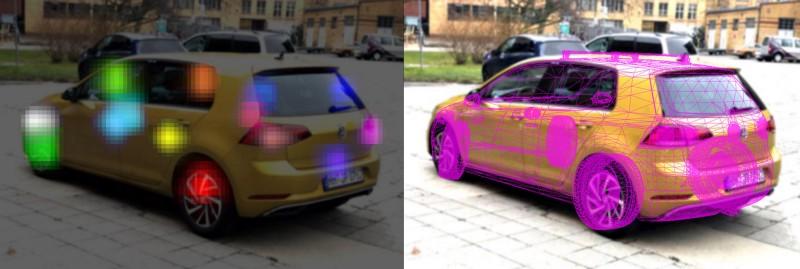
Cartes de chaleur de différentes parties du corps
À partir de là, nous pouvons en gros prendre les positions d'activation maximale de chaque couche de points clés, puis estimer la pose 3D de la voiture avec la méthode SolvePnP d'OpenCV. Voici une visualisation de notre réseau de neurones final exécuté sur une vraie photo de voiture, avec la pose 3D estimée. L'ajustement n'est pas parfait en raison de la résolution limitée des cartes de chaleur en sortie. Notre modèle produit des cartes de chaleur d'une résolution de 192x192, il y a donc une limite à la précision d'une seule passe.
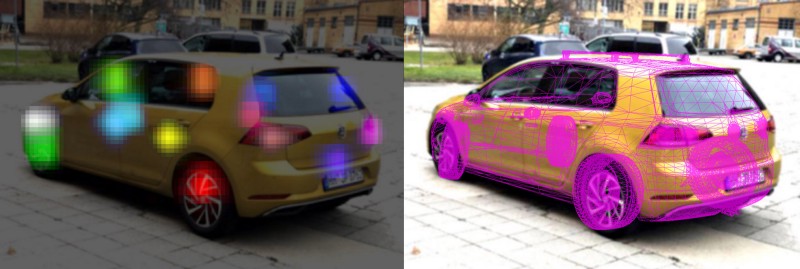
Sortie finale du modèle
Autres approches et ressources
Nous avons retenu CPM pour être opérationnels rapidement, mais il existe d'autres façons de résoudre ce problème. Une autre approche fondée sur les points clés consiste à produire directement les points clés 2D sous la forme d'une liste de coordonnées x,y. Cela nous limite à l'estimation d'une seule voiture, mais pour notre cas d'usage, cela convenait. Inspirés par l'article de Hart Woolery sur l'estimation de la pose de la main, nous avons simplement testé l'ajout de quelques couches denses au-dessus de MobileNet pour produire en sortie un ensemble 1x28 de positions x,y de points clés. Étonnamment, cela a plutôt bien fonctionné d'emblée. Avec plus de temps, nous explorerions peut-être davantage ce réseau, car il était légèrement plus rapide que le modèle CPM que nous avons choisi.
Si vous cherchez uniquement de l'estimation de pose humaine, consultez le récent article de Jameson Toole sur l'estimateur de pose humaine de fritz.ai : https://heartbeat.fritz.ai/pose-estimation-on-ios-with-fritz-60c8e5f7d195
Une autre méthode consiste à faire produire directement au réseau les paramètres de pose de la voiture, sans passer par des points clés 2D intermédiaires (voir BoxCars, MultiBin). Vu le calendrier serré, nous n'avons pas évalué rigoureusement toutes les directions possibles, mais ces autres approches semblent parfaitement valables.
À la recherche d'un jeu de données de voitures
Une fois l'architecture du réseau choisie, l'étape suivante est de trouver un jeu de données pour l'entraîner. Les jeux de données pour l'estimation de pose du corps humain ne manquent pas (COCO, DensePose, MPII, aperçu des jeux de données de pose du corps), mais les données annotées de voitures sont un peu plus rares. Quelques jeux de données existent (Apollo, PASCAL 3d+), mais chacun semblait avoir ses propres limites. La plupart sont orientés vers les voitures autonomes, avec donc un fort biais vers des images prises du point de vue d'une voiture qui roule dans la rue, ce qui serait très différent des images que nous attendons de notre réseau. PASCAL 3D contient des annotations de modèles 3D de voitures, mais il s'agit généralement de modèles bien plus anciens, collectés à partir de photos trouvées sur Internet. Comme nous connaissions le modèle de voiture à l'avance, il n'était pas nécessaire de s'entraîner sur des milliers d'autres modèles (même si, avec plus de temps, nous aimerions étendre notre réseau à la reconnaissance de davantage de modèles). Enfin, certains jeux de données sont soumis à une licence interdisant l'usage commercial. Face à ces insuffisances, nous avons exploré les données synthétiques pour adapter les données directement à l'environnement de test attendu.
Créer un jeu de données synthétique de voitures
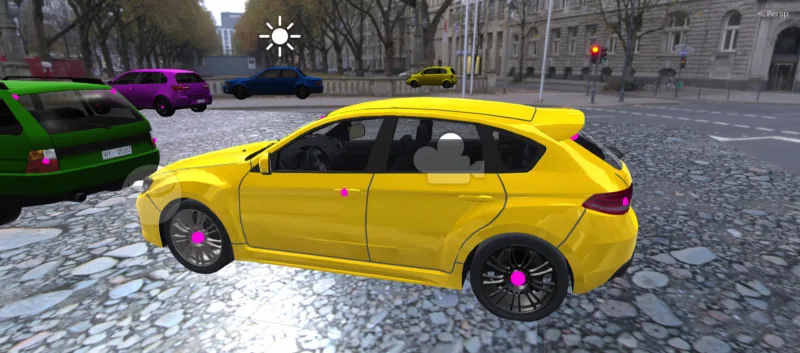
Capture d'écran de l'éditeur Unity
Les données synthétiques sont précieuses lorsqu'il est impossible ou peu pratique de générer la grande quantité de données d'entraînement que requièrent de nombreuses méthodes de machine learning. Grâce à l'industrie du jeu vidéo, nous pouvons tirer parti de moteurs graphiques comme Unity ou Unreal Engine pour le rendu, et utiliser des assets 3D développés à l'origine pour des jeux. Même si nous n'obtenons pas encore la qualité de rendu d'une approche par lancer de rayons, la vitesse, l'abondance d'exemples de code et d'assets gratuits ou bon marché la rendent très séduisante. Nous avons choisi Unity parce que nous le connaissions mieux et que le temps comptait.
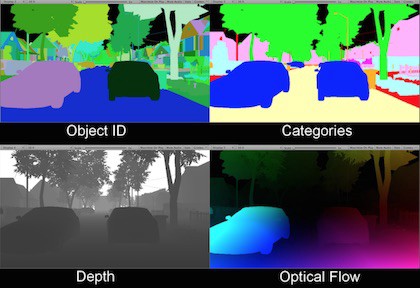
Exemples de données synthétisées avec Unity
Unity a même publié un projet de démonstration pratique répondant à quelques besoins courants autour des données synthétiques. Nous avons aussi donné récemment une courte présentation sur l'entraînement d'un réseau de segmentation de pieds pour un jeu de football en AR avec SceneKit.
Nous avons rassemblé une dizaine de modèles de voitures de forme proche de notre modèle cible, ainsi que deux variantes de la voiture exacte sur laquelle nous testions.
Trouver des modèles de voitures
Heureusement, il existe pas mal de modèles 3D de voitures de grande qualité. Pour des modèles de très haute qualité, il peut falloir débourser quelques centaines de dollars (voir https://squir.com/), mais beaucoup sont bon marché ou gratuits directement sur l'Asset Store d'Unity :
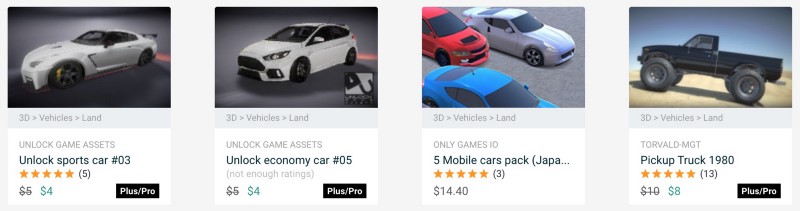
Asset Store d'Unity - Véhicules
Annotation
Les modèles étant prêts, l'étape suivante a été d'annoter les points clés que notre réseau doit apprendre à reconnaître. Comme le réseau de pose du corps humain comptait 14 points clés, cela semblait un bon point de départ, car cela réduisait les modifications à apporter à la chaîne d'entraînement existante. Cette étape a consisté à créer 14 objets de jeu vides et à les positionner pour chaque modèle de voiture :
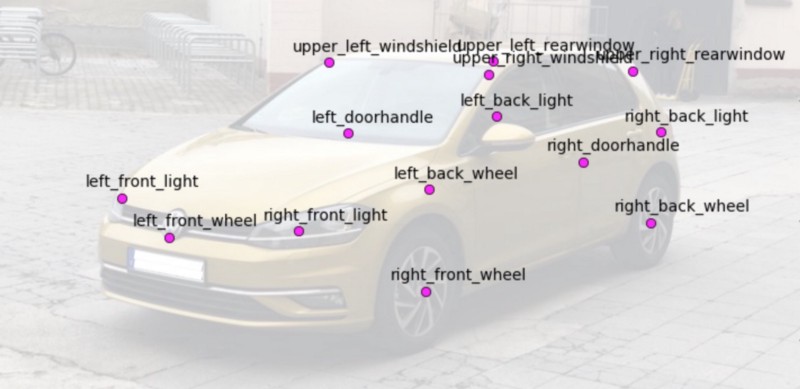
14 points clés de la voiture
Créer des variations dans le jeu de données
Une grande inquiétude, quand on s'entraîne sur des données synthétiques, est de savoir si le modèle généralisera aux images du monde réel. C'est un domaine de recherche actif et en évolution, avec de nombreuses approches intéressantes. L'équipe de machine learning d'Apple a publié un article intéressant sur l'amélioration du réalisme d'images synthétiques d'yeux avec des GAN. L'approche que nous avons choisie s'appelle la randomisation de domaine. En créant beaucoup de variations dans la distribution des données d'entraînement, le modèle devrait généraliser à la distribution cible (le monde réel) sans aucun affinage.
Pour y parvenir, nous avons essayé de randomiser le plus d'aspects possible de la scène avant de rendre une image. Une grande crainte au départ était que le réseau apprenne à capter de petits détails des modèles 3D de voitures qui ne se généraliseraient pas aux photographies de vraies voitures. On cite souvent (sans doute à tort) l'anecdote de chercheurs qui entraînaient un détecteur de chars et dont le réseau avait simplement appris à reconnaître l'heure de la journée à laquelle les chars de l'ensemble d'entraînement avaient été photographiés. Que cet exemple soit vrai ou non, lorsque les jeux d'entraînement et de test proviennent de distributions différentes, il faut veiller à ce que le résultat se transfère aux nouvelles données.
Variations de la voiture
Pour chaque modèle de voiture, nous avons passé du temps à créer des variations scriptables de petits détails de la carrosserie : réflectivité de la peinture, position et numérotation de la plaque d'immatriculation, teinte des vitres, style et position des jantes, et quelques autres. Nous avons aussi légèrement mis la voiture à l'échelle le long de ses axes locaux.
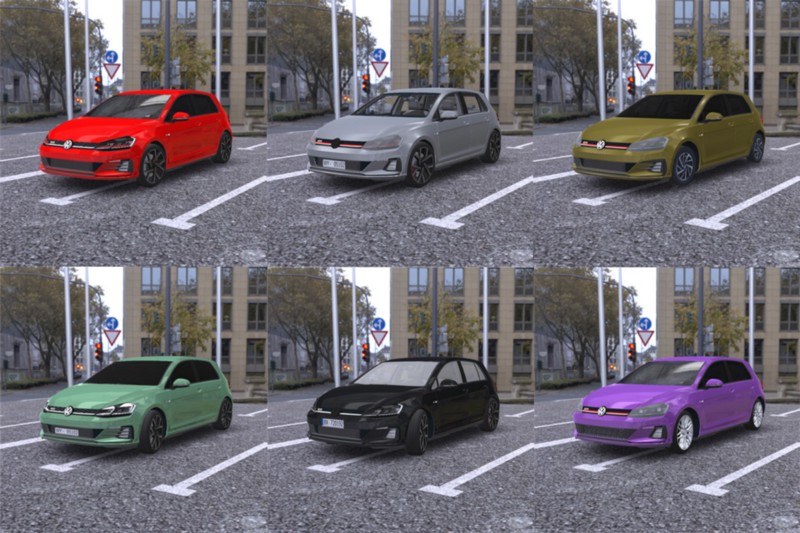
Rendus des seules variations de carrosserie
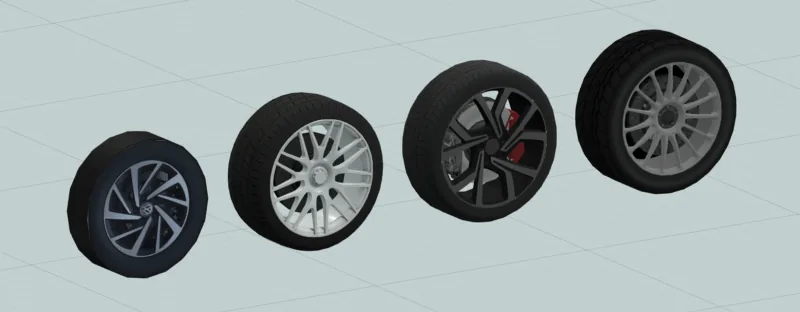
Différentes options de pneus
Environnement / arrière-plan
Au départ, nous avons commencé à construire et à acheter quelques scènes comportant des bâtiments et une vraie structure 3D. Trouver des scènes photoréalistes de grande qualité s'avérait difficile, et cela devenait coûteux et chronophage. Heureusement, nous sommes tombés sur un excellent site, https://hdrihaven.com/, qui propose gratuitement des cartes d'environnement en très haute résolution. Ce sont essentiellement des panoramas HDR à 360° rendus derrière la géométrie, qui peuvent fournir l'éclairage et les reflets des objets de la scène. Nous faisons aussi varier de façon paramétrique l'intensité des reflets et de l'exposition via nos scripts de rendu.
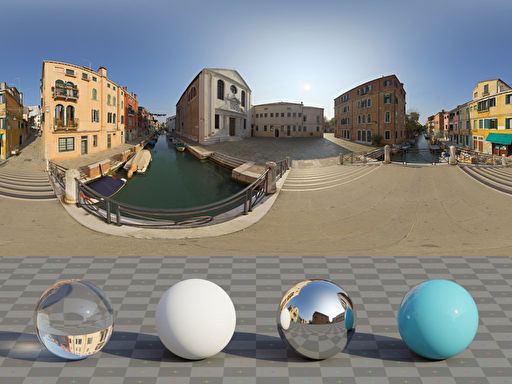
Carte d'environnement de HDRI Haven
En plus de la skybox, nous avons créé un simple plan servant de sol sous la voiture. Appliquer différents matériaux au sol, et parfois le masquer complètement, apporte beaucoup de diversité visuelle :
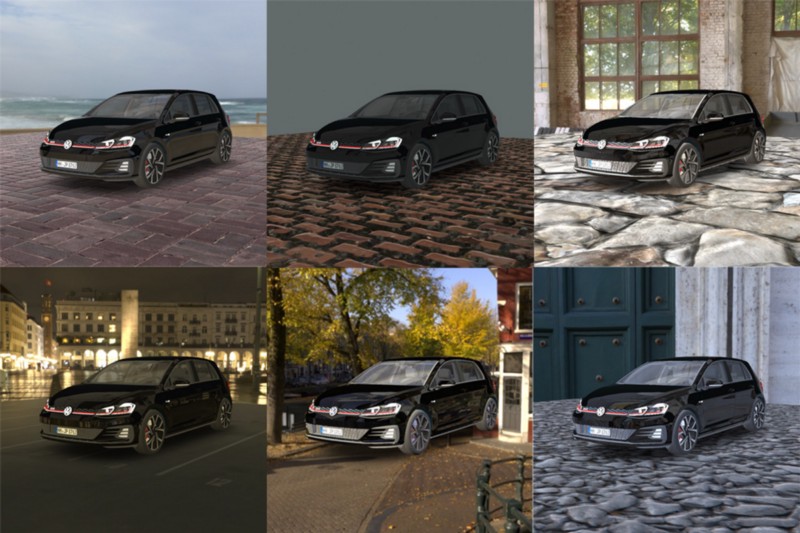
Variations de scène et d'éclairage
Effets de post-traitement
Unity propose une fonctionnalité appelée « Post Processing Stack », qui équivaut en gros à des filtres Instagram pour votre scène 3D. Ces effets peuvent inclure le flou, l'étalonnage des couleurs, etc. On peut l'ajouter à sa scène via le Package Manager ou l'Asset Store, selon la version d'Unity. En plus de la pile de post-traitement intégrée, nous avons téléchargé un autre ensemble de filtres sur l'Asset Store, le SC Post Effects Pack, pour 25 $. Voici quelques rendus où seule la combinaison de filtres de post-traitement varie :
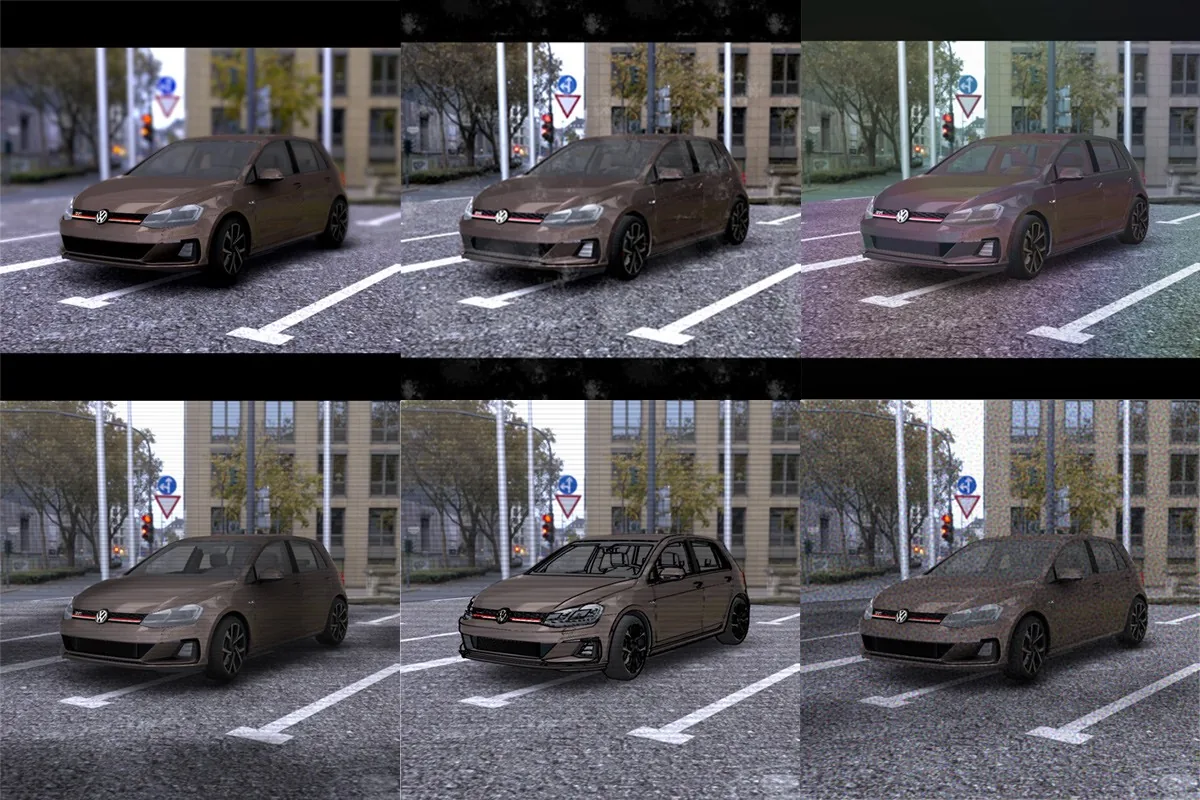
Variations de filtres de post-traitement
Les effets sont subtils et peuvent être difficiles à repérer. Parmi ceux que l'on voit ici : profondeur de champ, bruit, ombres de nuages, occlusion ambiante, rehaussement des contours, décalage de teinte et bandes noires. Pour chacun, nous ajustons aussi aléatoirement les paramètres pour obtenir encore plus de variations.
Tout assembler
En appliquant toutes les variations, nous obtenons des images comme celles-ci :
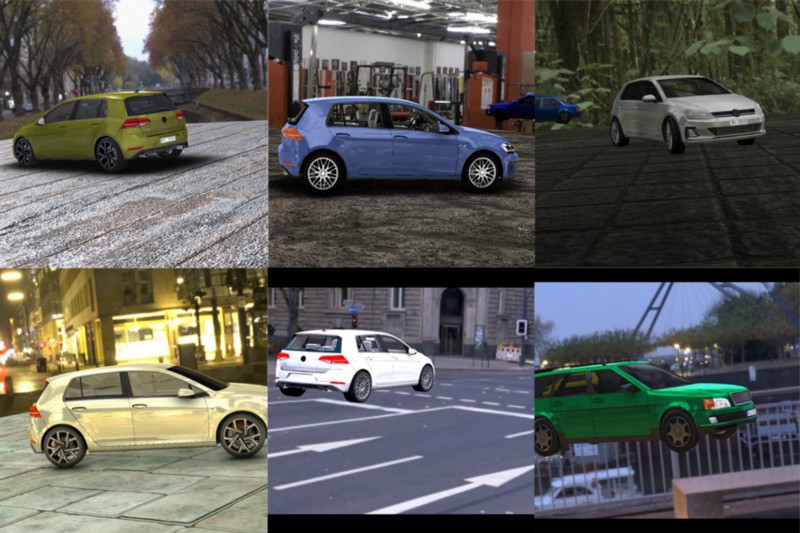
Rendus avec toutes les variations activées
Même si elles ne ressemblent pas à de vraies scènes de rue, les nombreuses variations de l'arrière-plan et de l'éclairage devraient forcer le réseau à capter les caractéristiques de la voiture qui restent constantes sur toutes les photos. Si nous n'avions utilisé qu'une scène de rue, notre détecteur intégrerait probablement des aspects de cette scène dans ses caractéristiques, en s'attendant à ce que certaines caractéristiques d'ombre et d'éclairage accompagnent toujours la voiture elle-même.
Créer un petit jeu de données de validation
Outil d'annotation écrit en Python
Notre inquiétude concernant le biais du jeu de données nous a conduits à annoter manuellement quelques images réelles de voitures avec des points clés 3D. Annoter manuellement 14 points clés un par un est assez long, surtout pour les points clés occultés. Pour aller plus vite, nous avons bricolé une application wxPython très basique qui n'exige d'annoter que quelques points clés par image. Pour cela, nous utilisons la fonction SolvePnP d'OpenCV pour ajuster le modèle 3D de la voiture à partir de ces points clés initiaux, puis projeter les autres points clés dans l'image. Une fois les images annotées, nous avons appliqué des augmentations d'image aléatoires avec la bibliothèque imgaug. Heureusement, imgaug permet de transformer les points clés 2D en même temps que l'image, ce qui évite de transformer à la main la position des points. Après augmentation, nous disposions d'environ 1500 images pour valider notre réseau.
Est-ce que ça marche ?
Pour notre cas d'usage, un petit ensemble de modèles de voitures connus, nous avons été très satisfaits des résultats dès le premier essai. Nous pensions devoir intégrer davantage d'images réelles à l'entraînement, ou nous appuyer plus sur l'apprentissage par transfert, mais cela n'a finalement pas été nécessaire. Même en testant sur un éventail assez large de voitures, les résultats restent raisonnables, comme on peut le voir dans la vidéo. L'ajustement du modèle 3D ne fonctionne pas parfaitement sur d'autres formes de voitures, puisque nous ajustons un objet 3D rigide à une autre voiture aux dimensions différentes. Il existe des travaux sur l'ajustement d'un modèle paramétrique flexible de voiture à partir de points clés, et nous nous y intéresserons peut-être pour un détecteur de voitures plus générique.
Code
Nous prévoyons de publier certains aspects de la chaîne de traitement si nous trouvons le temps de la nettoyer et de l'entraîner sur davantage de modèles de voitures. Pour l'instant, nous avons mis en ligne le code d'une application iOS de démonstration qui affiche la pose estimée de la voiture avec ARKit (gardez à l'esprit que le modèle est entraîné sur une plage de points de vue et un modèle de voiture fixes). Si vous avez une question précise sur une partie du projet, ou si vous avez besoin d'un jeu de données ou d'un modèle sur mesure, faites-nous signe.
Travailler avec Laan Labs
Développement de vision par ordinateur et d’IA
De la vision par ordinateur et du machine learning sur mesure, de la preuve de concept à la production, sur l’appareil comme dans le cloud.
Télécharger cet article
Récupérez la source Markdown pour le lire hors ligne