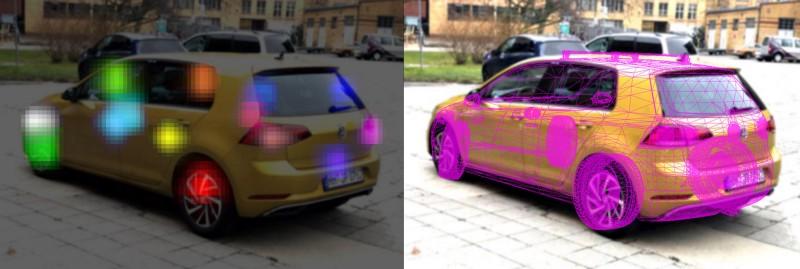
基于合成数据训练的实时 3D 车辆姿态估计

估计车辆姿态
用一部普通 iPhone 在真实环境中估计车辆的 3D 姿态
项目概述
我们的客户设想了一款应用:通过 AR 引导和自动拍照,引导用户拍出质量更高的汽车照片。本文重点介绍构建车辆姿态估计组件所用到的技术。在这款应用中,用户会被引导站在距离汽车特定的角度和距离上,以标准化的方式拍出最佳照片。当用户处于正确位置时,应用会自动拍摄高分辨率照片。
**我们需要一种方法,大致知道用户相对于所拍摄的汽车站在 3D 空间中的什么位置。**由于这是一个原型应用,我们只有几周时间来拿出可用的方案。为了缩短开发周期,我们还把识别范围限定在某一款特定车型上。
目标与约束
- 构建可用方案的时间很短
- 大致实时的车辆姿态估计(< 150 毫秒)
- 范围限定在某一款车型,但颜色 / 配置各不相同
- 应用应能拍出高质量照片
在自己动手之前我们尝试过什么
我们希望能找到现成的快速方案来做 3D 物体姿态估计,因此测试了几种方法。
Apple ARKit 的 3D 物体识别
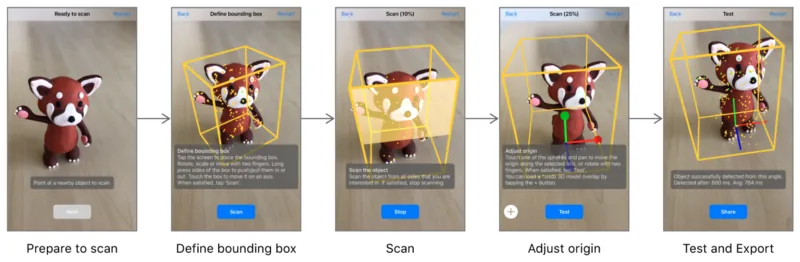
ARKit 物体识别:物体扫描应用
ARKit 包含可以在 ARKit 中扫描和识别刚性 3D 物体的 API。这对我们来说似乎很理想:它是实时的,而且内置于 ARKit,这项功能的开发时间就可以降到零。我们主要担心的是识别不同颜色的车。为了测试 ARKit 在这方面的表现,我们买了几种不同颜色的小型模型车。
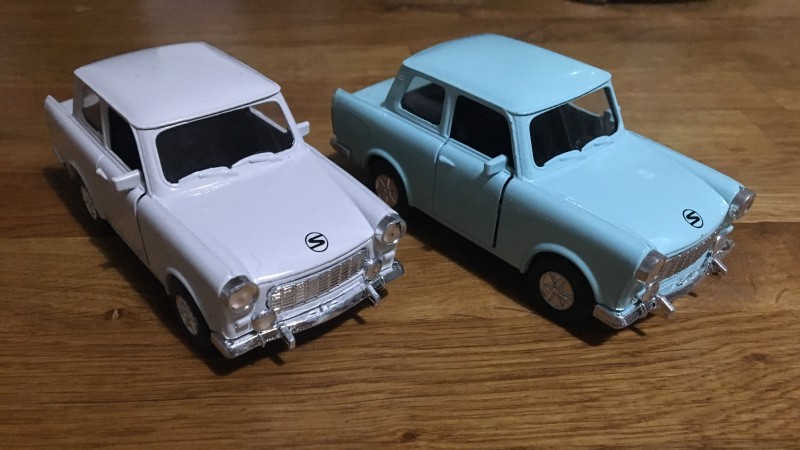
用于测试的模型车
我们扫描了一种颜色,然后用相近的颜色测试(比如扫描白色,测试浅蓝色)。有些情况下识别确实有效。它并不完美,但也许只要扫描一组基础颜色,就能提供足够的不变性,识别出我们可能遇到的任何颜色的这款车。
下一步是在真车上试验。结果发现真车的表现有些不同。即使扫描和测试用的是同一辆车,也不可靠。有时识别出的车会朝某个方向略微旋转 / 平移。我们猜测,汽车上高反光的漆面使得基于特征的扫描和识别难以奏效(Apple 在文档中明确提到,反光物体不适合 3D 识别。)
第三方 SDK
我们还测试了其他几个 SDK,得到的结果与 ARKit 类似。有些库需要特定的“初始化模板”,或者要求用户对准某些位置才能启动 3D 物体跟踪。这并不理想,因为我们想引导用户到特定位置,所以识别必须能在各种不同的角度 / 位置下工作。
照片质量
ARKit 和我们试用的这些 SDK 还有一个缺点,就是使用它们时能拍到的照片质量和分辨率。使用 ARKit 时可用的最高拍摄分辨率是 1920x1440。同时,使用 ARKit 时对对焦和曝光的控制也非常有限。由于这款应用的核心就是拍出高质量的汽车照片,我们希望除了高图像分辨率之外,还能精细控制对焦和曝光。
构建基于神经网络的姿态估计器
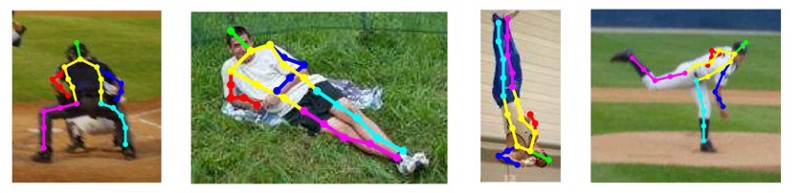
人体姿态估计
鉴于使用第三方方案没有成功,再加上照片质量的限制,我们决定研究自己构建一套能与 Apple 的 AVFoundation 相机 API 配合使用的方案。我们选择神经网络方案,是因为它们是姿态估计领域的最先进技术,而且有大量开源项目和研究成果可以借鉴。
姿态估计的方法
给定一张图像,我们如何预测图像中某个物体的 3D 姿态?一种常见的做法是,预测物体标准模型上一组已知点在图像中的位置。例如,给定一张汽车照片,左前大灯在图像中的什么位置?有了足够多这样的预测,我们就可以估计出原始汽车模型相对于拍摄照片的相机的 3D 姿态。
网络架构
如今,神经网络在各种各样的任务上都展现出令人印象深刻的准确率,同时得益于网络架构的改进和设备性能的提升,它们还能在移动设备上实时运行。
最近我们发现了一些基于 CPM 和堆叠沙漏网络(stacked hourglass)架构的实时移动端人体姿态估计项目。
- https://github.com/edvardHua/PoseEstimationForMobile
- https://github.com/tucan9389/PoseEstimation-CoreML
这些项目包含大量有用的信息,可供你在移动平台上训练和运行自己的姿态估计器。
它们使用的 CPM 网络以 MobileNetV2 为基础,为 14 个身体部位(左肘、右膝等)各输出一张 2D 热力图
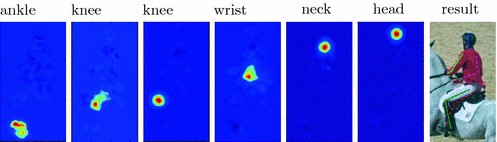
各身体部位的热力图
接下来,我们基本上只需取每个关键点图层的最大激活位置,然后用 OpenCV 的 SolvePnP 方法估计出车辆的 3D 姿态。下图是我们最终的神经网络在一张真实汽车照片上运行的可视化结果,以及估计出的 3D 姿态。由于输出热力图的分辨率有限,拟合并不完美。我们的模型输出的热力图分辨率为 192x192,所以单次推理的准确度存在上限。
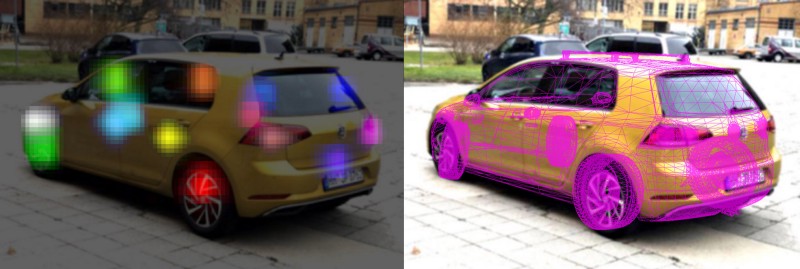
模型的最终输出
其他方法与资源
我们选择 CPM 是为了快速上手,但还有其他方式可以解决这个问题。另一种基于关键点的方法,是直接把 2D 关键点输出为一个 x,y 坐标列表。这样确实只能估计一辆车,但对我们的用例来说没问题。受 Hart Woolery 关于手部姿态估计的文章启发,我们测试了在 MobileNet 之上简单加几层全连接层,最终输出 1x28 的 x,y 关键点位置集合。出人意料的是,这个方案开箱即用效果就相当不错。如果有更多时间,我们可能会进一步探索这个网络,因为它比我们选用的 CPM 模型稍快一些。
如果你只是想做人体姿态估计,可以看看 Jameson Toole 最近关于 fritz.ai 人体姿态估计器的文章:https://heartbeat.fritz.ai/pose-estimation-on-ios-with-fritz-60c8e5f7d195
还有一种方法是让网络直接输出汽车的姿态参数,而不经过中间的 2D 关键点(参见 BoxCars、MultiBin)。由于时间紧迫,我们没有严格评估所有可能的方向,不过这些其他方法看起来完全可行。
寻找汽车数据集
选定网络架构之后,下一步是找到可以用来训练它的数据集。人体姿态估计的数据集并不缺(COCO、DensePose、MPII、人体姿态数据集概览),但带标注的汽车数据就没那么常见了。确实存在一些数据集(Apollo、PASCAL 3d+),但每个似乎都有自己的局限。大多数数据集面向自动驾驶汽车,所以严重偏向于行驶在街道上的汽车视角所拍摄的图像,这与我们期望网络处理的图像会大不相同。PASCAL 3D 有 3D 汽车模型标注,但那些车通常是从网络照片中收集的更老的车型。由于我们事先就知道车型,没有必要在成千上万的其他车型上训练(不过如果有更多时间,我们希望把网络扩展到能识别更多车型。)最后,有些数据集还有非商业许可的限制。鉴于这些不足,我们探索了用合成数据,作为让数据直接贴合预期测试环境的办法。
创建合成汽车数据集
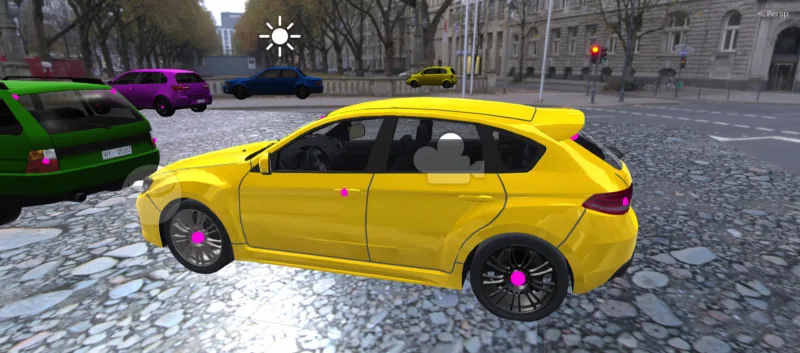
Unity 编辑器截图
当许多机器学习方法所需的大量训练数据无法生成或生成起来不切实际时,合成数据就派上了用场。得益于电子游戏行业,我们可以利用 Unity 或 Unreal Engine 之类的图形引擎来渲染,并使用最初为游戏开发的 3D 资产。虽然我们暂时还达不到光线追踪方案的渲染质量,但速度快、示例代码数量庞大,再加上免费 / 廉价的资产,使它非常有吸引力。我们选择了 Unity,因为我们对它更有经验,而且时间也是一个因素。
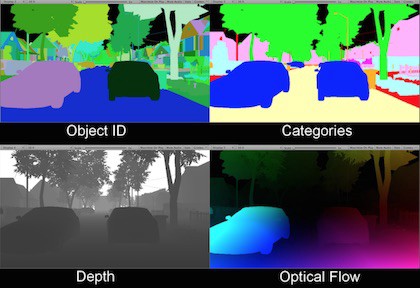
用 Unity 合成的数据示例
Unity 甚至发布了一个实用的演示项目,涵盖了合成数据的一些常见需求。我们最近还做了一个简短的演讲,介绍如何用 SceneKit 为一款 AR 足球游戏训练脚部分割网络。
我们收集了大约 10 款外形与目标车型相近的汽车模型,以及两款与我们测试用的那辆车完全一致的变体。
寻找汽车模型
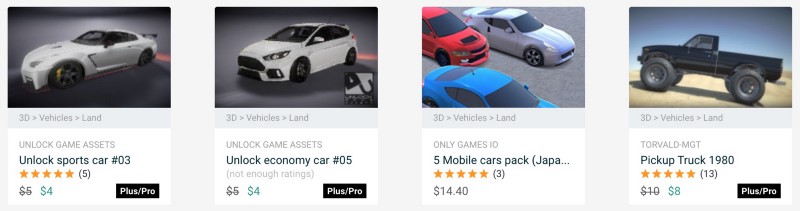
幸运的是,市面上有不少高质量的 3D 汽车模型。非常高质量的模型可能要花几百美元(见 https://squir.com/),但也有很多廉价或免费的模型可以直接从 Unity 资源商店获得:
标注
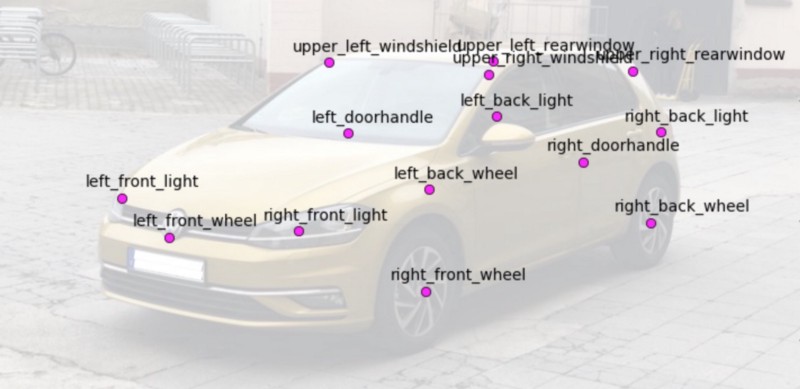
模型准备好之后,下一步是标注我们要训练网络识别的关键点。由于人体姿态网络有 14 个关键点,这看起来是个合理的起点,因为这样可以减少对现有训练流水线的改动。这一步需要为每个汽车模型创建 14 个空的游戏对象,并摆放到相应位置:
14 个汽车关键点
在数据集中制造变化
用合成数据训练时,一个很大的担忧是模型能否泛化到真实世界的图像。这是一个活跃且不断发展的研究领域,有许多有趣的方法。Apple 的机器学习团队有一篇有趣的文章,讲的是用 GAN 提升合成眼部图像的真实感。我们选择的方法叫做域随机化(domain randomization)。通过在训练数据分布中制造大量变化,模型应当无需任何微调就能泛化到目标(真实世界)分布。
为了实现这一点,我们在渲染图像之前,尽量随机化场景的方方面面。一开始我们特别担心的是,网络会学到 3D 汽车模型上某些细枝末节的特征,而这些特征无法泛化到真实汽车的照片上。有一则经常被提起的轶事(可能并不属实):研究人员训练了一个坦克检测器,结果它只学会了训练集中坦克是在一天中的什么时间拍摄的。不管这个例子是否属实,当训练集和测试集来自不同的分布时,都需要格外小心,确保能迁移到新的数据上。
汽车变体
对于每个汽车模型,我们花了一些时间为车身上的细节创建可脚本化的变体,比如漆面反光度、车牌位置和号码、车窗贴膜、轮毂样式和位置,以及其他一些方面。我们还沿汽车自身的局部坐标轴对车体做了轻微缩放。
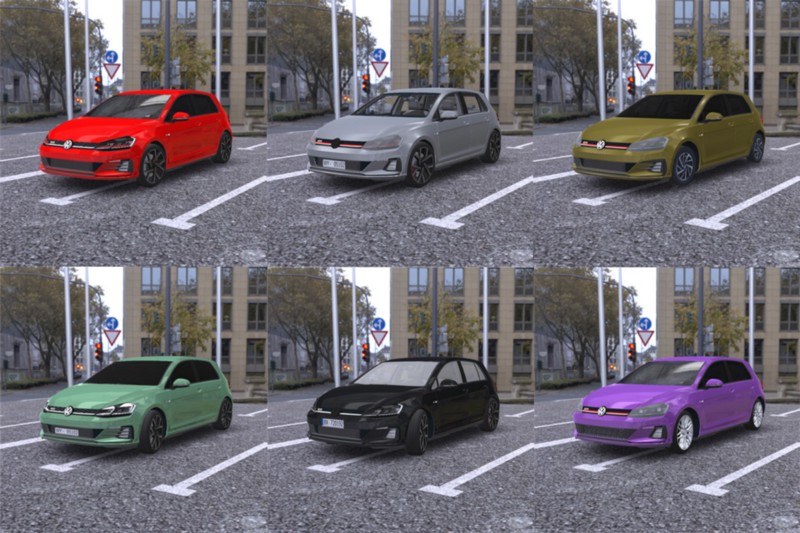
仅车身变体的渲染图
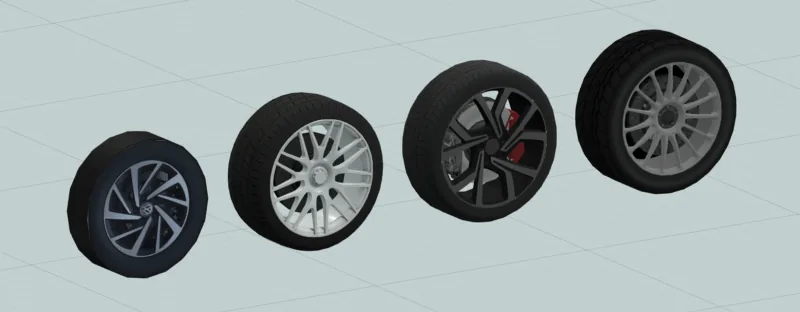
不同的轮胎选项
环境 / 背景
起初,我们开始自己搭建并购买一些包含建筑物和真实 3D 结构的场景。事实证明,找到高质量的照片级真实感场景很困难,而且会变得昂贵、耗时。幸运的是,我们发现了一个很棒的网站 https://hdrihaven.com/,它提供超高分辨率的免费环境贴图。这些本质上是渲染在几何体背后的 360 HDR 全景图,可以为场景中的物体提供光照和反射。我们还通过渲染脚本对反射和曝光强度进行参数化的变化。
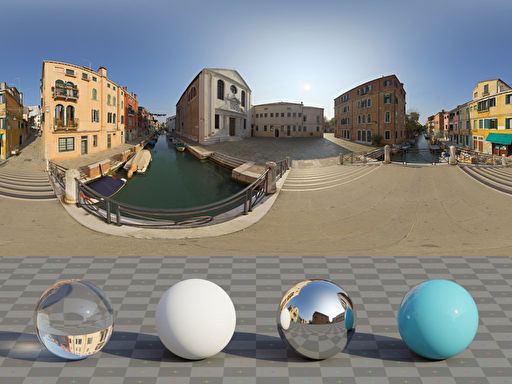
来自 HDRI Haven 的环境贴图
除了天空盒,我们还在车下创建了一个简单的平面作为地面。为地面应用不同的材质,并偶尔把它完全隐藏,就能带来大量的视觉多样性:
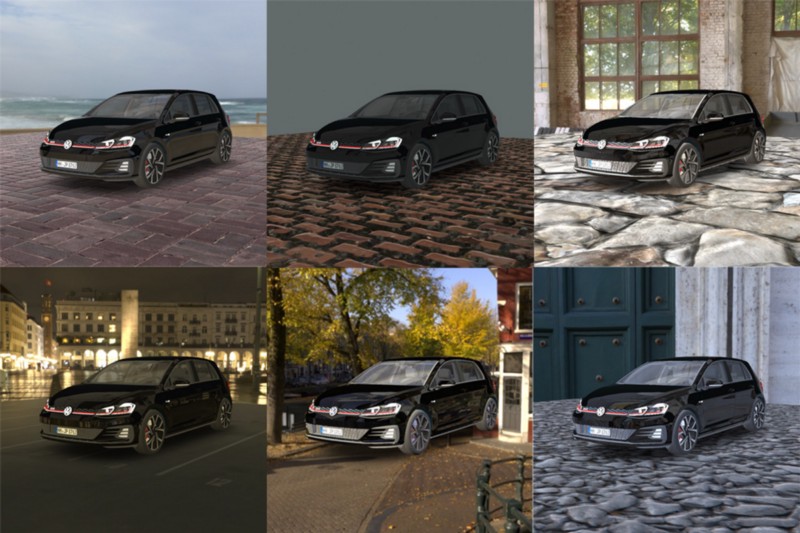
场景与光照变化
后期处理效果
Unity 有一个叫“后期处理堆栈(Post Processing Stack)”的功能,基本上就是针对 3D 场景的 instagram 滤镜。这些效果可能包括模糊、调色等。根据你的 Unity 版本,可以通过包管理器或资源商店把它添加到场景中。除了内置的后期处理堆栈,我们还花 25 美元从资源商店下载了另一组滤镜,名为 SC Post Effects Pack。下面是几张仅改变后期处理滤镜组合的渲染图:
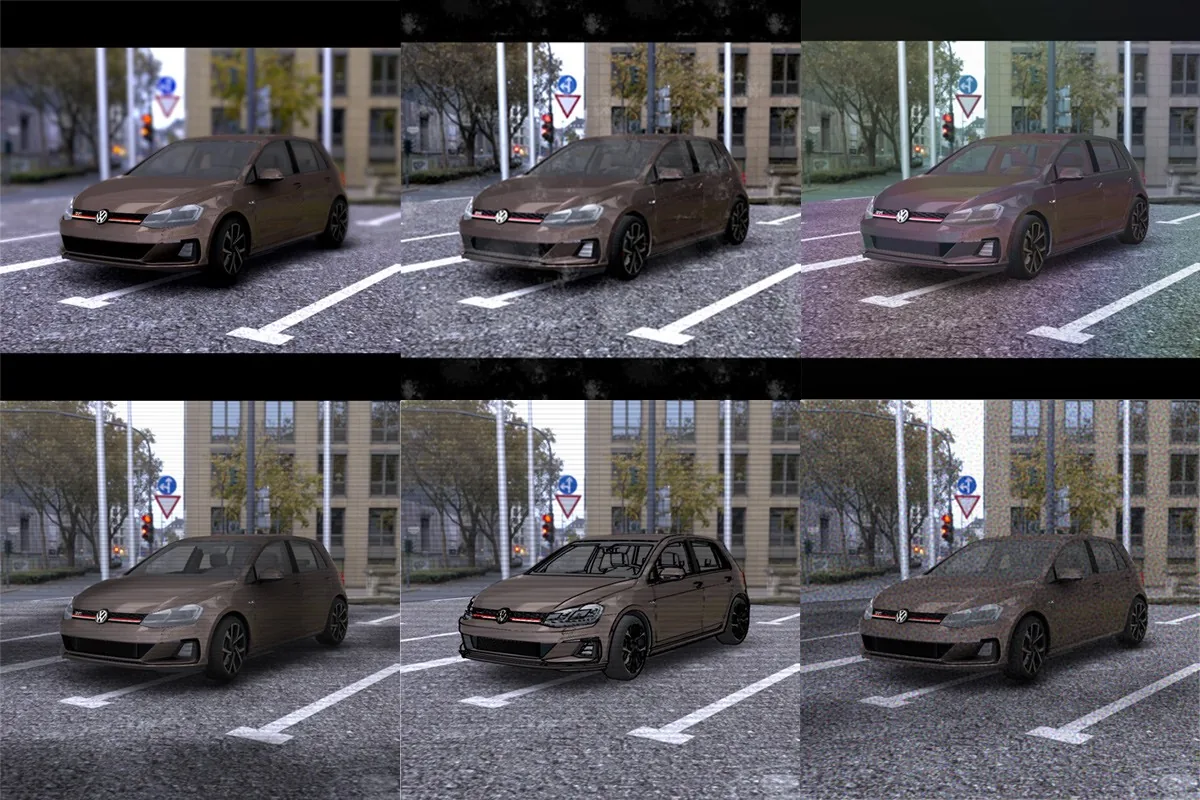
后期处理滤镜变化
这些效果很细微,可能不容易发现。这里可以看到的有景深、噪点、云影、环境光遮蔽、边缘高光、色相偏移和黑边。对每一种效果,我们还会随机调整参数,以获得更多变化。
整合起来
应用所有变化之后,我们得到的图像如下:
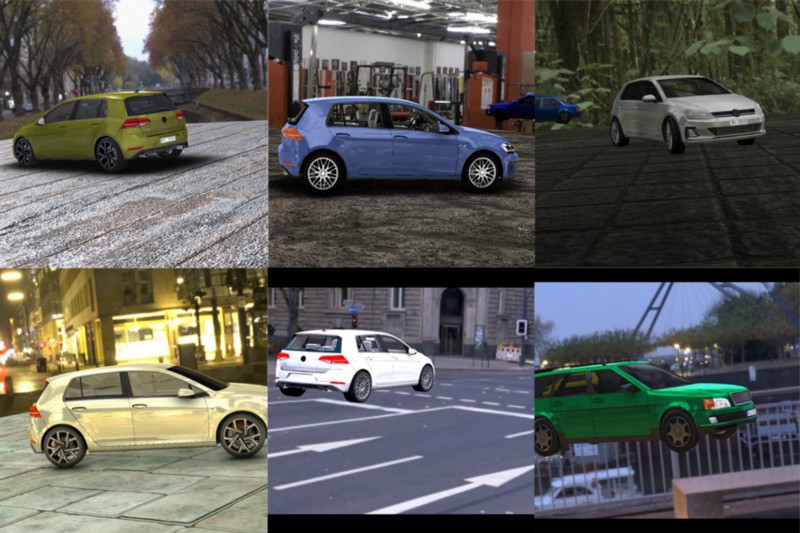
启用所有变化的渲染图
尽管这些看起来不像真实的街景,但背景和光照的大量变化应该会迫使网络去学习在所有照片中始终保持不变的汽车特征。如果我们只使用街景,检测器很可能会把街景的某些方面纳入它的特征中,误以为汽车本身总会伴随着某些阴影和光照特性。
创建小型验证数据集
用 Python 编写的标注工具
出于对数据集偏差的担忧,我们手动为一些真实汽车图像标注了 3D 关键点。逐个手动标注 14 个关键点相当耗时,尤其是被遮挡的关键点。为了加快速度,我们临时拼凑了一个非常简单的 wxPython 应用,每张图像只需要标注几个关键点。为此,我们使用 OpenCV 的 SolvePnP 根据这些初始关键点拟合 3D 汽车模型,再把其他关键点投影到图像中。标注完成后,我们使用 imgaug 库应用随机的图像增强。幸运的是,imgaug 支持随图像一起变换 2D 关键点,所以你不必手动变换点的位置。增强之后,我们得到了大约 1500 张用于验证网络的图像。
效果如何?
对于我们这种只针对少数已知车型的用例,第一轮的结果就让我们相当满意。我们原本以为需要在训练中加入更多真实图像,或者更多地依靠迁移学习,但最终并不需要这样做。正如你在视频中看到的,即使在相当广泛的各种车上测试,仍能得到合理的结果。对于其他车型,3D 模型拟合的效果并不完美,因为我们是在把一个刚性 3D 物体拟合到另一辆尺寸不同的车上。有文献研究如何根据关键点拟合灵活的参数化汽车模型,所以如果要做更通用的汽车检测器,我们可能会研究一下。
代码
如果有时间整理并用更多车型训练,我们计划发布这条流水线的部分内容。目前,我们已经放出了一个 iOS 演示应用的代码,它使用 ARKit 显示估计出的车辆姿态(请注意,该模型是针对固定视角范围和车型训练的。)如果你对项目的某个部分有具体的问题,或者需要定制的数据集或模型,请联系我们。
与 Laan Labs 合作
计算机视觉与 AI 开发
定制计算机视觉与机器学习,从概念验证到正式投产,支持设备端与云端。
下载本文
获取 Markdown 源文件,方便离线阅读