Estimación de la pose 3D de automóviles en tiempo real entrenada con datos sintéticos

Estimación de poses de automóviles
Estimación de poses 3D de automóviles en entornos reales con un iPhone corriente
Descripción general del proyecto
Nuestro cliente tenía la visión de una aplicación que guiara a los usuarios para capturar fotos de automóviles de mayor calidad mediante guías de AR y captura automática de fotos. Este artículo se centra en la tecnología que se empleó para construir el componente de estimación de pose del automóvil. En la aplicación, se guía a los usuarios para que se coloquen en determinados ángulos y a determinadas distancias del automóvil y así capturar las mejores imágenes de forma estandarizada. Cuando el usuario está en la posición correcta, se capturan automáticamente fotos de alta resolución.
Necesitábamos una manera de saber aproximadamente dónde está el usuario en el espacio 3D en relación con el automóvil que fotografía. Como se trataba de una aplicación prototipo, solo teníamos unas semanas para encontrar una solución que funcionara. También limitamos el reconocimiento a un modelo de automóvil concreto para acortar el desarrollo.
Objetivos y restricciones
- Poco tiempo para construir una solución que funcionara
- Estimación de la pose del automóvil aproximadamente en tiempo real (< 150 ms)
- Alcance limitado a un modelo concreto de automóvil con distintos colores y opciones
- La aplicación debía capturar fotos de alta calidad
Qué probamos antes de crear algo nuevo
Con la esperanza de encontrar una solución rápida y lista para usar para la estimación de pose de objetos 3D, probamos varios enfoques.
El reconocimiento de objetos 3D de ARKit de Apple
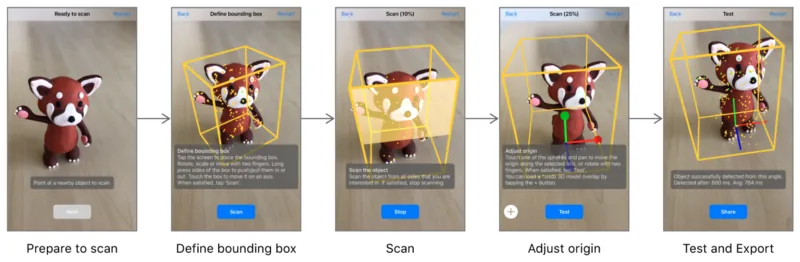
Reconocimiento de objetos con ARKit: aplicación de escaneo de objetos
ARKit incluye API para escanear y reconocer objetos 3D rígidos dentro de ARKit. Esto nos pareció ideal: en tiempo real e integrado en ARKit, reduciría a cero el tiempo de desarrollo de esta función. Nuestra principal preocupación era reconocer distintos colores de automóvil. Para comprobar cómo lo manejaba ARKit, compramos un automóvil en miniatura en varios colores.
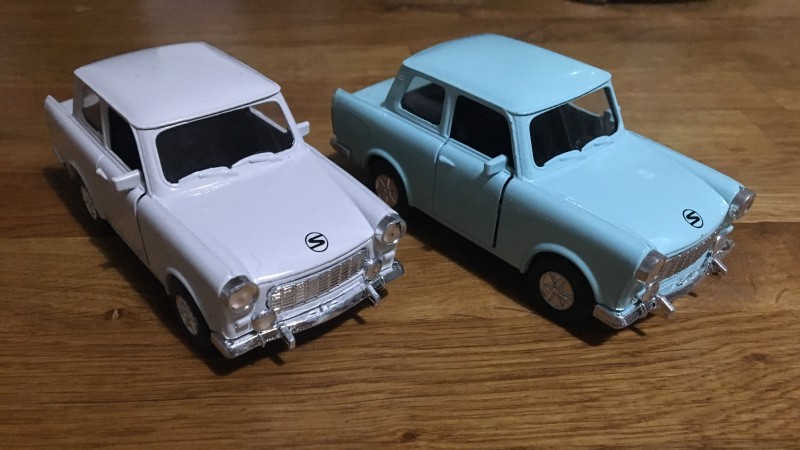
Automóviles a escala para las pruebas
Escaneamos un color y luego probamos con un color parecido (p. ej., escanear blanco y probar con azul claro). En algunos casos el reconocimiento funcionó. No era perfecto, pero quizá si escaneábamos un conjunto de colores base, eso aportaría suficiente invariancia para reconocer cualquier color de automóvil que pudiéramos esperar.
El siguiente paso fue probarlo con automóviles reales. Resultó que los automóviles reales se comportaban de forma algo distinta. Incluso escanear y probar con exactamente el mismo automóvil no era fiable. A veces el automóvil reconocido aparecía ligeramente rotado o desplazado en un sentido u otro. Suponemos que las pinturas muy reflectantes de los automóviles dificultan que funcione el escaneo y el reconocimiento basados en características (Apple menciona específicamente en su documentación que los objetos reflectantes no son adecuados para el reconocimiento 3D).
SDK de terceros
Probamos algunos otros SDK y obtuvimos resultados similares a los de ARKit. Algunas bibliotecas requerían «plantillas de inicialización» o posiciones concretas con las que el usuario debía hacer coincidir la vista para arrancar el seguimiento del objeto 3D. Esto no era lo ideal, ya que queríamos guiar al usuario a determinadas posiciones, por lo que el reconocimiento tenía que funcionar desde una amplia variedad de ángulos y posiciones.
Calidad de las fotos
Otro inconveniente tanto de ARKit como de los SDK que probamos es la calidad y la resolución de las fotos que se pueden capturar mientras se usan. La resolución máxima disponible para la captura con ARKit es de 1920x1440. Además, el control sobre el enfoque y la exposición con ARKit es muy limitado. Como la aplicación trata precisamente de capturar fotos de automóviles de alta calidad, queríamos un control preciso del enfoque y la exposición, además de una resolución de imagen alta.
Construcción de un estimador de pose basado en una red neuronal
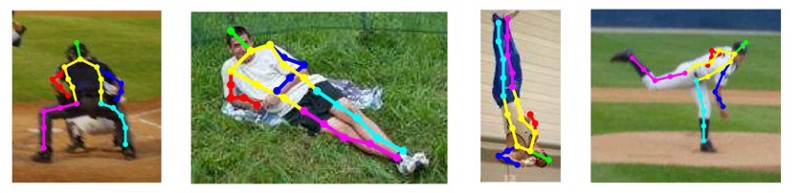
Estimación de pose humana
Dada la falta de éxito con las soluciones de terceros, sumada a la limitación en la calidad de las fotos, decidimos construir nuestra propia solución, que funcionara junto con las API de cámara AVFoundation de Apple. Elegimos una red neuronal porque son lo último en estimación de pose y hay muchos proyectos de código abierto e investigaciones que aprovechar.
Enfoques para la estimación de pose
Dada una imagen, ¿cómo predecimos la pose 3D de un objeto que aparece en ella? Un enfoque habitual consiste en predecir las ubicaciones en la imagen de un conjunto de puntos conocidos de un modelo canónico del objeto. Por ejemplo, dada una foto de un automóvil, ¿dónde está el faro izquierdo en la imagen? Con suficientes predicciones de este tipo, podemos estimar la pose 3D del modelo original del automóvil respecto a la cámara que toma la foto.
Arquitectura de la red
Hoy en día las redes neuronales muestran una precisión impresionante en una gran variedad de tareas, pero además pueden ejecutarse en tiempo real en dispositivos móviles gracias a las mejoras en las arquitecturas de red y a la mayor velocidad de los dispositivos.
Recientemente nos encontramos con algunos proyectos de estimación de pose corporal en tiempo real para móviles basados en las arquitecturas CPM y stacked hourglass.
- https://github.com/edvardHua/PoseEstimationForMobile
- https://github.com/tucan9389/PoseEstimation-CoreML
Estos proyectos contienen mucha información útil para entrenar y ejecutar su propio estimador de pose en plataformas móviles.
La red CPM que utilizaron tiene una base MobileNetV2 y genera un mapa de calor 2D para cada una de las 14 partes del cuerpo (codo izquierdo, rodilla derecha, etc.)
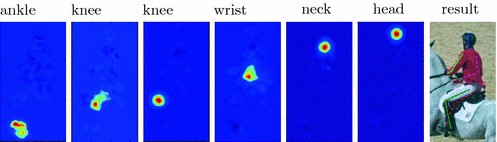
Mapas de calor de varias partes del cuerpo
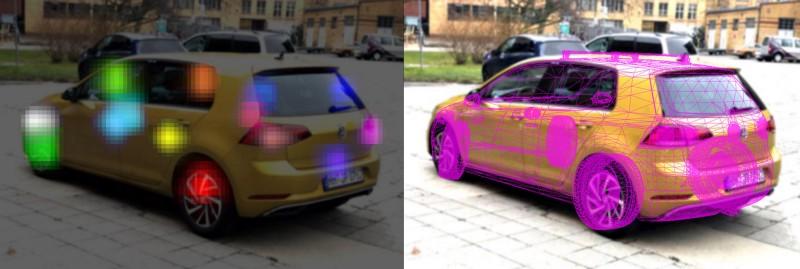
A partir de aquí, básicamente podemos tomar las ubicaciones de máxima activación de cada capa de puntos clave y luego estimar la pose 3D del automóvil con el método SolvePnP de OpenCV. Aquí se muestra una visualización de nuestra red neuronal final ejecutándose sobre la foto de un automóvil real, junto con la pose 3D estimada. El ajuste no es perfecto debido a la resolución limitada de los mapas de calor de salida. Nuestro modelo genera mapas de calor con una resolución de 192x192, por lo que hay un límite a la precisión que se puede lograr en una sola pasada.
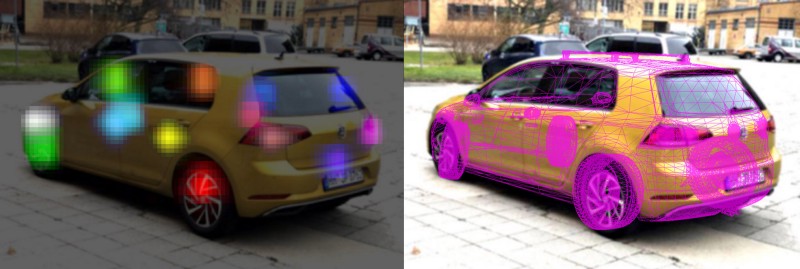
Resultado final del modelo
Otros enfoques y recursos
Optamos por CPM para ponernos en marcha rápidamente, pero hay otras formas de resolver este problema. Otro enfoque basado en puntos clave consiste en generar directamente los puntos clave 2D como una lista de coordenadas x,y. Esto nos limita a la estimación de un solo automóvil, pero para nuestro caso de uso sería aceptable. Inspirados por la entrada de Hart Woolery sobre estimación de pose de la mano, probamos a añadir simplemente unas cuantas capas densas sobre MobileNet para obtener finalmente un conjunto de 1x28 ubicaciones x,y de puntos clave. Sorprendentemente, esto funcionó bastante bien desde el principio. Con más tiempo quizá exploraríamos más a fondo esta red, ya que fue ligeramente más rápida que el modelo CPM que elegimos.
Si solo busca estimación de pose humana, consulte el reciente artículo de Jameson Toole sobre el estimador de pose humana de fritz.ai: https://heartbeat.fritz.ai/pose-estimation-on-ios-with-fritz-60c8e5f7d195
Otro método consiste en que la red genere directamente los parámetros de pose del automóvil en lugar de pasar por puntos clave 2D intermedios (véanse BoxCars, MultiBin). Con el poco tiempo disponible, no evaluamos de forma rigurosa todas las direcciones que podríamos haber tomado, pero estos otros enfoques parecen perfectamente válidos.
Búsqueda de un conjunto de datos de automóviles
Con la arquitectura de red elegida, el siguiente paso es encontrar un conjunto de datos con el que entrenarla. No faltan conjuntos de datos para la estimación de pose corporal (COCO, DensePose, MPII, Resumen de conjuntos de datos de pose corporal), pero los datos anotados de automóviles son menos comunes. Existen algunos conjuntos (Apollo, PASCAL 3d+), pero cada uno parecía tener sus propias limitaciones. La mayoría están orientados a vehículos autónomos, por lo que hay un fuerte sesgo hacia imágenes tomadas desde la perspectiva de un automóvil que circula por la calle, lo que sería muy distinto de las imágenes que esperamos que maneje nuestra red. PASCAL 3D tiene anotaciones de modelos 3D de automóviles, pero los vehículos suelen ser modelos mucho más antiguos obtenidos de fotos de internet. Como conocíamos el modelo de automóvil de antemano, no era necesario entrenar con miles de otros modelos (aunque, con más tiempo, nos gustaría ampliar nuestra red para reconocer más modelos). Y, por último, algunos conjuntos de datos tienen una restricción de licencia no comercial. Ante estas deficiencias, exploramos los datos sintéticos como forma de adaptar los datos directamente al entorno de prueba que esperábamos.
Creación de un conjunto de datos sintéticos de automóviles
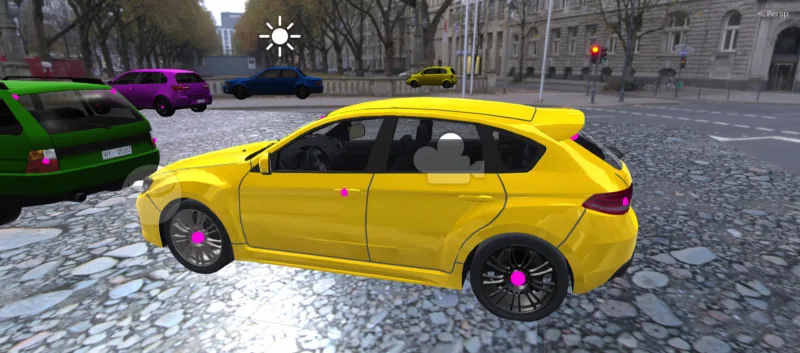
Captura del editor de Unity
Los datos sintéticos son muy útiles cuando es imposible o poco práctico generar la gran cantidad de datos de entrenamiento que requieren muchos métodos de machine learning. Gracias a la industria de los videojuegos, podemos aprovechar motores gráficos como Unity o Unreal Engine para el renderizado y usar recursos 3D desarrollados originalmente para juegos. Aunque todavía no obtendremos la calidad de renderizado de un enfoque de trazado de rayos, la velocidad y la enorme cantidad de código de ejemplo y de recursos gratuitos o baratos lo hacen muy atractivo. Elegimos Unity porque teníamos más experiencia con él y el tiempo era un factor.
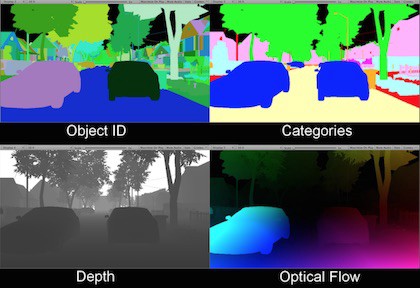
Ejemplos de datos sintetizados con Unity
Unity incluso ha publicado un útil proyecto de demostración con algunas necesidades habituales de los datos sintéticos. Recientemente también dimos una charla breve sobre el entrenamiento de una red de segmentación de pies para un juego de fútbol en AR con SceneKit.
Reunimos unos 10 modelos de automóviles de forma similar a nuestro modelo objetivo, junto con dos variaciones del automóvil exacto con el que hacíamos las pruebas.
Búsqueda de modelos de automóviles
Por suerte hay bastantes modelos 3D de automóviles de alta calidad. Para modelos de calidad muy alta puede que tenga que pagar unos cientos de dólares (véase https://squir.com/), pero hay muchos baratos o gratuitos directamente en la Unity Asset Store:
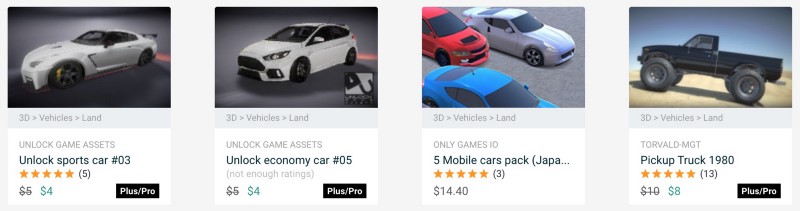
Anotación
Con los modelos listos, el siguiente paso fue anotar los puntos clave que queremos que nuestra red aprenda a reconocer. Como la red de pose corporal tenía 14 puntos clave, nos pareció un punto de partida razonable, ya que reduciría cualquier modificación del pipeline de entrenamiento existente. Este paso exigió crear 14 objetos de juego vacíos y colocarlos en cada modelo de automóvil:
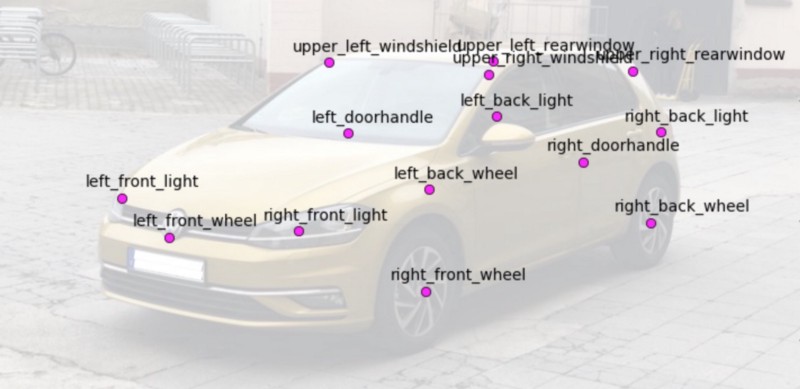
14 puntos clave del automóvil
Creación de variaciones en el conjunto de datos
Una gran preocupación al entrenar con datos sintéticos es si el modelo generalizará a imágenes del mundo real. Es un área de investigación activa y en evolución, con muchos enfoques interesantes. El equipo de machine learning de Apple tiene una entrada interesante sobre cómo mejorar el realismo de imágenes sintéticas de ojos mediante GAN. El enfoque que elegimos se denomina aleatorización de dominio. Al crear muchas variaciones en la distribución de los datos de entrenamiento, el modelo debería generalizar a la distribución objetivo (el mundo real) sin ningún ajuste fino.
Para lograrlo, intentamos aleatorizar tantos aspectos de la escena como fue posible antes de renderizar una imagen. Una gran preocupación inicial era que la red aprendiera a captar algunos detalles menores de los modelos 3D de los automóviles que no generalizarían a fotografías de automóviles reales. Hay una anécdota muy citada (y posiblemente falsa) sobre unos investigadores que entrenaron un detector de tanques que simplemente aprendió a qué hora del día se habían fotografiado los tanques del conjunto de entrenamiento. Sea cierto o no ese ejemplo, cuando los conjuntos de entrenamiento y de prueba proceden de distribuciones distintas, hay que cuidar que el modelo se transfiera bien a los datos nuevos.
Variaciones del automóvil
Para cada modelo de automóvil dedicamos algo de tiempo a crear variaciones programables de detalles menores de la carrocería. Cosas como la reflectividad de la pintura, la posición y la numeración de la matrícula, el tinte de los cristales, el estilo y la posición de los rines y algunas más. También escalamos ligeramente el propio automóvil a lo largo de sus ejes locales.
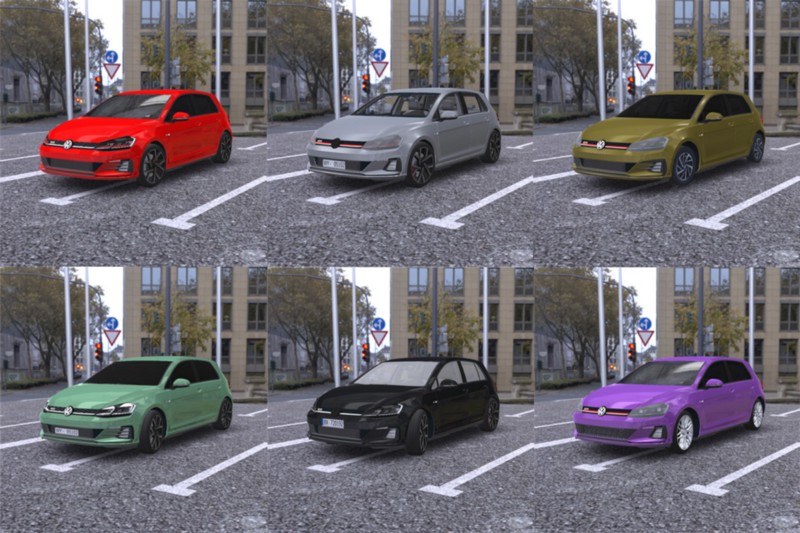
Renders solo con variaciones de la carrocería
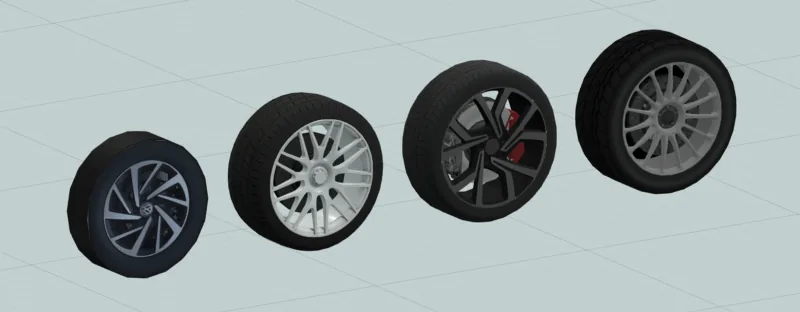
Distintas opciones de neumáticos
Entorno y fondo
Al principio empezamos a construir y comprar algunas escenas con edificios y estructura 3D real. Encontrar escenas fotorrealistas de alta calidad resultaba difícil y se volvería caro y laborioso. Por suerte, dimos con un estupendo sitio web llamado https://hdrihaven.com/ que ofrece mapas de entorno gratuitos de muy alta resolución. Son, básicamente, panoramas HDR de 360 que se renderizan detrás de la geometría y pueden aportar iluminación y reflejos a los objetos de la escena. También variamos de forma paramétrica las intensidades de reflejo y de exposición mediante nuestros scripts de renderizado.
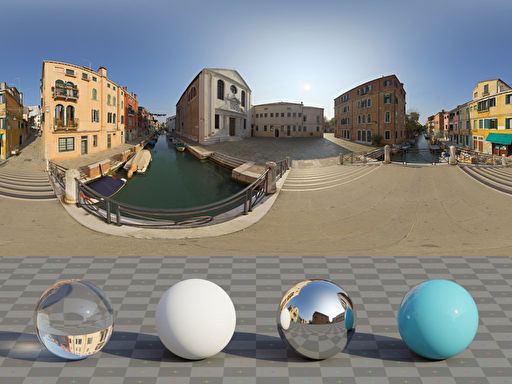
Mapa de entorno de HDRI Haven
Además del skybox, creamos un plano sencillo como suelo bajo el automóvil. Aplicar distintos materiales al suelo y ocultarlo de vez en cuando aporta mucha diversidad visual:
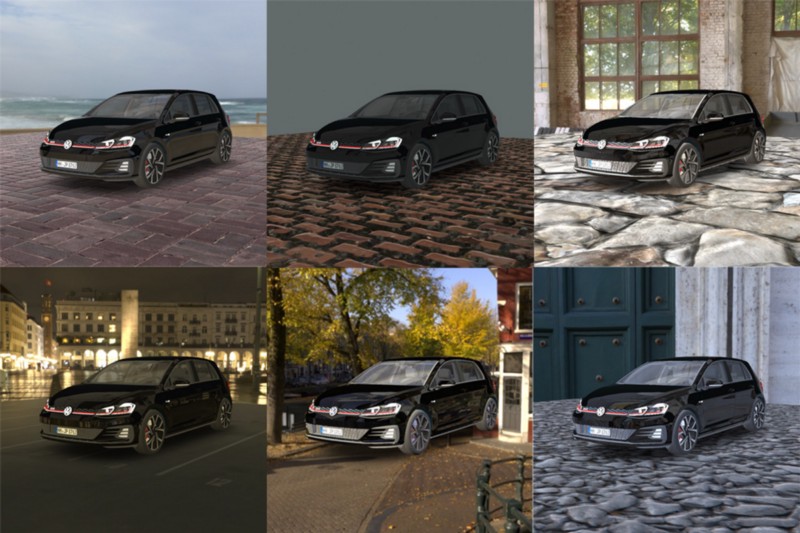
Variaciones de escena e iluminación
Efectos de posprocesamiento
Unity tiene una función llamada «Post Processing Stack», que son básicamente filtros de Instagram para su escena 3D. Estos efectos pueden incluir desenfoque, corrección de color, etc. Se puede añadir a la escena mediante el Package Manager o la Asset Store, según su versión de Unity. Además del Post Processing Stack integrado, descargamos otro conjunto de filtros de la Asset Store llamado SC Post Effects Pack por 25 $. Aquí se muestran algunos renders que varían únicamente en la combinación de filtros de posprocesamiento:
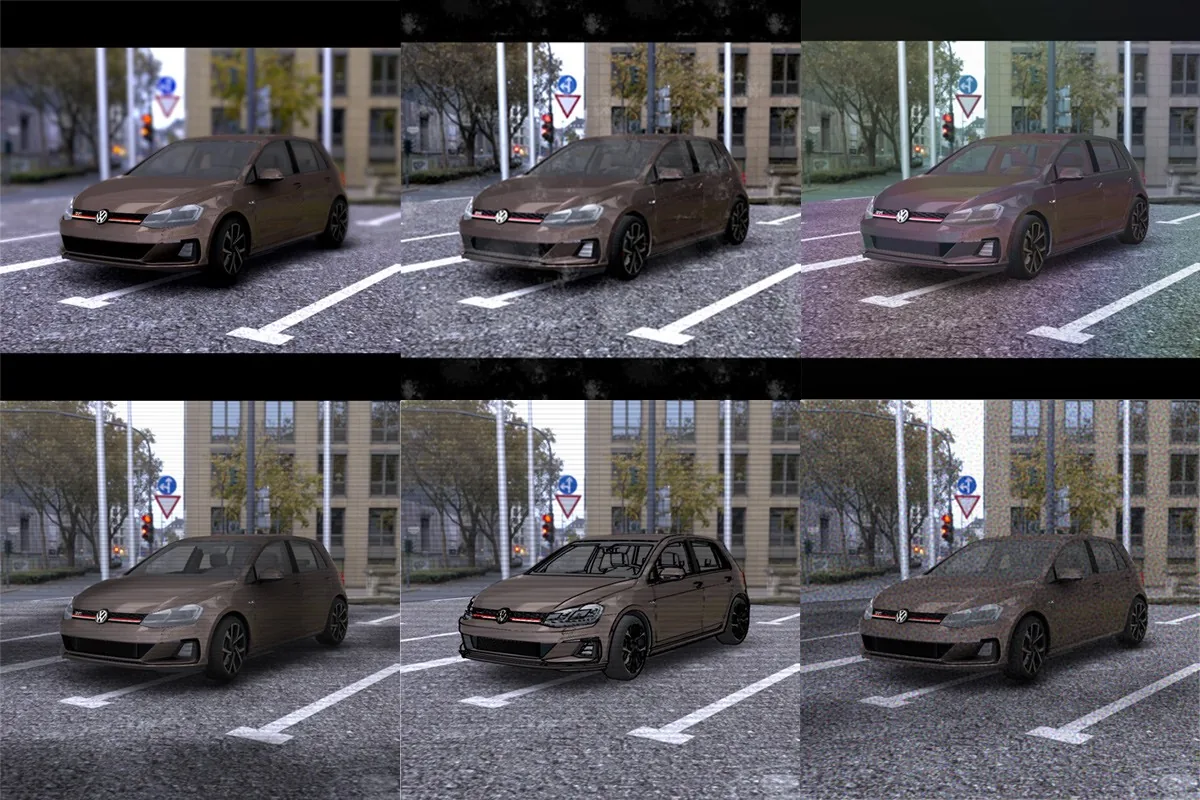
Variaciones de los filtros de posprocesamiento
Los efectos son sutiles y pueden ser difíciles de distinguir. Algunos de los que se ven aquí son profundidad de campo, ruido, sombras de nubes, oclusión ambiental, resaltado de bordes, cambio de tono y bandas negras. En cada uno de ellos también ajustamos los parámetros de forma aleatoria para obtener aún más variaciones.
Todo junto
Al aplicar todas las variaciones obtenemos imágenes como estas:
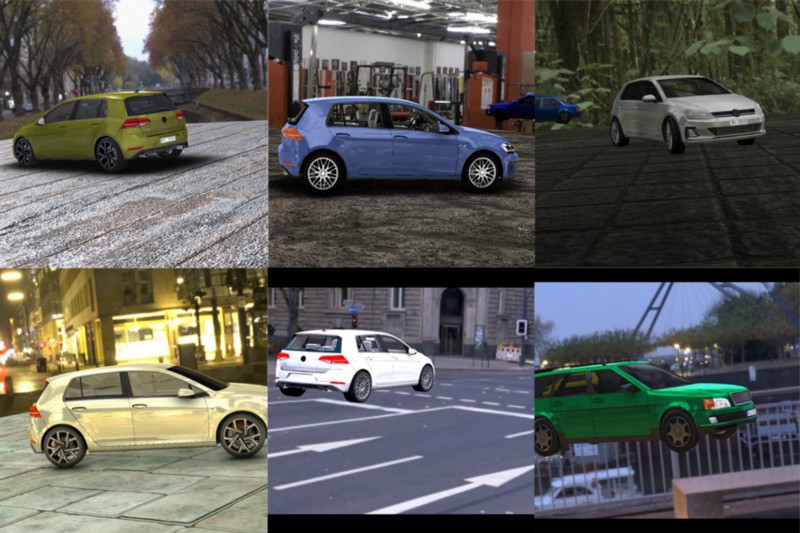
Renders con todas las variaciones activadas
Aunque no parezcan escenas de calle reales, las muchas variaciones del fondo y de la iluminación deberían obligar a la red a captar las características del automóvil que permanecen constantes en todas las fotos. Si solo hubiéramos usado una escena de calle, nuestro detector probablemente habría incorporado aspectos de esa escena a sus características, esperando que ciertas características de sombras e iluminación acompañaran siempre al propio automóvil.
Creación de un pequeño conjunto de datos de validación
Herramienta de anotación escrita en Python
Nuestra preocupación por el sesgo del conjunto de datos nos llevó a anotar manualmente algunas imágenes reales de automóviles con puntos clave 3D. Anotar manualmente 14 puntos clave uno por uno lleva bastante tiempo, sobre todo los puntos ocultos. Para acelerar las cosas improvisamos una aplicación muy básica con wxPython que solo requiere etiquetar unos pocos puntos clave por imagen. Para ello usamos el SolvePnP de OpenCV para ajustar el modelo 3D del automóvil a partir de esos puntos clave iniciales y después proyectar los demás puntos clave sobre la imagen. Una vez anotadas, aplicamos aumentos aleatorios de imagen con la biblioteca imgaug. Por suerte, imgaug permite transformar los puntos clave 2D junto con la imagen, de modo que no hay que transformar manualmente las posiciones de los puntos. Tras el aumento teníamos alrededor de 1500 imágenes para validar nuestra red.
¿Funciona?
Para nuestro caso de uso de un pequeño conjunto de modelos de automóvil conocidos, quedamos bastante satisfechos con los resultados a la primera. Suponíamos que tendríamos que incorporar más imágenes reales al entrenamiento o apoyarnos más en el aprendizaje por transferencia, pero no hizo falta. Incluso probando con una gama bastante amplia de automóviles se obtienen resultados razonables, como se ve en el video. El ajuste del modelo 3D no funciona perfectamente con otras formas de automóvil, ya que estamos ajustando un objeto 3D rígido a otro automóvil de dimensiones distintas. Existe bibliografía sobre cómo ajustar un modelo paramétrico flexible de automóvil a partir de puntos clave, así que podríamos investigarla para un detector de automóviles más genérico.
Código
Nuestro plan es publicar algunos aspectos del pipeline si encontramos tiempo para ordenarlo y entrenar con más modelos de automóvil. Por ahora hemos publicado el código de una demo, una aplicación para iOS que muestra la pose estimada del automóvil con ARKit (tenga en cuenta que el modelo está entrenado con un rango de puntos de vista y un modelo de automóvil fijos). Si tiene alguna pregunta concreta sobre alguna parte del proyecto, o necesita un conjunto de datos o un modelo a medida, escríbanos.
Trabaje con Laan Labs
Desarrollo de visión por computador e IA
Visión por computador y aprendizaje automático a medida, de la prueba de concepto a la producción, en el dispositivo y en la nube.
Descargar este artículo
Obtenga el código fuente en Markdown para leerlo sin conexión