合成データで学習させたリアルタイム3D車両姿勢推定

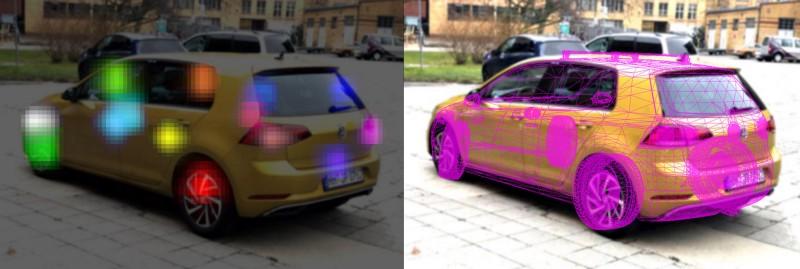
車両の姿勢を推定しているところ
ごく普通のiPhoneで、屋外にある車の3D姿勢を推定する
プロジェクトの概要
クライアントには、ARガイドと自動撮影によって、ユーザーがより質の高い車の写真を撮れるようにするアプリの構想がありました。この記事では、そのうち車両姿勢推定のコンポーネントを作るために使った技術に焦点を当てます。アプリでは、最適な写真を標準化された方法で撮影できるよう、車から特定の角度と距離の位置に立つようユーザーを誘導します。ユーザーが正しい位置に来ると、高解像度の写真が自動的に撮影されます。
撮影するユーザーが、車に対して3D空間のおおよそどこに立っているかを知る手段が必要でした。 これはプロトタイプのアプリだったため、動作する解決策を考え出すのに数週間しかありませんでした。また、開発期間を短縮するために、認識の対象を特定の車種に限定しました。
目標と制約
- 動作する解決策を作るための短い期間
- おおよそリアルタイムの車両姿勢推定(150ミリ秒未満)
- 色やオプションが異なる、特定の車種に範囲を限定
- アプリは高品質な写真を撮影できること
新しく作る前に試したこと
3D物体の姿勢推定について、すぐに使える既存の解決策を期待して、いくつかのアプローチを試しました。
AppleのARKitによる3D物体認識
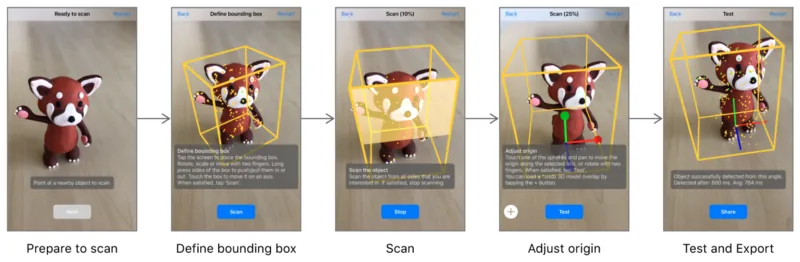
ARKitの物体認識 - 物体スキャンアプリ
ARKitには、ARKit内で剛体の3D物体をスキャンして認識するためのAPIがあります。これは理想的に思えました。リアルタイムで動作し、ARKitに組み込まれているため、この機能の開発時間をゼロにできるはずでした。最大の懸念は、さまざまな車の色を認識できるかどうかでした。ARKitがこれをどの程度扱えるかを確かめるため、色違いのミニカーをいくつか購入しました。
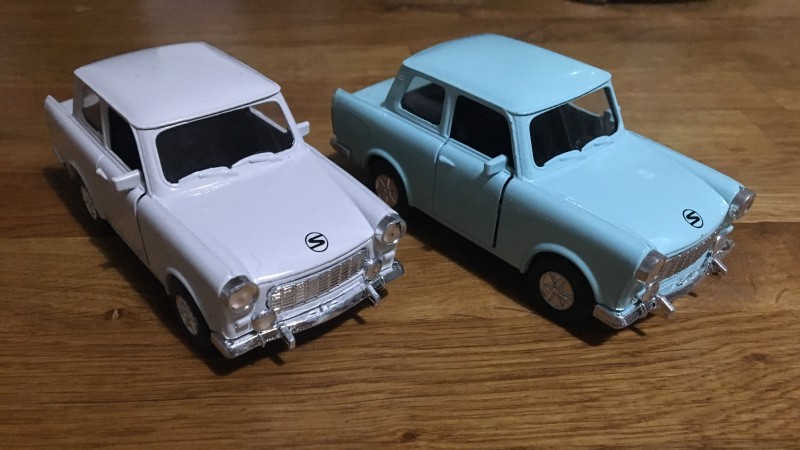
テスト用のミニカー
ある色をスキャンし、似た色でテストしました(たとえば、白をスキャンして水色でテストするなど)。認識できたケースもありました。完璧ではありませんでしたが、基本となる色をいくつかスキャンしておけば、想定されるどの色の車でも認識できる程度の不変性が得られるかもしれません。
次のステップは、実際の車で試すことでした。実際の車は、少し違う挙動を示しました。まったく同じ車をスキャンしてテストしても、信頼できる結果ではありませんでした。認識された車が、どちらかの方向に少し回転したり、ずれたりすることがありました。車の塗装は反射が強いため、特徴点ベースのスキャンと認識がうまく機能しにくいのだと推測しています(Appleもドキュメントで、反射する物体は3D認識に適さないと具体的に言及しています)。
サードパーティ製SDK
他のSDKもいくつか試しましたが、ARKitと同様の結果でした。ライブラリによっては、3D物体のトラッキングを開始させるために、ユーザーが合わせなければならない特定の「初期化テンプレート」や位置が必要でした。私たちはユーザーを特定の位置に誘導したいので、認識はさまざまな角度や位置から機能する必要があり、これは理想的ではありませんでした。
写真の品質
ARKitと、試したSDKの両方に共通する欠点がもう1つあります。それらを使っている間に撮影できる写真の品質と解像度です。ARKitの使用中にキャプチャできる最高解像度は1920x1440です。また、ARKitではフォーカスと露出の制御もごく限られています。このアプリは高品質な車の写真を撮ることが目的なので、大きな画像解像度に加えて、フォーカスと露出を細かく制御したいと考えました。
ニューラルネットワークによる姿勢推定器の構築
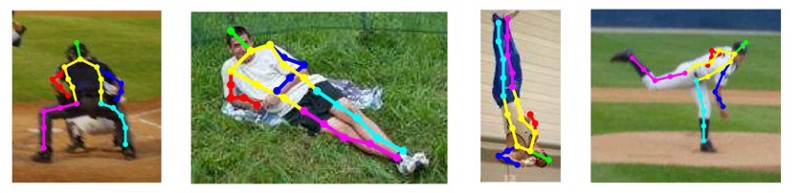
人体の姿勢推定
サードパーティ製の解決策ではうまくいかなかったことと、写真の品質の制約を踏まえ、AppleのAVFoundationカメラAPIと併用して動作する独自の解決策を構築することにしました。ニューラルネットワークを選んだのは、姿勢推定における最先端の手法であり、活用できるオープンソースプロジェクトや研究が数多くあるためです。
姿勢推定へのアプローチ
画像が与えられたとき、その中にある物体の3D姿勢をどう予測すればよいのでしょうか。一般的なアプローチは、物体の標準モデル上にある既知の点の集合が、画像のどこにあるかを予測するものです。たとえば、車の写真があるとき、左のヘッドライトは画像のどこにあるのか、という具合です。こうした予測が十分に得られれば、写真を撮影したカメラに対する、元の車モデルの3D姿勢を推定できます。
ネットワークアーキテクチャ
近年のニューラルネットワークは、さまざまなタスクで驚くべき精度を示すだけでなく、ネットワークアーキテクチャの改善とデバイスの高速化のおかげで、モバイルデバイス上でリアルタイムに動作することも可能になりました。
最近、CPMとstacked hourglassアーキテクチャをベースにした、リアルタイムのモバイル向け人体姿勢推定プロジェクトを見つけました。
- https://github.com/edvardHua/PoseEstimationForMobile
- https://github.com/tucan9389/PoseEstimation-CoreML
これらのプロジェクトには、独自の姿勢推定器をモバイルプラットフォームで学習・実行するための有用な情報がたくさん含まれています。
彼らが使っていたCPMネットワークは、MobileNetV2をベースにしており、14の身体部位(左ひじ、右ひざなど)のそれぞれについて2Dヒートマップを出力します。
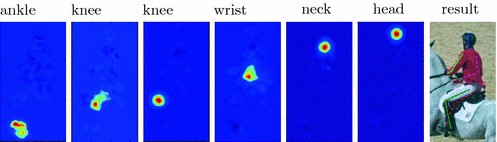
さまざまな身体部位のヒートマップ
ここから、各キーポイント層の最大活性化位置を取り出し、OpenCVのSolvePnPメソッドで車の3D姿勢を推定できます。実際の車の写真で最終的なニューラルネットワークを動かし、推定した3D姿勢とともに可視化したものが次の図です。出力ヒートマップの解像度に限りがあるため、完全には一致していません。私たちのモデルは192x192の解像度のヒートマップを出力するため、1回の処理で得られる精度には限界があります。
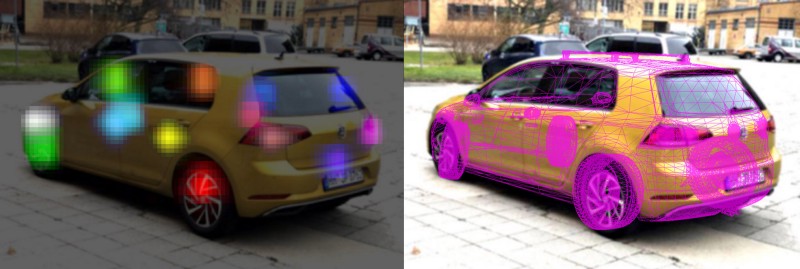
モデルの最終出力
その他のアプローチと参考資料
私たちは、素早く動かせるようにCPMを選びましたが、この問題を解く方法は他にもあります。別のキーポイントベースのアプローチは、2Dキーポイントをx、y座標のリストとして直接出力する方法です。この場合、推定できる車は1台に限られますが、私たちのユースケースではそれで問題ありませんでした。Hart Woolery氏による手の姿勢推定の記事に着想を得て、MobileNetの上に全結合層をいくつか追加し、最終的に1x28のx、yキーポイント位置を出力する方法を試しました。驚いたことに、これは何も手を加えなくてもかなりうまく動作しました。時間があれば、選んだCPMモデルよりわずかに高速だったため、このネットワークをさらに掘り下げたかもしれません。
人体の姿勢推定だけをお探しなら、Jameson Toole氏によるfritz.aiの人体姿勢推定器についての最近の記事をご覧ください。https://heartbeat.fritz.ai/pose-estimation-on-ios-with-fritz-60c8e5f7d195
もう1つの方法は、中間の2Dキーポイントを経由せず、ネットワークが車の姿勢パラメータを直接出力するものです(BoxCars、MultiBinを参照)。限られた期間の中で、取りえたすべての方向を厳密に評価したわけではありませんが、こうした他のアプローチも十分に有効だと思われます。
車のデータセットを探す
ネットワークアーキテクチャが決まったら、次のステップは、それを学習させるために使えるデータセットを見つけることです。人体の姿勢推定のデータセットは数多くありますが(COCO、DensePose、MPII、人体姿勢データセットの概要)、アノテーション付きの車のデータは、やや少なくなります。いくつかのデータセット(Apollo、PASCAL 3d+)は存在しますが、いずれもそれぞれに制約があるように思えました。ほとんどのデータセットは自動運転車向けで、通りを走る車の視点から撮った画像に大きく偏っています。これは、私たちのネットワークが扱うと想定している画像とはかなり異なります。PASCAL 3Dには3D車両モデルのアノテーションがありますが、車はたいていインターネット上の写真から集められた、かなり古い車種です。私たちは車種を事前に把握していたため、他の何千もの車種で学習させる必要はありませんでした(ただし、時間があればより多くの車種を認識できるようにネットワークを拡張したいと考えています)。さらに、一部のデータセットには非商用ライセンスの制限があります。こうした欠点を踏まえ、想定するテスト環境に合わせてデータを直接調整する方法として、合成データを検討しました。
合成車両データセットの作成
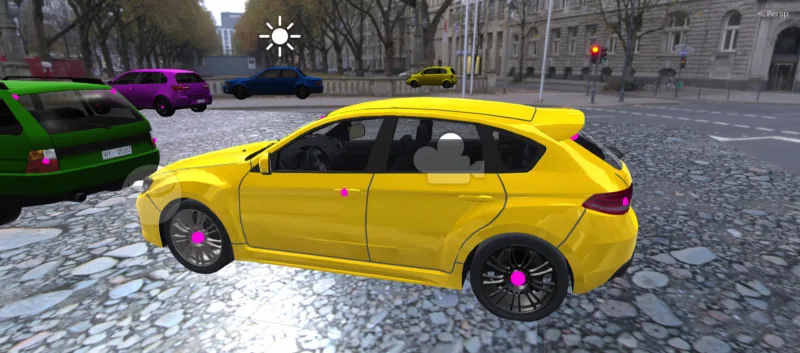
Unityエディタのスクリーンショット
合成データは、多くの機械学習手法が必要とする大量の学習データを作ることが不可能、あるいは非現実的な場合に役立ちます。ビデオゲーム業界のおかげで、レンダリングにUnityやUnreal Engineなどのグラフィックスエンジンを活用でき、もともとゲーム用に開発された3Dアセットも使えます。レイトレーシングによるレンダリング品質はまだ得られませんが、その速さと、サンプルコードや無料・低価格のアセットの圧倒的な多さが大きな魅力です。私たちはUnityを選びました。Unityのほうが経験が豊富で、時間にも制約があったためです。
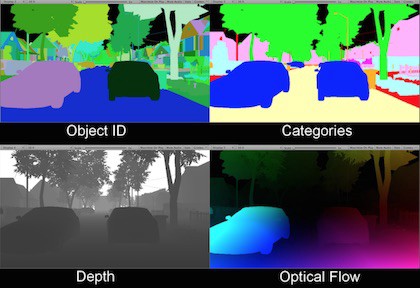
Unityで合成したデータの例
Unityは、合成データでよくある要件をカバーした便利なデモプロジェクトも公開しています。私たちも最近、SceneKitを使ったARサッカーゲーム用に、足のセグメンテーションネットワークを学習させることについて短い講演を行いました。
対象モデルと形状が似た車のモデルを約10種類と、テスト対象とまったく同じ車の2つのバリエーションを集めました。
車のモデルを探す
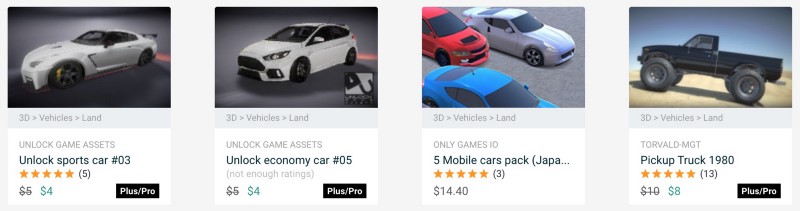
幸い、高品質な3D車両モデルはかなりたくさんあります。非常に高品質なモデルには数百ドルかかることもありますが(https://squir.com/を参照)、Unityアセットストアから直接入手できる安価なものや無料のものも多数あります。
アノテーション
モデルの準備ができたら、次のステップは、ネットワークに認識させたいキーポイントのアノテーションでした。人体姿勢のネットワークには14個のキーポイントがあり、既存の学習パイプラインへの変更を最小限にできるため、それが妥当な出発点に思えました。この手順では、14個の空のゲームオブジェクトを作成し、車のモデルごとに配置する必要がありました。
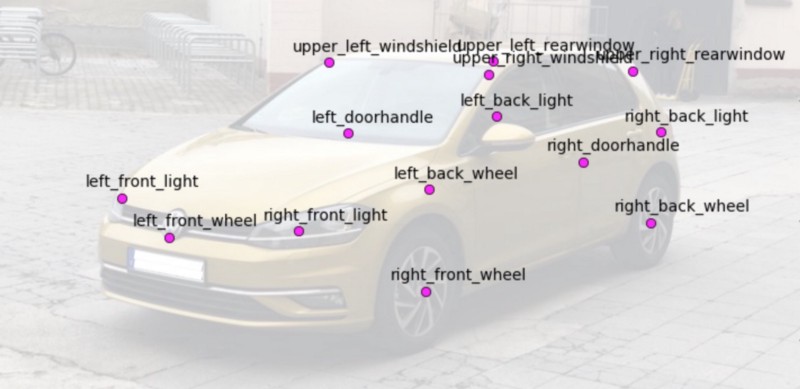
車の14個のキーポイント
データセットにバリエーションを作る
合成データで学習させるときの大きな懸念は、モデルが現実世界の画像に汎化するかどうかです。これは活発に進展している研究分野で、興味深いアプローチが数多くあります。Appleの機械学習チームには、GANを使って合成した目の画像のリアリティを高めることについての興味深い記事があります。私たちが選んだアプローチはドメインランダマイゼーションです。学習データの分布に多くのバリエーションを作ることで、モデルは、ファインチューニングをしなくても、対象となる(現実世界の)分布に汎化するはずです。
そのために、画像をレンダリングする前に、シーンのできるだけ多くの要素をランダム化するようにしました。当初の大きな懸念の1つは、ネットワークが3D車両モデルの細かな特徴を拾ってしまい、それが実際の車の写真には汎化しないことでした。研究者が戦車の検出器を学習させたところ、学習セットの戦車が撮影された時間帯を学習しただけだった、というよく語られる(そしておそらく事実ではない)逸話があります。その例が事実かどうかにかかわらず、学習セットとテストセットが異なる分布から来ている場合は、新しいデータへの転移が確実に行えるよう注意が必要です。
車のバリエーション
車のモデルごとに、車体の細かな特徴をスクリプトで変えられるバリエーションを作る作業に時間をかけました。塗装の反射率、ナンバープレートの位置と番号、ウィンドウの色合い、ホイールのスタイルと位置など、いくつかの要素です。また、車自体をそのローカル軸に沿って少しだけスケーリングしました。
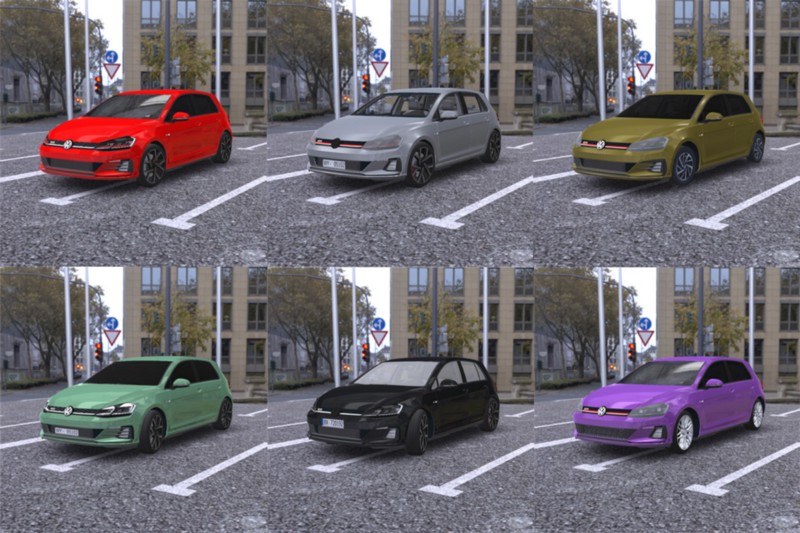
車体のバリエーションだけをレンダリングしたもの
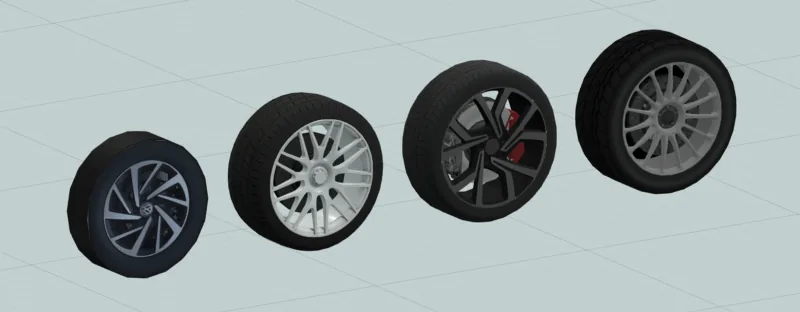
さまざまなタイヤのオプション
環境 / 背景
当初は、建物や実際の3D構造物を含むシーンをいくつか自作したり購入したりしようとしていました。高品質でフォトリアルなシーンを見つけるのは難しく、費用も時間もかさむことがわかってきました。幸い、非常に高解像度の環境マップを無料で提供している素晴らしいWebサイトhttps://hdrihaven.com/を見つけました。これらは基本的に、ジオメトリの背後にレンダリングされる360°のHDRパノラマで、シーン内の物体に照明と反射を与えられます。また、レンダリングスクリプトによって、反射と露出の強度もパラメトリックに変化させています。
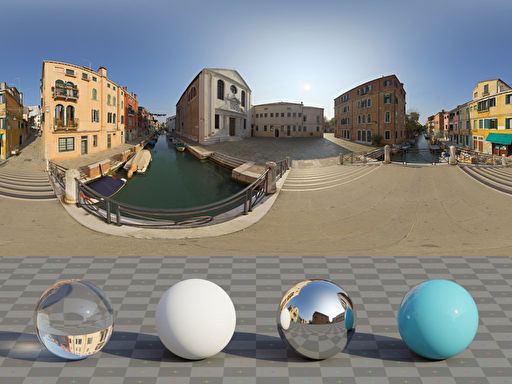
HDRI Havenの環境マップ
スカイボックスに加えて、車の下の床として単純な平面を作成しました。床にさまざまなマテリアルを適用し、ときには床をまるごと非表示にすることで、視覚的な多様性が大きく広がります。
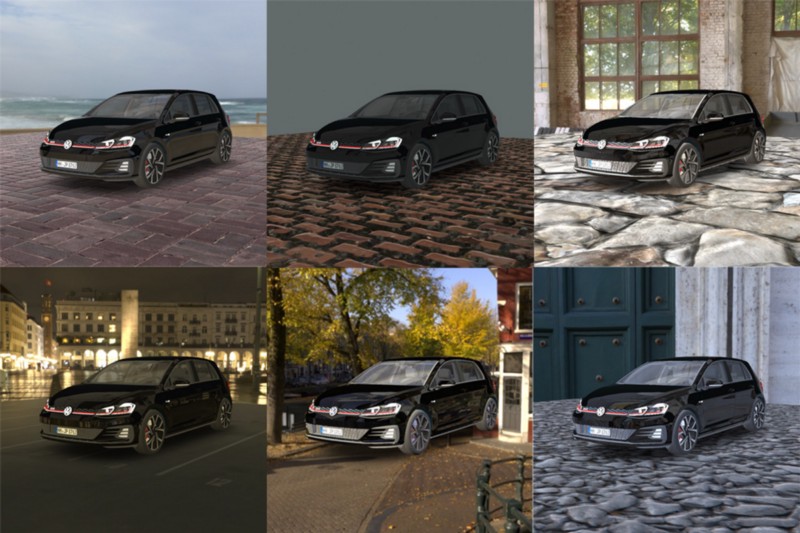
シーンと照明のバリエーション
ポストプロセスエフェクト
Unityには「Post Processing Stack」という機能があり、いわば3Dシーン向けのInstagramフィルターです。ブラー、カラーグレーディングなどのエフェクトが含まれます。Unityのバージョンに応じて、Package Managerまたはアセットストアからシーンに追加できます。内蔵のPost Processing Stackに加えて、アセットストアから、25ドルのSC Post Effects Packというフィルター集も入手しました。次は、ポストプロセスフィルターの組み合わせだけを変えたレンダリングの例です。
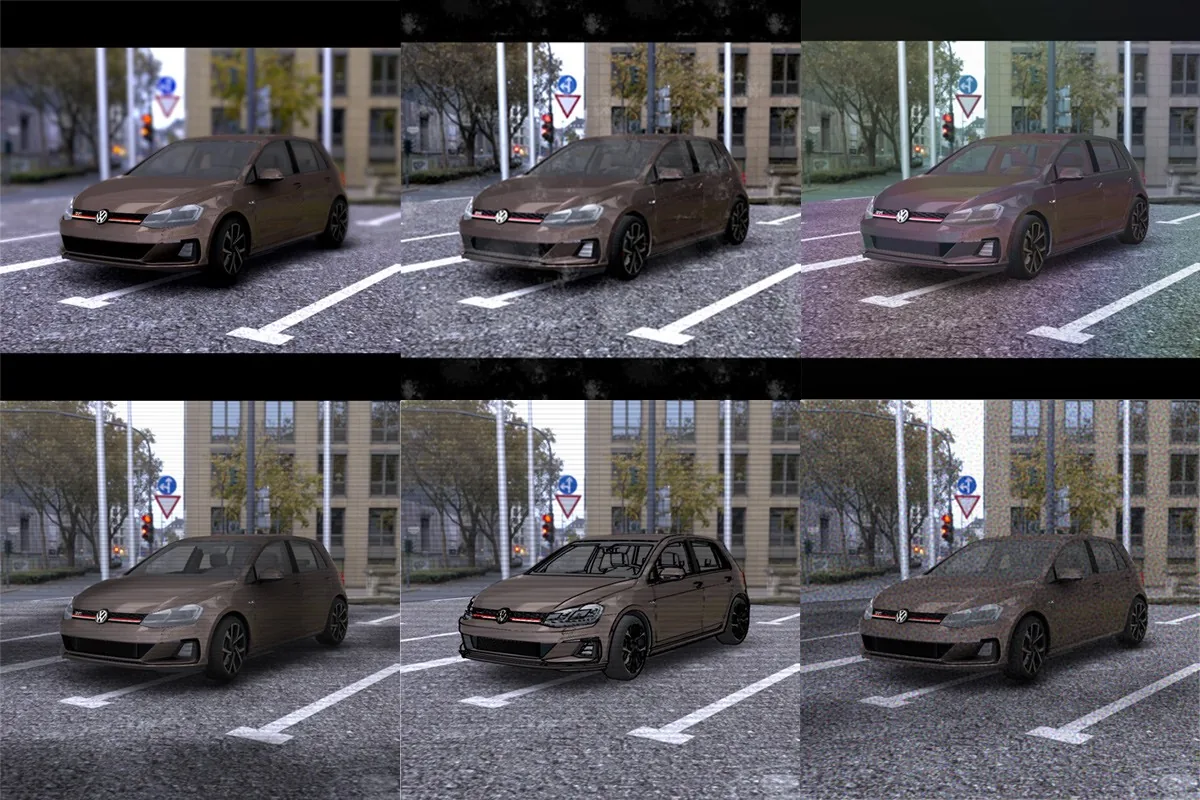
ポストプロセスフィルターのバリエーション
エフェクトは控えめで、見分けにくいかもしれません。ここに見られるのは、被写界深度、ノイズ、雲の影、アンビエントオクルージョン、エッジのハイライト、色相のシフト、黒帯などです。これらのそれぞれについてパラメータもランダムに調整し、さらにバリエーションを増やしています。
すべてを組み合わせる
すべてのバリエーションを適用すると、次のような画像になります。
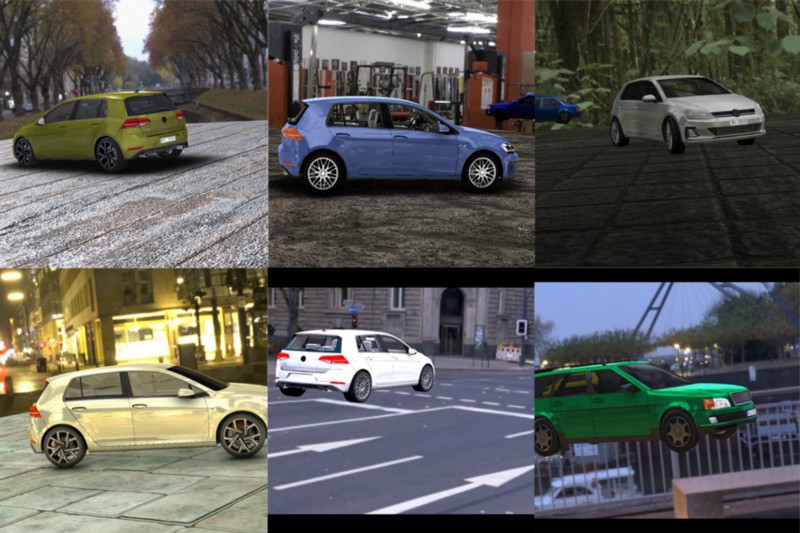
すべてのバリエーションを有効にしたレンダリング
これらは実際の街中の風景には見えませんが、背景と照明の多様なバリエーションによって、ネットワークは、すべての写真を通じて変わらない車の特徴を拾い上げるようになるはずです。もし街中のシーンだけを使っていたら、検出器は街中のシーンの要素を特徴に取り込んでしまい、特定の影や照明の特性が、常に車そのものとセットで現れると期待してしまうでしょう。
小規模な検証データセットの作成
Pythonで書いたアノテーションツール
データセットのバイアスへの懸念から、実際の車の画像に3Dキーポイントを手動でアノテーションすることにしました。14個のキーポイントを1つずつ手動でアノテーションするのは、特に隠れたキーポイントについてはかなり時間がかかります。作業を速めるため、画像ごとに数個のキーポイントにラベルを付けるだけで済む、ごく基本的なwxPythonアプリケーションを急ごしらえしました。そのために、OpenCVのSolvePnPを使い、それらの初期キーポイントから3D車両モデルをフィッティングし、他のキーポイントを画像に投影します。アノテーションが済んだら、imgaugライブラリを使ってランダムな画像拡張を適用しました。ありがたいことに、imgaugは画像と一緒に2Dキーポイントも変換してくれるので、点の位置を手動で変換する必要はありません。拡張後には、ネットワークの検証に使える画像が約1500枚になりました。
うまくいったのか
既知の少数の車種というユースケースにおいて、最初の試行で得られた結果にはかなり満足しました。もっと実画像を学習に取り入れたり、転移学習にさらに頼ったりする必要があるだろうと考えていましたが、結局そうする必要はありませんでした。動画でご覧いただけるように、かなり幅広い車でテストしても、妥当な結果が得られています。他の車の形状では、3Dモデルのフィッティングは完璧には機能しません。寸法の異なる別の車に、剛体の3D物体をフィッティングしているためです。キーポイントから柔軟なパラメトリック車両モデルをフィッティングする研究があるので、より汎用的な車両検出器のためにそれを検討するかもしれません。
コード
時間を確保してクリーンアップし、より多くの車種で学習させることができれば、パイプラインの一部を公開する予定です。今のところ、ARKitを使って推定した車の姿勢を表示するiOSアプリのデモ用コードを公開しています(モデルは固定の視点範囲と車種で学習されている点にご注意ください)。プロジェクトの特定の部分について質問がある場合や、カスタムのデータセットやモデルが必要な場合は、お気軽にご連絡ください。
Laan Labs と協業する
コンピュータビジョン・AI開発
概念実証から本番運用まで、オンデバイスでもクラウドでも対応するカスタムのコンピュータビジョンと機械学習を提供します。
この記事をダウンロード
オフラインで読めるMarkdownソースを入手できます