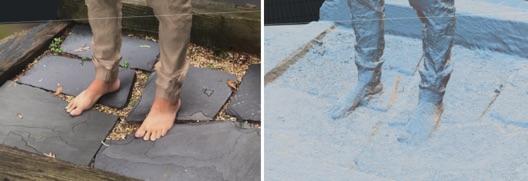
Mit Photogrammetrie die Effizienz der Datenannotation steigern

Überblick
Für ein aktuelles Projekt haben wir eine AR-App zur virtuellen Schuhanprobe prototypisch umgesetzt. Dafür brauchten wir ein neuronales Netz zur Posenschätzung, das auf Bildern trainiert wurde, die mit 2D-Keypoints an bestimmten Stellen des Fußes annotiert waren.
Für solche gelabelten Bilder muss normalerweise jemand über eine grafische Oberfläche jeden Punkt in jedem Bild anklicken. Bei einfachen Objekten ist das machbar, wenn auch zeitaufwendig. Bei komplexeren 3D-Objekten, bei denen die Keypoint-Positionen verdeckt oder schwer exakt zu bestimmen sein können, wird diese Strategie unpraktikabel, wenn das Ziel Tausende Bilder sind. Wir haben untersucht, ob sich Photogrammetrie-Workflows eignen, um das Labeln in unserer speziellen Situation zu beschleunigen.
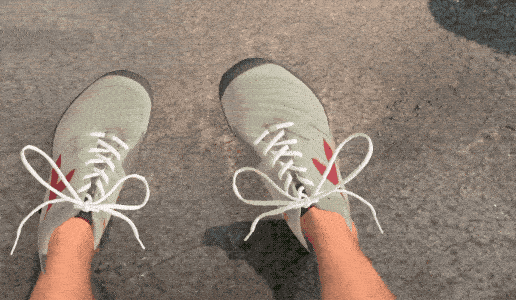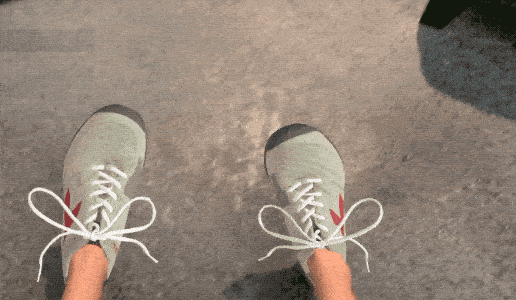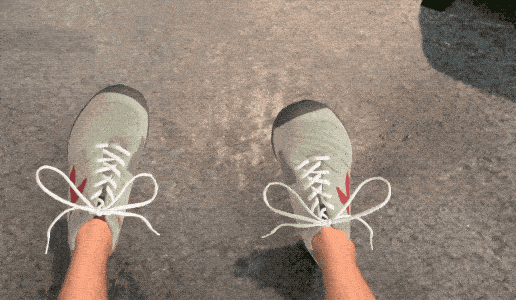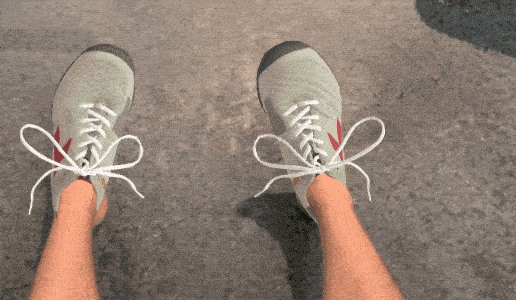
Finale Demo
Unser Ansatz
Wir haben mit Smartphones Videos von Schuhen aufgenommen, die aus mehreren Umrundungen der Füße einer Person bestehen. Mit handelsüblicher Photogrammetrie-Software schätzen wir für jedes Videobild die Kameraposen in 3D und erstellen eine 3D-Mesh-Darstellung der Szene. Dann annotieren wir 2D-Fuß-Keypoints für mehrere Bilder des Videos. Die Kombination aus den 2D-Annotationen und den 3D-Kameraposen erlaubt es uns, die 3D-Positionen dieser Keypoints in der rekonstruierten 3D-Szene zu schätzen.
Mithilfe der Kameraposen können wir die 3D-Keypoint-Positionen für jeden im Video erfassten Kamerastandpunkt zurück in 2D-Koordinaten projizieren. Ist ein Video 90 Sekunden lang und mit 30 Bildern pro Sekunde aufgenommen, haben wir nun 2700 gelabelte Bilder, bei einem Aufwand, der dem Labeln von nur 4 Bildern entspricht.
Was sind Photogrammetrie und SFM?
Photogrammetrie-Software nimmt viele Fotos desselben Objekts oder derselben Szene aus verschiedenen Blickwinkeln entgegen und rekonstruiert daraus ein 3D-Modell der Szene.
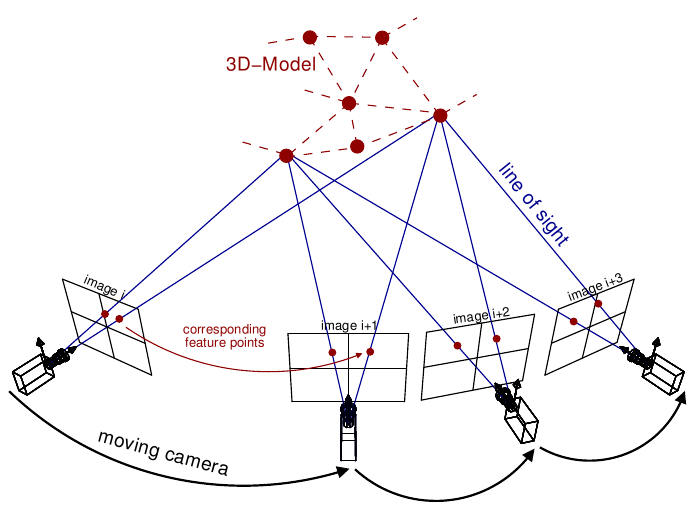
Quelle: Theia-sfm.org (2016)
Ein Schritt in diesem Prozess besteht darin, für jedes Foto eine Kamerapose in 3D zu schätzen. Das Endergebnis der Photogrammetrie ist ein 3D-Mesh, wir brauchen aber nur die Kameraposen, die zur Erstellung dieses Meshes verwendet wurden. Man könnte das 3D-Modell auch nutzen, um unendlich viele Blickwinkel auf das Objekt zu rendern, aber wir haben festgestellt, dass der Realismus eines 3D-Renderings nicht an die Qualität der Fotos heranreicht, auch wenn wir das gern weiter untersuchen würden.
Photogrammetrie-Software
Es gibt viele Optionen für Photogrammetrie-Software, von kostenlos und Open Source bis zu kostenpflichtigen Produkten. Wir haben uns auf Alicevision Meshroom (kostenlos) und Reality Capture (kostenpflichtig) konzentriert, vor allem weil sich beide leicht installieren lassen und schnell ein Ergebnis liefern. Reality Capture war deutlich schneller und erzeugte bessere Kameraposen und Rekonstruktionen als Meshroom. Meshroom hat aber ein paar Vorteile: Es ist kostenlos und Open Source, und es lässt sich skripten. Reality Capture hat zwar ein Kommandozeilen-Interface, dessen Nutzung erfordert aber eine höhere Preisstufe (zuletzt, als wir nachgesehen haben; inzwischen wurde auf ein Modell mit Abrechnung pro Bild umgestellt, das abweichen kann)
HINWEIS: Wenn Sie nur die Kameraposen und keine 3D-Rekonstruktion benötigen, brauchen Sie nicht unbedingt eine vollständige Photogrammetrie-Pipeline; Software wie COLMAP, OpenSFM oder OpenMVG könnte genügen.
Eine weitere Option, die wir kurz getestet haben, war, Videos aufzunehmen und dabei ARKit zur Erfassung der Kameraposen zu nutzen. Damit hätten wir die Kameraposen ohne jede Nachbearbeitung geschenkt bekommen. Wir stellten jedoch fest, dass Jitter und Fehlerakkumulation für die Art der Videos, die wir aufnahmen, zu stark waren. Wenn Ihre Anwendung eine ziemlich statische Szene mit vielen visuellen Merkmalen und kurze Videos hat, könnte ARKit/ARCore die einfachere Lösung sein. (Siehe auch Googles aktuelle Veröffentlichung zum Sammeln von Trainingsdaten mit dieser Methode.)
Daten erfassen
Zuerst extrahieren wir mit einer bestimmten FPS-Rate Einzelbilder aus dem Video:
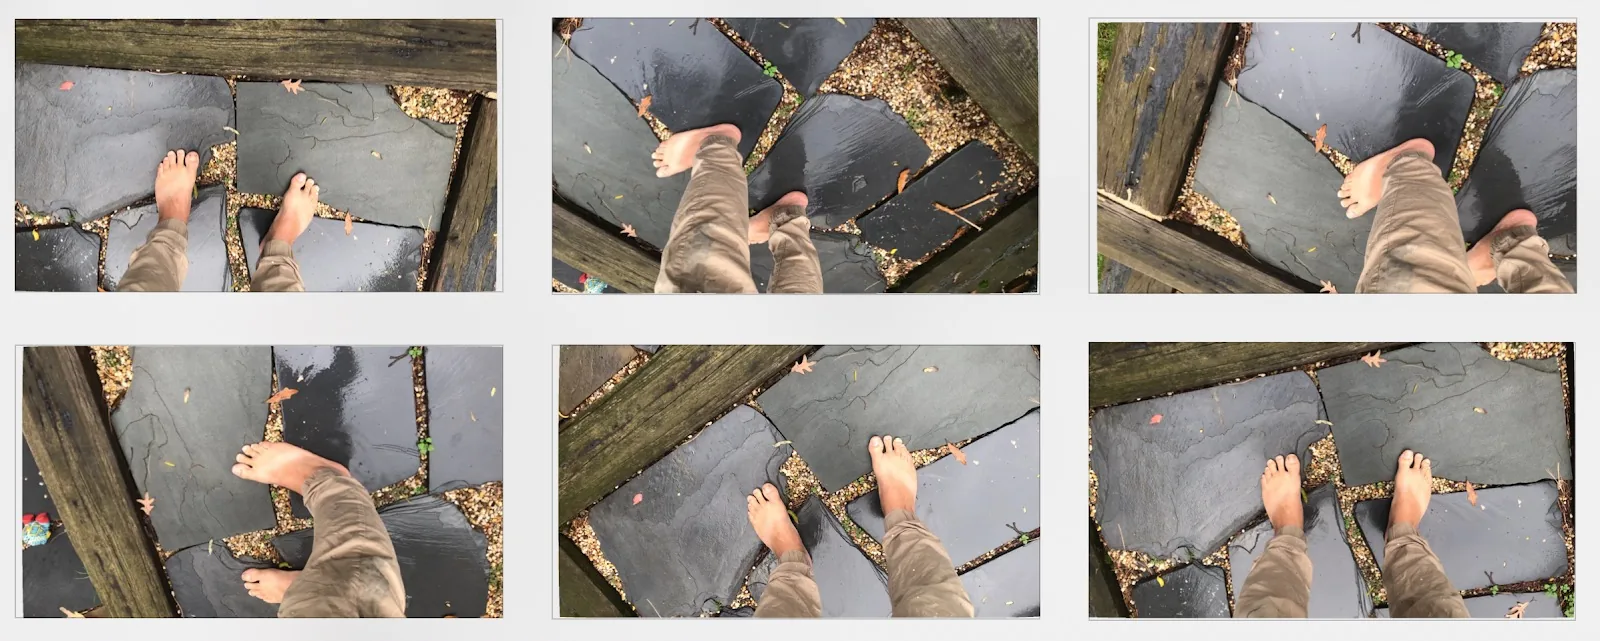
6 Beispielbilder aus den 500 für die Rekonstruktion verwendeten Videobildern
Zweitens übergeben wir die extrahierten Bilder an Reality Capture, was das folgende Mesh und die folgenden Kameraposen ergibt:
Kameraposen zusammen mit dem rekonstruierten Modell
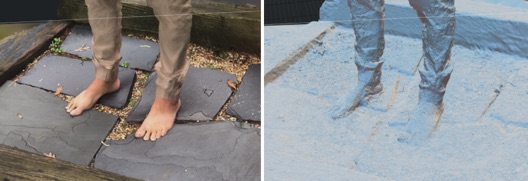
Reality-Capture-Rekonstruktion
Reality Capture automatisieren
Das erforderte etwas Aufwand, da die Kommandozeile für uns damals keine Option war. Am Ende haben wir ein Windows-Automatisierungsskript geschrieben, das alle unsere Videodaten lädt und verarbeitet. Reality Capture erlaubt den Export der Kameraposen in verschiedenen Formaten.
Alicevision Meshroom automatisieren
Meshroom lässt sich über die Kommandozeile recht unkompliziert bedienen, auch wenn wir auf ein paar Hindernisse gestoßen sind. In diesem GitHub-Repository haben wir ein Jupyter-Notebook veröffentlicht, das zeigt, wie sich ein Video komplett aus Python heraus zu einem 3D-Mesh verarbeiten lässt, wie die Kameraposen extrahiert werden und wie das Video schließlich mit eingeblendetem Mesh neu gerendert wird.
Fuß-Keypoints erzeugen
Nachdem wir nun Kameraposen für jedes Bild haben, müssen wir die Keypoint-Positionen pro Bild finden. Das Ziel ist hier, nur eine kleine Teilmenge aller Bilder im Video zu labeln. Die beiden Methoden, die wir dafür getestet haben, sind 2D-Annotation und 3D-Annotation.
3D-Annotation
Die Ausgabe der Photogrammetrie-Stufe liefert eine Mesh-Rekonstruktion, daher ist eine Option, mit 3D-Modellierungssoftware Keypoints direkt auf den Füßen in unserer 3D-Szene zu platzieren. Zusammen mit den Kameraposen können wir diese 3D-Positionen zurück in jedes Bild des Videos projizieren. Wir haben ein kleines Blender-Skript erstellt, das beim Anlegen und Exportieren der Keypoints hilft. Anfangs schien diese Methode aus zwei Gründen die beste Option zu sein:
- Jedes Video muss nur einmal gelabelt werden
- Verdeckte Keypoints sind kein Problem, da man das 3D-Modell einfach so lange drehen kann, bis der Keypoint sichtbar ist
Nach einigen Tests stellten wir fest, dass diese Methode ziemlich zeitaufwendig und langsamer war als die zweite Option, die 2D-Annotation, die unten beschrieben wird. Die Geschwindigkeit hing wahrscheinlich damit zusammen, dass es in Blender praktisch schwierig ist, schnell etwas zum Laufen zu bringen. Da wir keine Blender-Profis sind, dauerte das Verschieben von 14 kleinen Kugeln im 3D-Raum länger als das Anklicken eines 2D-Bildes. Mit mehr Zeit könnte eine bessere Bedienung zum Platzieren der 3D-Keypoints in Blender vieles beschleunigen. Ideal wäre hier ein Aufbau in VR, in dem man Keypoints direkt in 3D platziert, statt einen 2D-Monitor zu verwenden.
2D-Annotation
Letztlich haben wir uns für den langweiligeren Ansatz entschieden, über eine grafische Oberfläche für jeden Keypoint die Position im 2D-Bild anzuklicken. Das muss für mehrere Bilder des Videos geschehen, damit sich die 3D-Positionen der Keypoints triangulieren lassen.
Während der Annotation visualisieren wir ein 3D-Fußmodell mit der aktuellen Schätzung der 3D-Keypoint-Positionen; das gibt Rückmeldung zur Genauigkeit der aktuellen Annotation. Sobald die Fußpose über mehrere Bilder hinweg korrekt aussieht, können wir die Annotation beenden.
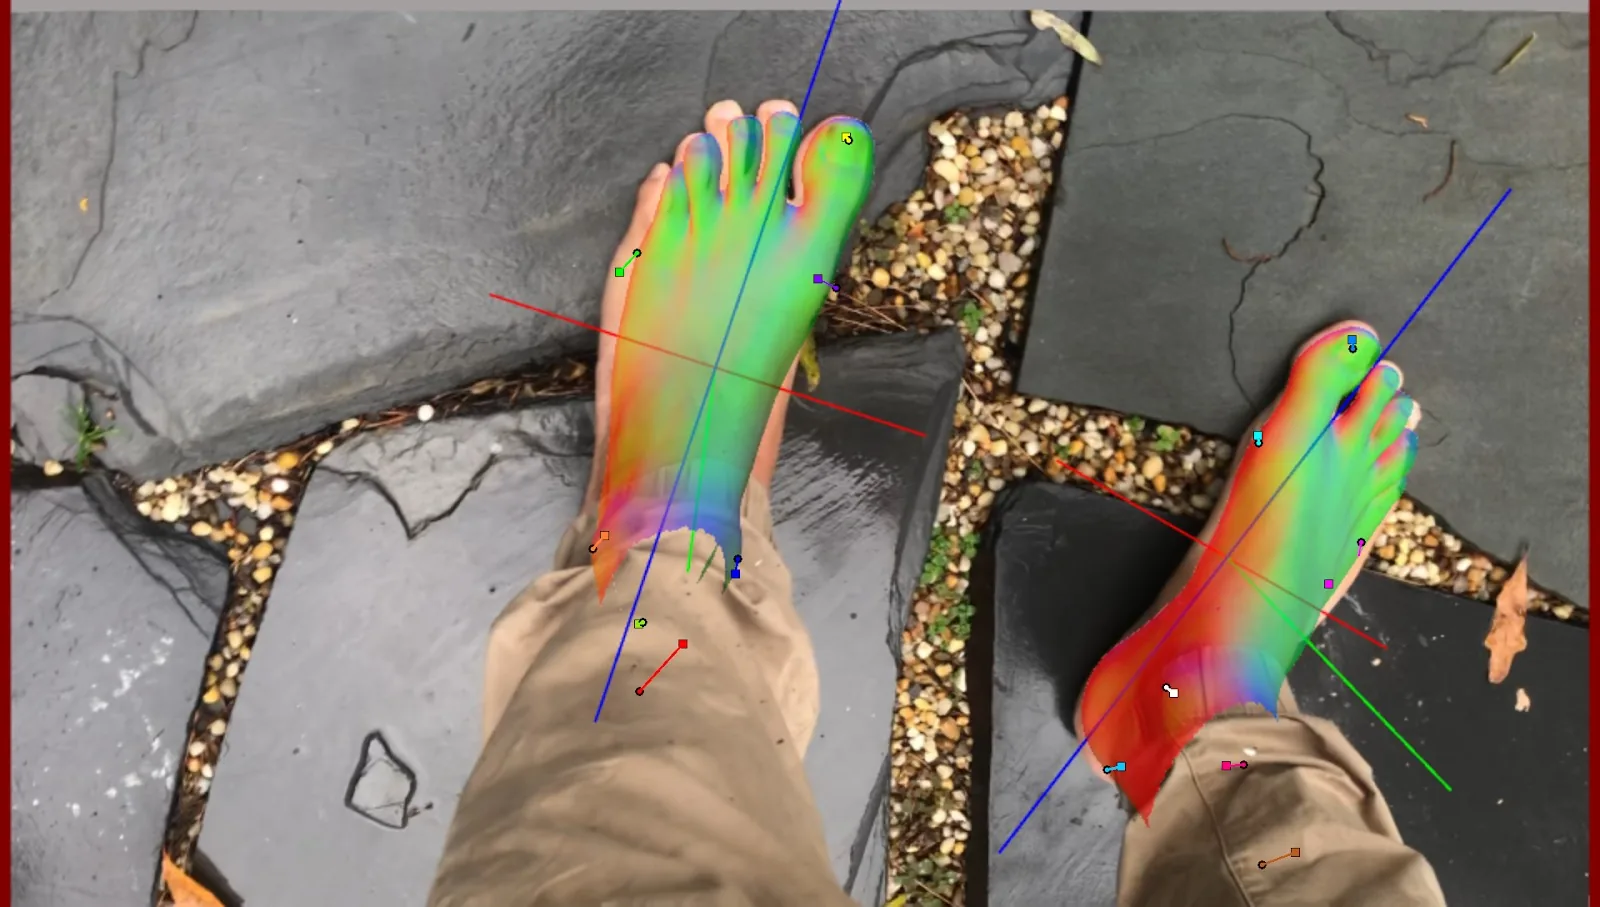
GUI-Ausgabe - Überlagerung des 3D-Modells
Mit einer guten Schätzung der 3D-Keypoint-Positionen projizieren wir die Punkte mithilfe der intrinsischen und extrinsischen Kameramatrizen für jedes Bild des Videos zurück auf 2D-Bildpositionen:
3D-Keypoints, zurückprojiziert in 2D-Videobilder
Halbautomatisches Labeln
Eine Möglichkeit, das Labeln noch weiter zu beschleunigen, wäre, gar keine Bilder mehr labeln zu müssen. Ein Ansatz, den wir kurz untersucht haben, bestand darin, ein neuronales Netz die Videos automatisch labeln zu lassen, über mehrere Zyklen aus Training und Labeln derselben Daten.
Wie kann man ein Netz trainieren, bevor man gelabelte Daten hat? Wir haben das per Bootstrapping mit einem ersten Modell geringer Qualität gelöst, das auf rein synthetischen Fußdaten trainiert wurde (mehr dazu hier). Auch wenn die einzelnen 2D-Vorhersagen pro Bild schlecht sind, können wir sie alle zusammenführen und mithilfe der bekannten Kameraposen die 3D-Positionen optimieren. Die resultierenden 3D-Positionen sollten genauer sein als die Vorhersagen einzelner Bilder, da wir auf den geringsten Reprojektionsfehler über alle Vorhersagen pro Bild optimieren.
Sobald wir ein gelabeltes Video haben, können wir das ursprüngliche Netz mit diesen neuen gelabelten Trainingsdaten erneut trainieren und die Keypoint-Schätzung schließlich mit dem neu trainierten Netz wiederholen. Bisher haben wir erst einen einzigen Zyklus aus Training, Labeln und erneutem Training abgeschlossen, aber die Ergebnisse sind vielversprechend. Schon im ersten Zyklus ist leicht zu erkennen, wo Fehler einzelner Bilder durch die Optimierung über alle Bilder korrigiert werden:
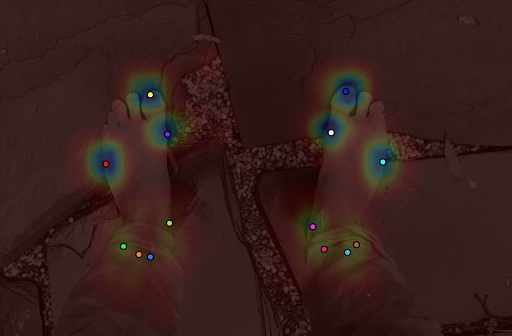
Korrekte Vorhersagen für Einzelbilder + Heatmap
In diesem Bild sind Linien von den falschen Vorhersagen einzelner Bilder zu den per Multi-View optimierten Vorhersagen eingezeichnet:
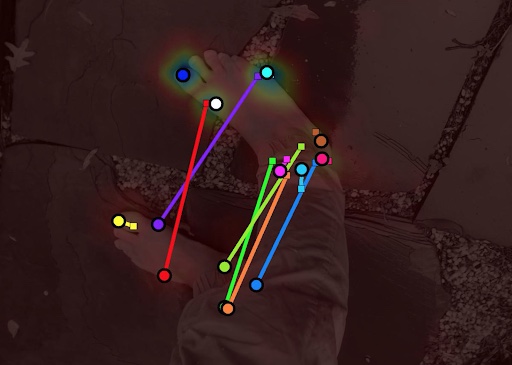
Falsche Vorhersage für ein einzelnes Bild
Augmentierung durch Hintergrundentfernung
Schließlich lassen sich unsere Daten auch durch Data Augmentation noch weiter nutzen. Neben den üblichen Augmentierungen (z. B. Rotation, Translation, Skalierung) haben wir auch mit Hintergrundentfernung experimentiert, um zufällige Hintergründe in die Bilder einzusetzen. Aus Zeitgründen haben wir die remove.bg-API verwendet, doch es gibt mehrere Open-Source-Ansätze für dieses Problem. Die Ergebnisse dieser Tests waren vielversprechend. Auch wenn im Vordergrund oft Artefakte zurückbleiben, dürfte es immer noch reichlich Variation geben, aus der das Netz lernen kann.
Mit remove.bg verarbeitetes Video
Videos mit einem gleichmäßigeren Hintergrund werden deutlich besser verarbeitet:
Besser mit remove.bg verarbeitetes Video
Es sollte außerdem möglich sein, das 3D-Mesh bzw. die Tiefenkarten und die zeitliche Konsistenz einzusetzen, um die Hintergrundentfernung zu steuern.
Weitere mögliche Vorteile der 3D-Rekonstruktion
- Tiefenkarten (allerdings mit unbekanntem absolutem Maßstab)
- Auch andere Annotationen lassen sich auf andere Bilder übertragen
- Semantische Segmentierung durch Bemalen des Meshes
Relighting
Das Mesh lässt sich nutzen, um Bilder neu auszuleuchten und noch mehr Variationen zu erzeugen:
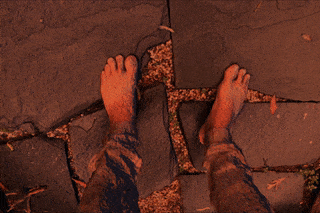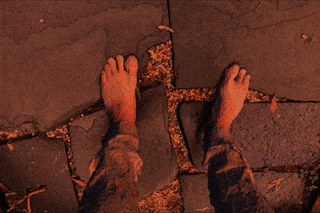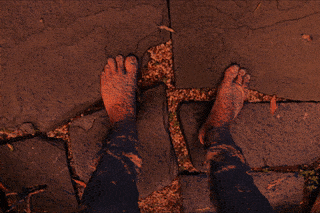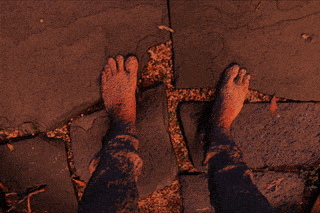
Bilder anhand von Mesh-Informationen neu ausleuchten (Relighting)
Arbeiten Sie mit uns
Wenn Sie Hilfe dabei brauchen, Daten zu maximieren oder zu erzeugen, schreiben Sie uns eine E-Mail.
Zusammenarbeit mit Laan Labs
Computer-Vision- & KI-Entwicklung
Individuelle Computer Vision und maschinelles Lernen, vom Proof of Concept bis zur Produktion, auf dem Gerät und in der Cloud.
Diesen Artikel herunterladen
Markdown-Quelltext zum Offline-Lesen herunterladen