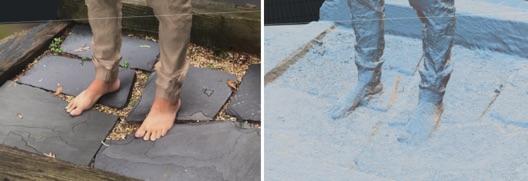
Tirer parti de la photogrammétrie pour annoter les données plus efficacement

Vue d'ensemble
Pour un projet récent, nous avons réalisé le prototype d'une application de réalité augmentée d'essayage virtuel de chaussures. Sa création demandait un réseau de neurones d'estimation de pose, entraîné sur des images annotées avec des points clés 2D correspondant à des emplacements sur les pieds.
Créer ces images annotées demande généralement qu'une personne utilise une interface graphique pour pointer et cliquer sur chaque point de chaque image. Pour des objets simples, c'est faisable bien que long, mais pour des objets 3D plus complexes, dont les points clés peuvent être occultés ou difficiles à localiser avec précision, cette stratégie peut devenir impraticable quand l'objectif se chiffre en milliers d'images. Nous avons exploré des flux de travail de photogrammétrie pour accélérer l'annotation dans notre situation particulière.
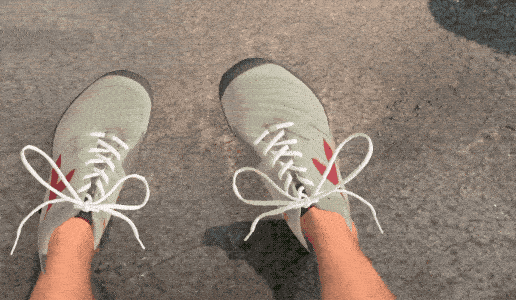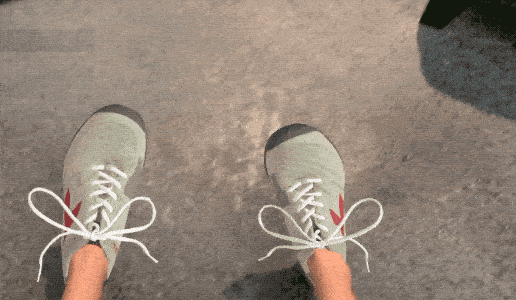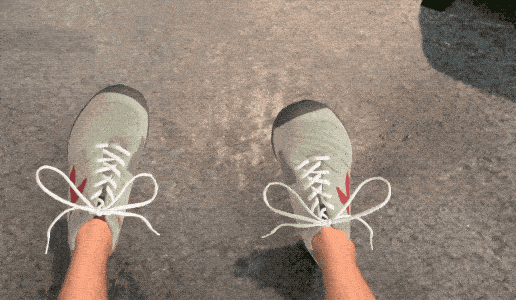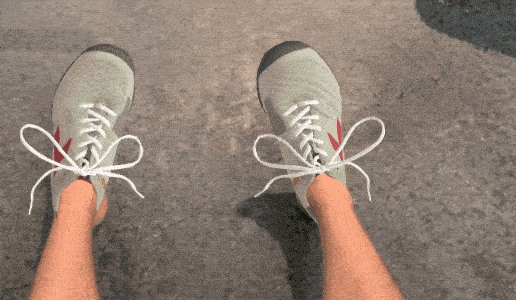
Démo finale
Notre approche
Nous avons capturé avec un téléphone mobile des vidéos de chaussures, composées de plusieurs tours autour des pieds d'une personne. À l'aide d'un logiciel de photogrammétrie du commerce, nous estimons les poses 3D de la caméra pour chaque image de la vidéo et construisons une représentation en maillage 3D de la scène. Nous annotons ensuite les points clés 2D du pied sur plusieurs images de la vidéo. Combiner les annotations 2D et les poses 3D de la caméra permet d'estimer les positions 3D de ces points clés dans la scène 3D reconstruite.
Grâce aux poses de caméra, nous pouvons reprojeter les positions 3D des points clés en coordonnées 2D pour n'importe quel point de vue capturé dans la vidéo. Si une vidéo dure 90 secondes à 30 images par seconde, nous obtenons 2700 images annotées pour le même effort que l'annotation de 4 images seulement.
Qu'est-ce que la photogrammétrie et la SFM ?
Un logiciel de photogrammétrie prend en entrée de nombreuses photos d'un même objet ou d'une même scène vus sous différents angles, et reconstruit un modèle 3D de cette scène.
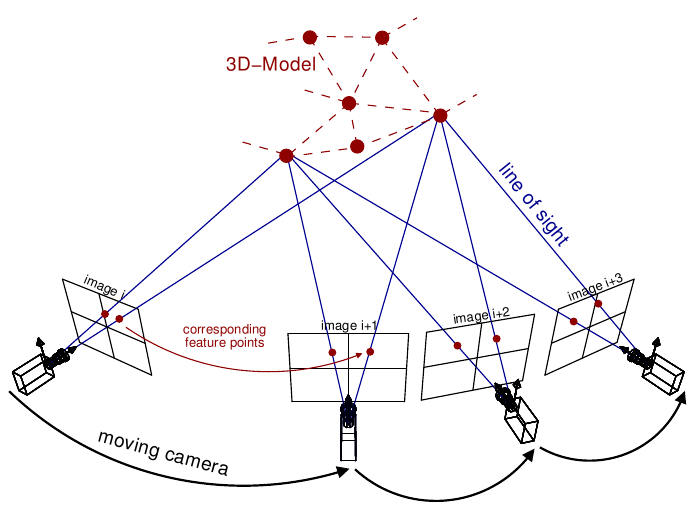
Source : Theia-sfm.org (2016)
L'une des étapes de ce processus consiste à estimer la pose 3D de la caméra pour chaque photo. Le résultat final de la photogrammétrie est un maillage 3D, mais nous n'avons besoin que des poses de caméra utilisées pour le créer. On pourrait aussi utiliser le modèle 3D pour rendre une infinité de points de vue de l'objet, mais nous avons constaté que le réalisme d'un rendu 3D n'égalait pas la qualité des photos, même si c'est une piste que nous aimerions explorer davantage.
Logiciels de photogrammétrie
Il existe de nombreuses options de logiciels de photogrammétrie, des solutions gratuites et open source aux produits payants. Nous avons choisi de nous concentrer sur Alicevision Meshroom (gratuit) et Reality Capture (payant), principalement pour la facilité d'installation et la rapidité d'obtention d'un résultat. Nous avons constaté que Reality Capture était beaucoup plus rapide et générait de meilleures poses de caméra et de meilleures reconstructions que Meshroom. Meshroom a toutefois quelques avantages : il est gratuit, open source et scriptable. Reality Capture dispose bien d'une interface en ligne de commande, mais elle exige une formule tarifaire plus élevée (à notre dernière vérification ; ils sont depuis passés à un modèle de paiement à l'image, qui peut être différent)
NOTE : si vous souhaitez seulement retrouver les poses de caméra et non obtenir une reconstruction 3D, un pipeline de photogrammétrie complet n'est pas forcément nécessaire ; des logiciels comme COLMAP, OpenSFM ou OpenMVG peuvent convenir.
Une autre option que nous avons brièvement testée consistait à enregistrer des vidéos tout en utilisant ARKit pour capturer les poses de caméra. Cette option nous fournirait les poses de caméra gratuitement, sans aucun post-traitement. Nous avons constaté que le jitter et l'accumulation d'erreurs étaient trop importants pour les types de vidéos que nous enregistrions. Si votre application porte sur une scène assez statique, riche en caractéristiques visuelles, avec de courtes vidéos, ARKit/ARCore pourrait être une solution plus simple. (Voir aussi l'article récent de Google sur la collecte de données d'entraînement avec cette méthode.)
Capture des données
Nous extrayons d'abord les images brutes de la vidéo à une certaine cadence :
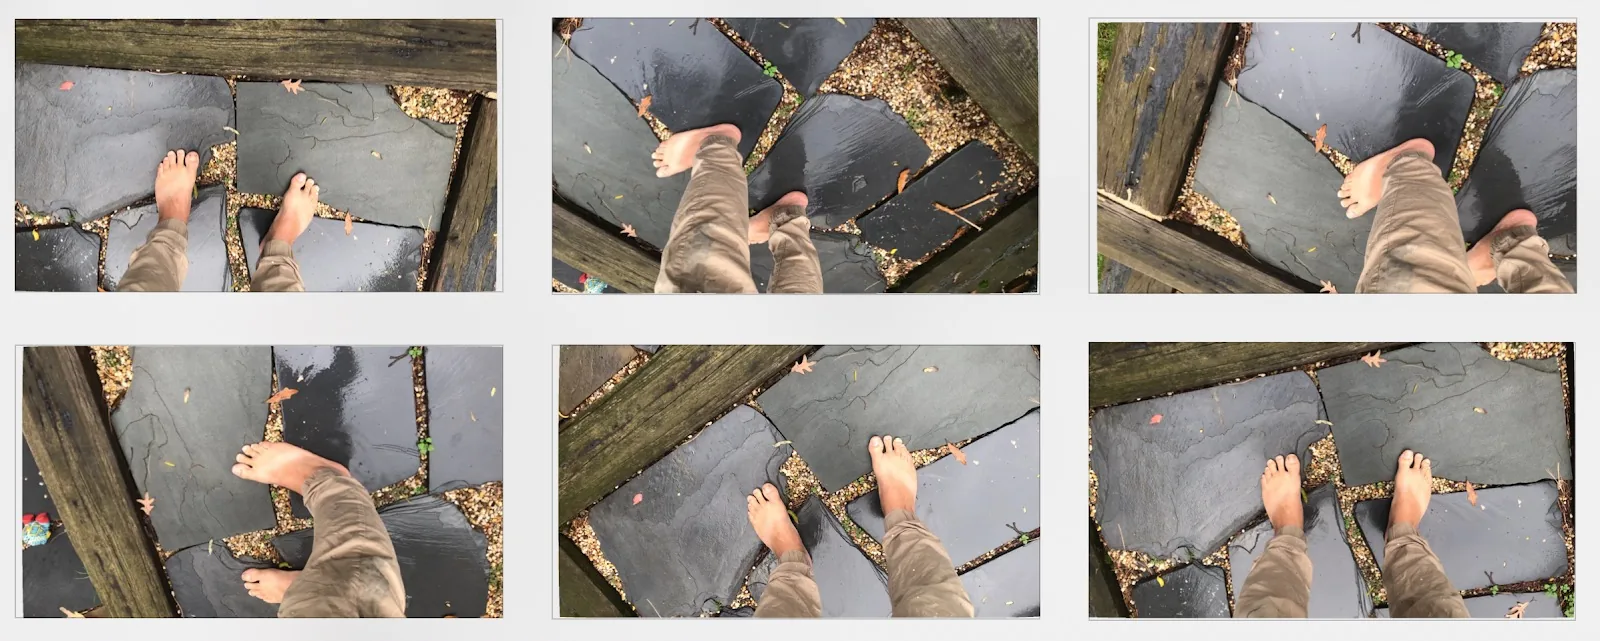
6 exemples d'images vidéo parmi les 500 utilisées pour la reconstruction
Ensuite, nous passons les images extraites à Reality Capture, ce qui donne le maillage et les poses de caméra suivants :
Poses de caméra et modèle reconstruit
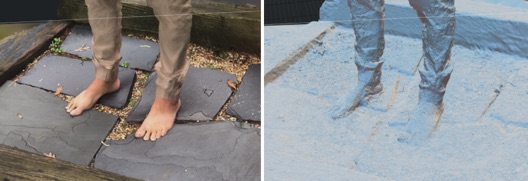
Reconstruction Reality Capture
Automatiser Reality Capture
Cela a demandé un peu d'efforts, car la CLI n'était pas une option pour nous à l'époque. Nous avons fini par écrire un script d'automatisation Windows pour charger et traiter toutes nos données vidéo. Reality Capture permet d'exporter les poses de caméra dans divers formats.
Automatiser Alicevision Meshroom
Meshroom est assez simple à utiliser avec la CLI, même si nous avons rencontré quelques accrocs. Nous avons publié un notebook jupyter sur ce dépôt github qui montre comment transformer une vidéo en maillage 3D, extraire les poses de caméra et enfin refaire le rendu de la vidéo avec le maillage en surimpression, le tout depuis Python.
Génération des points clés du pied
Maintenant que nous avons les poses de caméra pour chaque image, il faut trouver les positions des points clés image par image. Le but est de n'annoter qu'un petit sous-ensemble de l'ensemble des images de la vidéo. Les deux méthodes que nous avons testées sont l'annotation 2D et l'annotation 3D.
Annotation 3D
Le résultat de l'étape de photogrammétrie fournit une reconstruction en maillage ; une option consiste donc à utiliser un logiciel de modélisation 3D pour placer les points clés directement sur les pieds dans notre scène 3D. Combinées aux poses de caméra, ces positions 3D peuvent être reprojetées dans chaque image de la vidéo. Nous avons créé un petit script blender pour faciliter la création et l'export des points clés. Au départ, cette méthode semblait la meilleure option pour deux raisons :
- Il suffit d'annoter chaque vidéo une seule fois
- La gestion des points clés occultés n'est pas un problème, puisqu'il suffit de faire pivoter le modèle 3D jusqu'à ce que le point clé soit visible
Après quelques tests, nous avons constaté que cette méthode était assez chronophage, et plus lente que la seconde option, l'annotation 2D décrite ci-dessous. Cette lenteur tenait probablement aux aspects pratiques d'une prise en main rapide de blender. Comme nous ne sommes pas des utilisateurs avancés de blender, déplacer 14 petites sphères en 3D prenait plus de temps que cliquer sur une image 2D. Avec plus de temps, une meilleure UX pour placer les points clés 3D dans blender pourrait accélérer beaucoup les choses. La configuration idéale serait en VR, où l'on place directement les points clés en 3D plutôt que sur un écran 2D.
Annotation 2D
Nous avons finalement opté pour l'approche plus banale consistant à utiliser une interface graphique pour cliquer sur les positions 2D de chaque point clé dans l'image. Cela doit être fait sur plusieurs images réparties dans la vidéo afin de trianguler les positions 3D des points clés.
Pendant l'annotation, nous visualisons un modèle 3D de pied à partir de l'estimation courante des positions 3D des points clés ; cela donne un retour sur la précision de l'annotation en cours. Dès que la pose du pied paraît correcte sur plusieurs images, nous pouvons arrêter d'annoter.
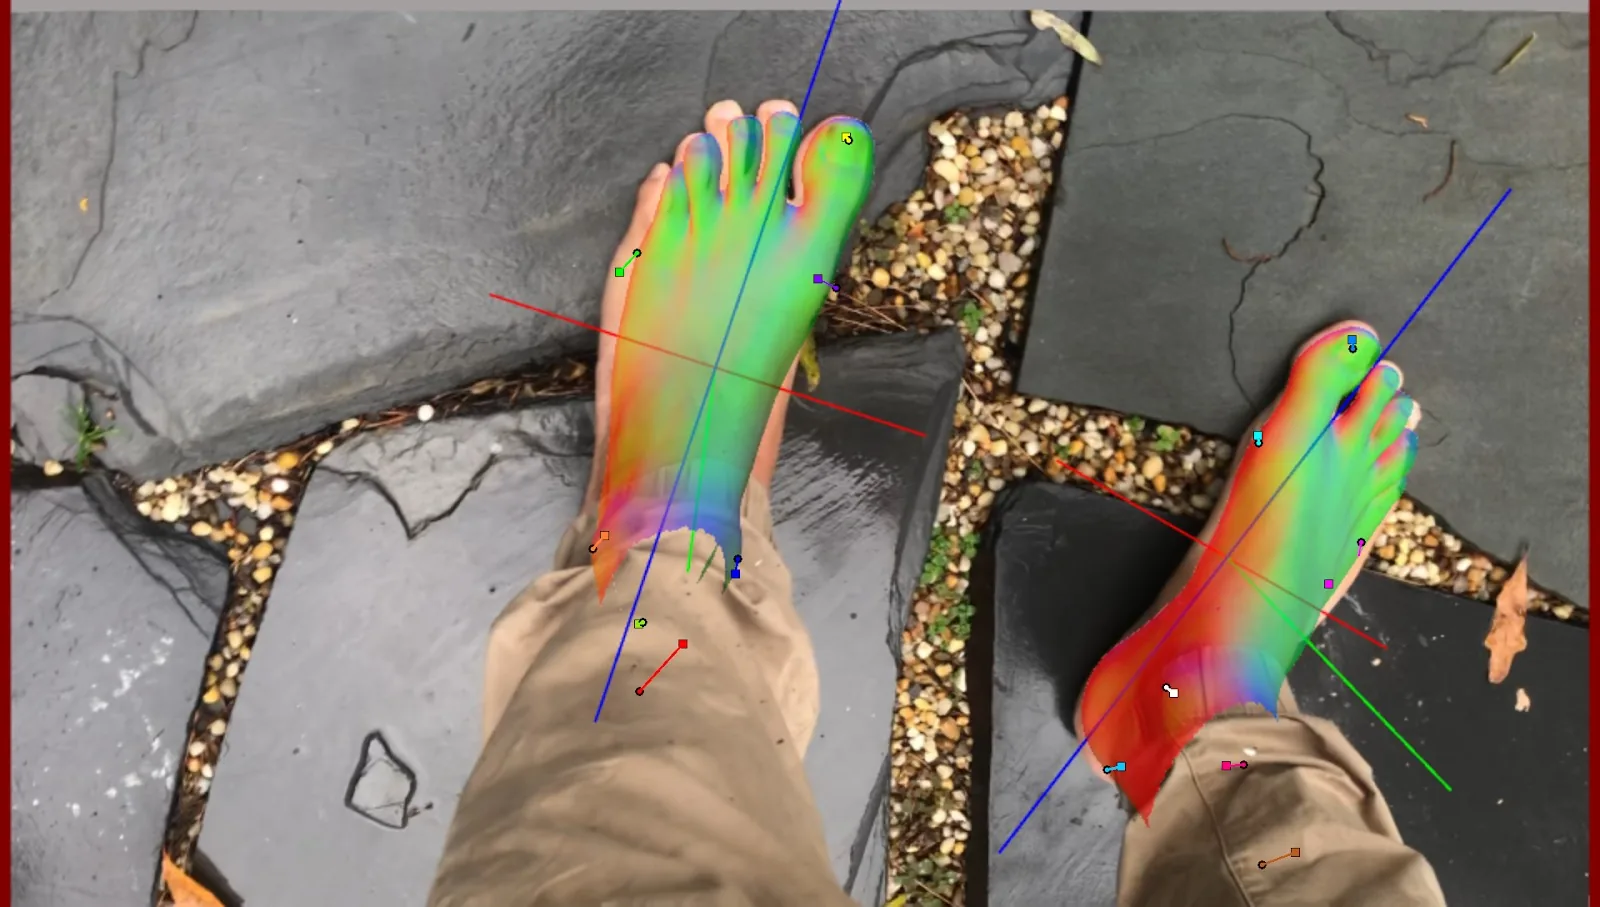
Sortie de l'interface - superposition du modèle 3D
Avec une bonne estimation des positions 3D des points clés, nous utilisons les matrices intrinsèque et extrinsèque de la caméra pour reprojeter les points en positions 2D dans l'image, pour chaque image de la vidéo :
Points clés 3D reprojetés dans les images vidéo 2D
Annotation semi-automatique
Une façon d'accélérer encore l'annotation consisterait à ne plus avoir à annoter aucune image. Une approche que nous avons brièvement explorée consistait à utiliser un réseau de neurones pour annoter automatiquement les vidéos au fil de plusieurs cycles d'entraînement + annotation des mêmes données.
Comment entraîner un réseau avant d'avoir des données annotées ? Nous l'avons fait par amorçage (bootstrapping), avec un premier modèle de faible qualité entraîné uniquement sur des données de pieds synthétiques (en savoir plus ici). Même si les prédictions 2D image par image sont mauvaises, nous pouvons toutes les combiner et optimiser les positions 3D à l'aide des poses de caméra connues. Les positions 3D obtenues devraient être plus précises que les prédictions individuelles par image, puisque nous optimisons pour obtenir l'erreur de reprojection la plus faible en tenant compte de toutes les prédictions par image.
Une fois que nous avons une vidéo annotée, nous pouvons ré-entraîner le réseau d'origine en y intégrant ces nouvelles données d'entraînement annotées, puis relancer l'estimation des points clés avec le réseau nouvellement entraîné. Jusqu'ici, nous n'avons terminé qu'un seul cycle entraînement / annotation / ré-entraînement, mais les résultats sont prometteurs. Même dès le premier cycle, on voit facilement où les erreurs par image sont corrigées par l'optimisation sur l'ensemble des images :
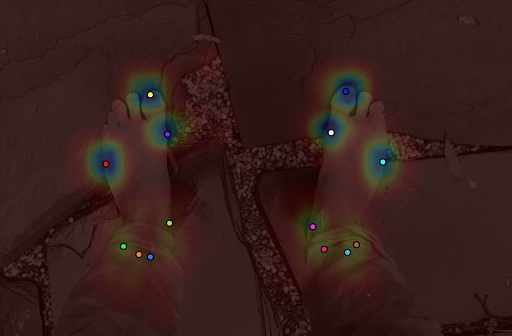
Prédictions correctes sur image unique + carte de chaleur
Sur cette image, des lignes relient les prédictions erronées sur image unique aux prédictions optimisées multivues :
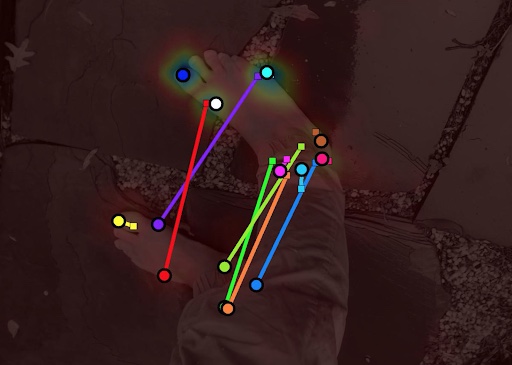
Prédiction incorrecte sur une image unique
Augmentation par suppression de l'arrière-plan
Enfin, une manière d'exploiter encore davantage nos données est l'augmentation de données. En plus des augmentations standard (rotation, translation, mise à l'échelle, etc.), nous avons aussi essayé d'utiliser la suppression d'arrière-plan pour placer des arrière-plans aléatoires dans les images. Par souci de rapidité, nous avons utilisé l'API remove.bg, mais il existe plusieurs approches open source pour ce problème. Les résultats de ces tests étaient prometteurs. Même si des artefacts subsistent souvent au premier plan, il devrait rester assez de variations pour que le réseau puisse apprendre.
Vidéo traitée avec Remove.bg
Les vidéos avec un arrière-plan plus uniforme sont bien mieux gérées :
Meilleure vidéo traitée avec remove.bg
Il devrait aussi être possible d'utiliser le maillage 3D / les cartes de profondeur et la cohérence temporelle pour guider la suppression de l'arrière-plan.
Autres bénéfices potentiels de la reconstruction 3D
- Cartes de profondeur (même si l'échelle absolue est inconnue)
- Les autres annotations se transfèrent elles aussi d'une image à l'autre
- Segmentation sémantique par peinture du maillage
Rééclairage
Le maillage peut servir à rééclairer les images pour obtenir encore plus de variations :
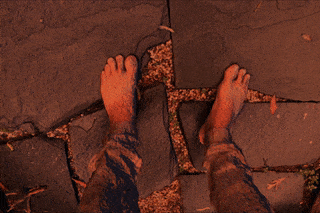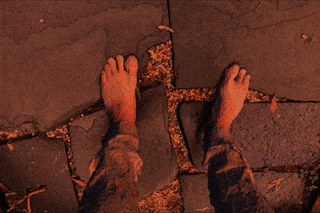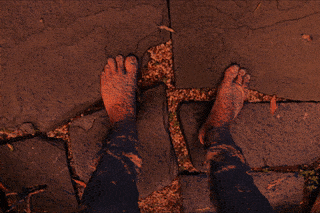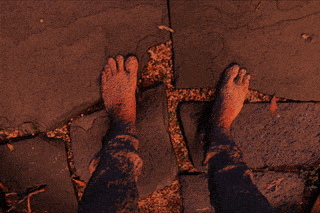
Rééclairage des images à partir des informations du maillage
Travaillez avec nous
Si vous avez besoin d'aide pour maximiser ou générer des données, envoyez-nous un e-mail.
Travailler avec Laan Labs
Développement de vision par ordinateur et d’IA
De la vision par ordinateur et du machine learning sur mesure, de la preuve de concept à la production, sur l’appareil comme dans le cloud.
Télécharger cet article
Récupérez la source Markdown pour le lire hors ligne