利用摄影测量提高数据标注效率

概述
在最近的一个项目中,我们做了一个 AR 虚拟试鞋应用的原型。要实现它,需要一个姿态估计神经网络,并且要用标注了脚部位置对应的 2D 关键点的图像来训练。
制作这些带标签的图像,通常需要有人使用图形界面,在每张图像上逐点点击。对于简单的物体,这样做虽然耗时但还可行;而对于更复杂的 3D 物体,关键点的位置可能被遮挡或者很难精确定位,当目标是数千张图像时,这种做法就变得不切实际了。针对我们这种特殊情况,我们探索了利用摄影测量工作流来加快标注过程。
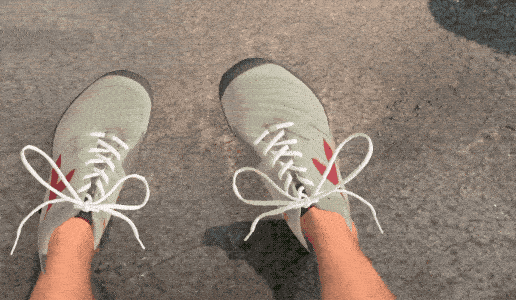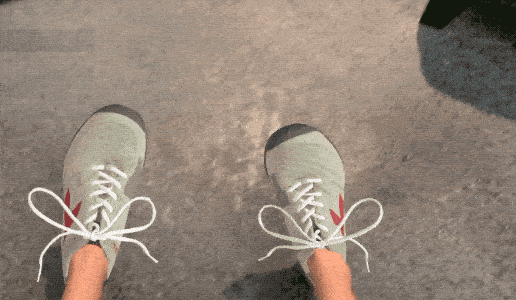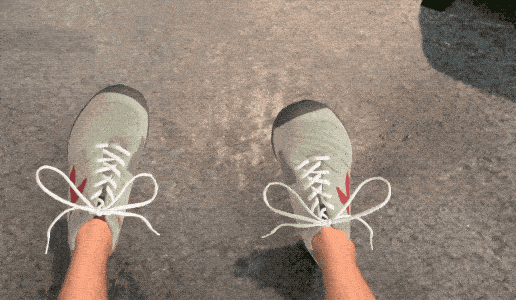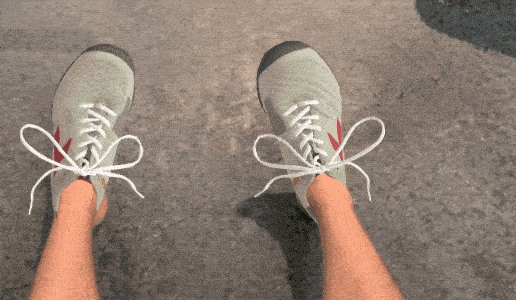
最终演示
我们的方法
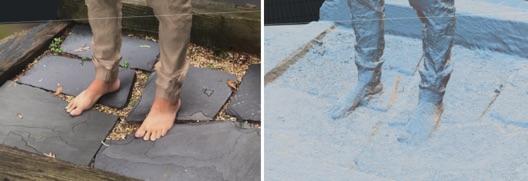
我们用手机拍摄鞋子的视频,围绕某人的双脚环绕拍摄了几圈。使用现成的摄影测量软件,我们估计出每一帧视频的 3D 相机位姿,并构建场景的 3D 网格表示。然后,我们在视频的若干帧上标注 2D 脚部关键点。把 2D 标注与 3D 相机位姿结合起来,就能估计出这些关键点在重建出的 3D 场景中的 3D 位置。
借助相机位姿,我们可以把 3D 关键点位置重新投影回视频中捕捉到的任意相机视角下的 2D 坐标。如果一段视频长 90 秒,以每秒 30 帧拍摄,那么我们现在就有 2700 帧带标签的图像,而工作量只相当于标注 4 帧。
什么是摄影测量和 SFM?
摄影测量软件接收大量从不同角度拍摄的同一物体或场景的照片,并重建出该场景的 3D 模型。
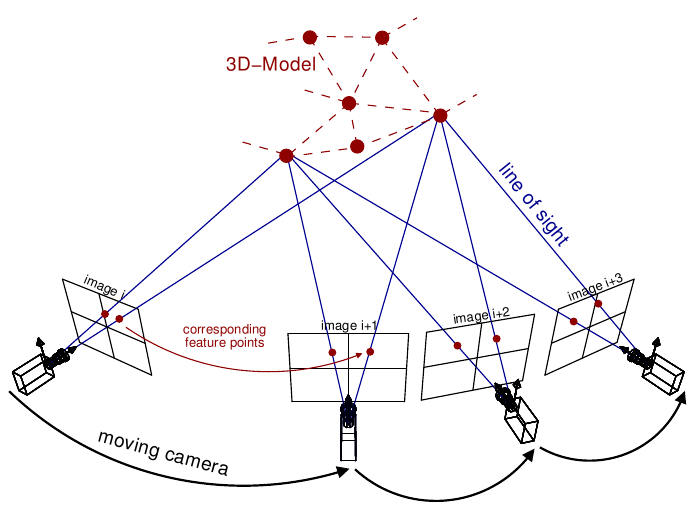
来源:Theia-sfm.org (2016)
这个过程中的一个步骤,是为每张照片估计 3D 相机位姿。摄影测量的最终成果是 3D 网格,但我们只需要用来生成这个网格的相机位姿。你也可以用这个 3D 模型渲染出物体无限多个视角,但我们发现 3D 渲染的真实感达不到照片的质量,不过这一点我们还想继续探索。
摄影测量软件
摄影测量软件有很多选择,从免费开源的到付费产品都有。我们主要出于安装方便、能快速得到结果的考虑,重点关注了 Alicevision meshroom(免费)和 Reality Capture(付费)。我们发现 Reality Capture 要快得多,生成的相机位姿和重建结果也比 meshroom 更好。不过 Meshroom 也有几个优势:它免费且开源,并且可以脚本化。Reality Capture 确实有命令行界面,但要使用它需要更高的定价档位(据我们上次查看的情况,此后他们已改为按图像付费的模式,情况可能有所不同)
注意:如果你只想恢复相机位姿,而不需要 3D 重建,那就不一定需要完整的摄影测量流水线;COLMAP、OpenSFM 或 OpenMVG 这类软件就可以胜任。
我们还简单测试过另一种方案:录制视频的同时用 ARKit 获取相机位姿。这样不需要任何后处理,就能免费得到相机位姿。我们发现,对于我们录制的这类视频,抖动和误差累积太严重了。如果你的应用场景比较静态、视觉特征丰富,并且视频较短,那么 ARKit/ARCore 可能是更简单的方案。(另见 Google 最近的论文,其中介绍了用这种方法采集训练数据。)
采集数据
首先,我们以一定的 FPS 从视频中提取原始图像:
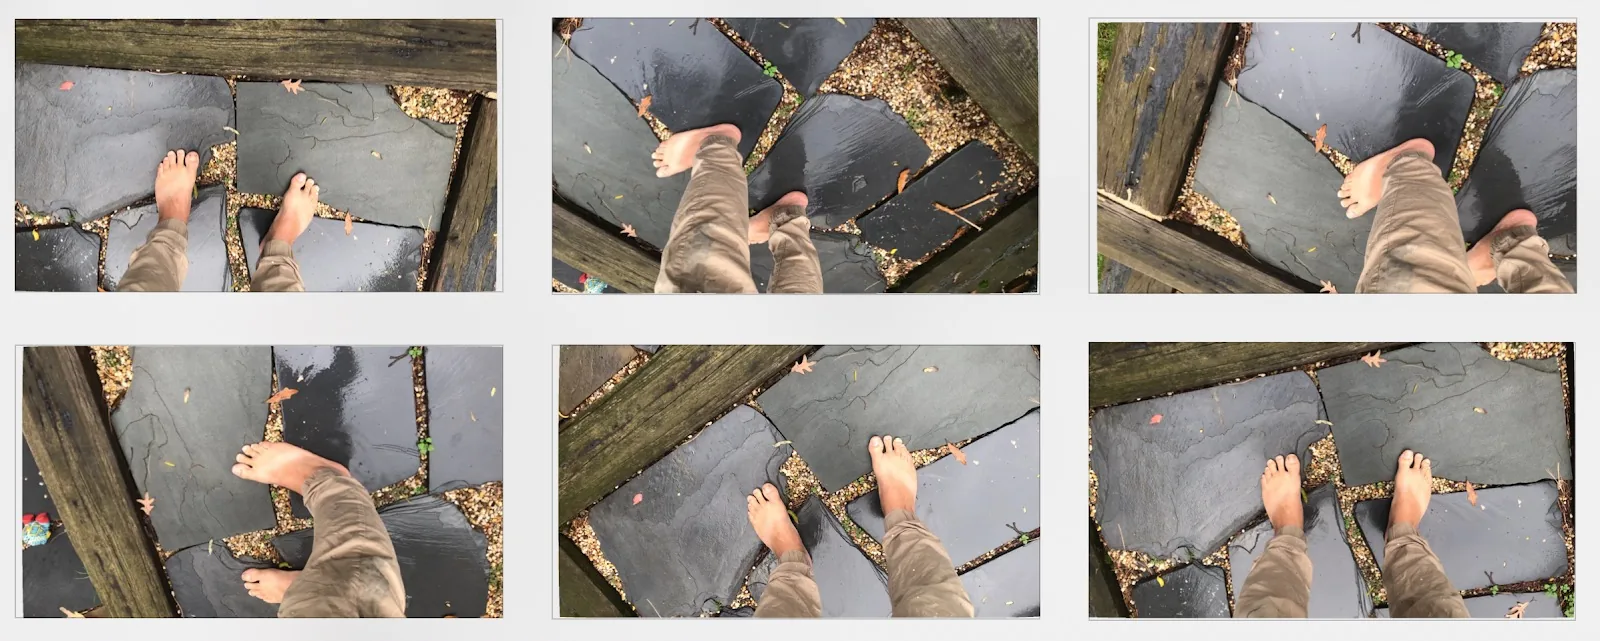
用于重建的 500 帧中的 6 帧样例
其次,我们把提取的帧送入 Reality Capture,得到如下的网格和相机位姿:
相机位姿与重建出的模型
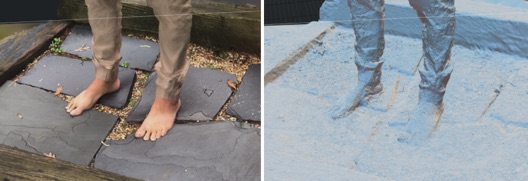
Reality Capture 重建结果
自动化 Reality Capture
这需要花一些功夫,因为当时我们用不了命令行界面。我们最终编写了一个 Windows 自动化脚本,来加载并处理我们所有的视频数据。Reality Capture 支持以多种格式导出相机位姿。
自动化 Alicevision Meshroom
Meshroom 通过命令行使用起来相当简单,不过我们也碰到了一些小麻烦。我们在这个 GitHub 仓库中发布了一个 jupyter notebook,演示了如何完全用 python 把视频处理成 3D 网格、提取相机位姿,最后把网格叠加在视频上重新渲染。
生成脚部关键点
现在每一帧都有了相机位姿,接下来需要为每一帧找出关键点的位置。这里的目标是只标注视频总帧数中的一小部分。我们为此测试了两种方法:2D 标注和 3D 标注。
3D 标注
摄影测量阶段的输出给出了网格重建结果,所以一种选择是使用 3D 建模软件,直接在 3D 场景中的脚上放置关键点。结合相机位姿,我们可以把这些 3D 位置投影回视频的每一帧。我们编写了一个小的 blender 脚本,来辅助创建和导出关键点。起初,出于两个原因,这种方法看起来是最佳选择:
- 每段视频只需要标注一次
- 不用担心关键点被遮挡的问题,因为只要旋转 3D 模型,直到关键点出现在视野中即可
经过一些测试,我们发现这种方法相当耗时,比下面介绍的第二种方案 2D 标注还慢。速度慢很可能与在 blender 中快速做出可用的东西这一实际困难有关。我们不是 blender 的高级用户,在 3D 中移动 14 个小球所花的时间,比在 2D 图像上点击要长。如果时间更充裕,在 blender 中设计更好的 3D 关键点放置交互,也许能大大提速。这里理想的方案是在 VR 中,直接在 3D 空间中放置关键点,而不是使用 2D 显示器。
2D 标注
最终,我们选择了更无趣的方法:使用图形界面,在 2D 图像上为每个关键点点击位置。需要对视频中的若干帧都这样做,才能三角化出关键点的 3D 位置。
在标注过程中,我们会用当前估计出的 3D 关键点位置可视化一个 3D 脚部模型,这样可以对当前标注的准确性给出反馈。一旦脚部姿态在多帧中看起来都正确,我们就可以停止标注。
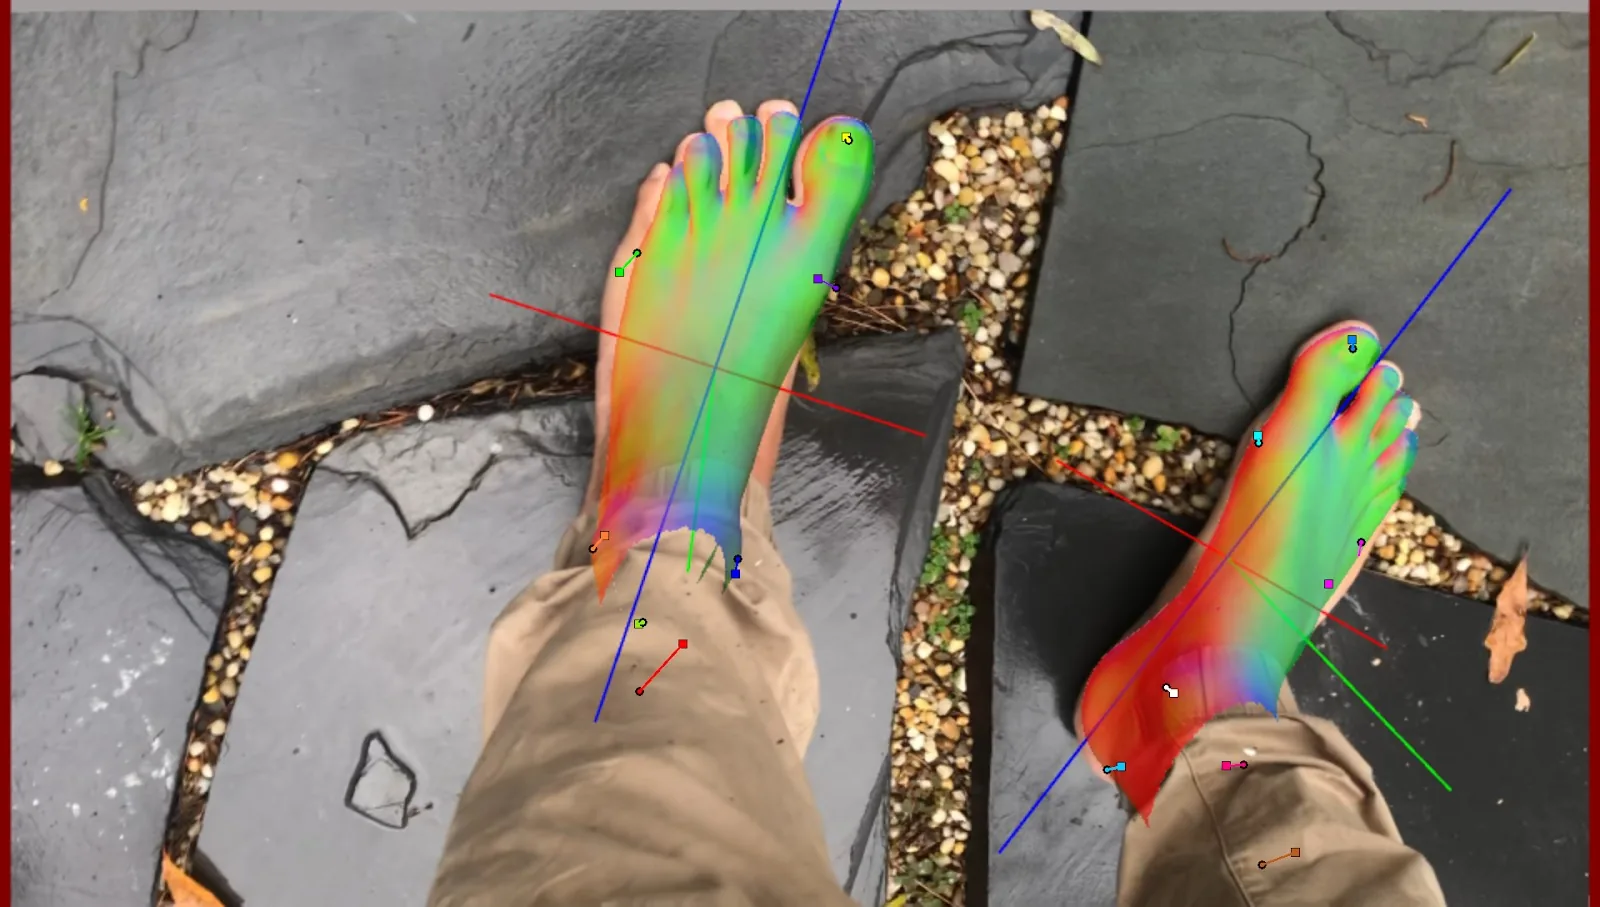
GUI 输出:3D 模型叠加
在得到较准确的 3D 关键点位置之后,我们使用相机内参和外参矩阵,把这些点重新投影为视频每一帧中的 2D 图像位置:
3D 关键点重新投影到 2D 视频帧
半自动标注
要进一步加快标注过程,一种办法是完全不需要标注任何帧。我们简单探索过的一种思路,是通过对同一批数据进行若干轮“训练 + 标注”的循环,用神经网络自动为视频打标签。
在还没有标注数据时,怎么训练网络呢?我们的做法是自举(bootstrapping):先用纯合成的脚部数据训练一个初始的低质量模型(详情见这里)。虽然单帧的 2D 预测很差,但我们可以把它们全部合并起来,利用已知的相机位姿来优化 3D 位置。由于我们优化的是综合考虑所有单帧预测后得到的最小重投影误差,最终得到的 3D 位置应当比单帧预测更准确。
一旦有了带标签的视频,我们就可以把这些新的标注训练数据加进去,重新训练原来的网络,最后用新训练的网络重新运行关键点估计。到目前为止,我们只完成了一轮训练 / 标注 / 再训练的循环,但结果令人鼓舞。即使在第一轮,也很容易看出对所有帧进行优化后,单帧错误是如何被纠正的:
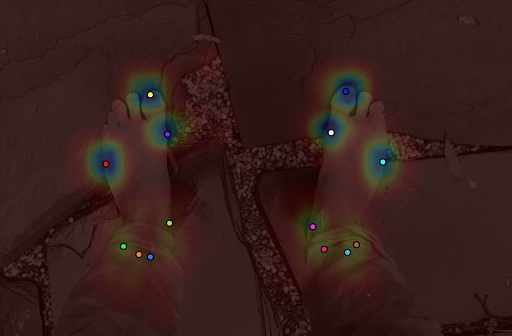
正确的单张图像预测 + 热力图
在这张图中,画出了从单帧错误预测指向多视角优化后预测的连线:
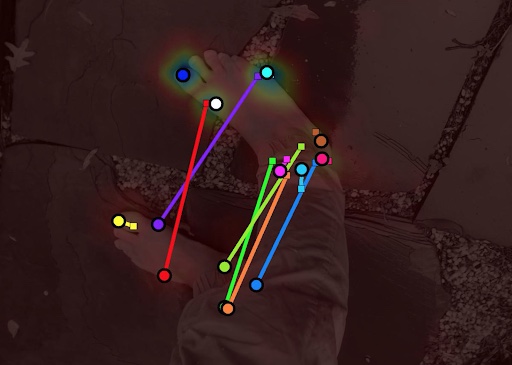
单帧的错误预测
背景去除增强
最后,进一步利用我们数据的一种方式是数据增强。除了标准的增强手段(例如旋转、平移、缩放)之外,我们还试验了用背景去除功能,为图像设置随机背景。为了快速,我们使用了 remove.bg API,不过这个问题也有好几种开源的解决方案。这些测试的结果令人鼓舞。尽管前景中常常仍有伪影,但依然应该有足够多的变化可供网络学习。
remove.bg 处理后的视频
背景较为统一的视频处理效果要好得多:
效果更好的 remove.bg 处理视频
还应该可以利用 3D 网格 / 深度图和时间一致性,来指导如何去除背景。
3D 重建的其他潜在收获
- 深度图(不过绝对尺度未知)
- 其他标注同样可以在帧与帧之间传递
- 通过网格绘制实现语义分割
重新打光
网格还可以用来为图像重新打光,从而获得更多变化:
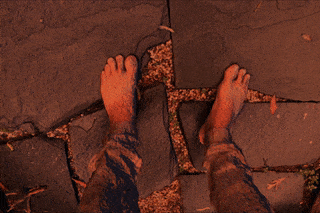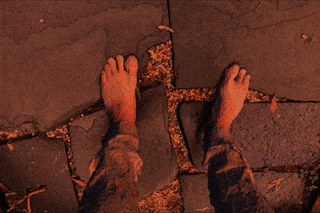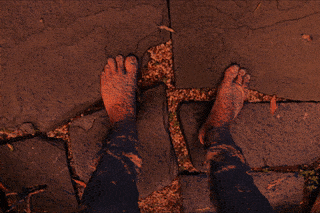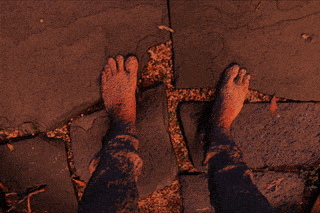
利用网格信息为图像重新打光
与我们合作
如果您需要帮助来最大化利用或生成数据,欢迎给我们发邮件。
与 Laan Labs 合作
计算机视觉与 AI 开发
定制计算机视觉与机器学习,从概念验证到正式投产,支持设备端与云端。
下载本文
获取 Markdown 源文件,方便离线阅读