Cómo aprovechar la fotogrametría para aumentar la eficiencia de la anotación de datos

Descripción general
Para un proyecto reciente creamos el prototipo de una aplicación de realidad aumentada para probarse zapatos virtualmente. Para construirla hacía falta una red neuronal de estimación de pose entrenada con imágenes anotadas con puntos clave 2D correspondientes a ubicaciones del pie.
Crear estas imágenes etiquetadas suele requerir que una persona use una interfaz gráfica para hacer clic en cada punto de cada imagen. Con objetos simples es factible, aunque lleva tiempo, pero con objetos 3D más complicados, donde los puntos clave pueden quedar ocultos o ser difíciles de ubicar con exactitud, esta estrategia puede volverse impracticable cuando el objetivo son miles de imágenes. Exploramos el uso de flujos de trabajo de fotogrametría para acelerar el etiquetado en nuestro caso particular.
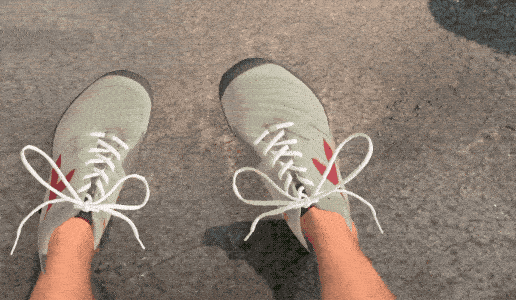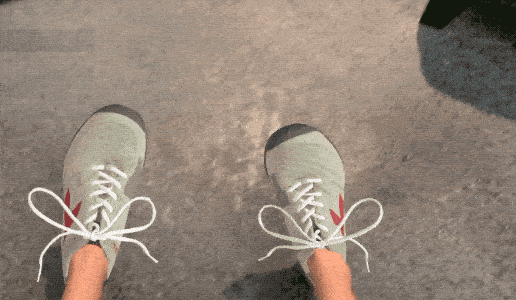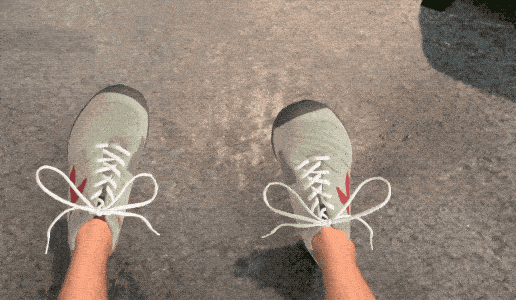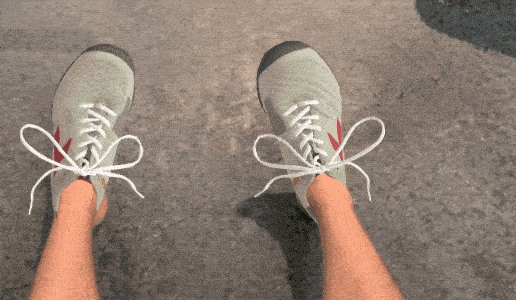
Demo final
Nuestro enfoque
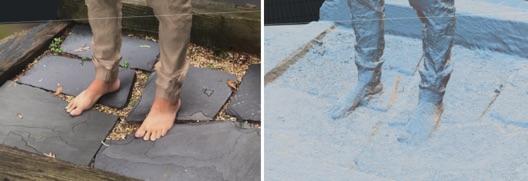
Capturamos videos con un teléfono móvil de zapatos, con varias órbitas alrededor de los pies de una persona. Con software de fotogrametría disponible en el mercado, estimamos las poses de cámara en 3D de cada fotograma del video y construimos una representación de la escena como malla 3D. Luego anotamos los puntos clave 2D del pie en varios fotogramas del video. Al combinar las anotaciones 2D con las poses de cámara 3D, podemos estimar las ubicaciones 3D de esos puntos clave en la escena 3D reconstruida.
Con las poses de cámara, podemos reproyectar las ubicaciones 3D de los puntos clave a coordenadas 2D para cualquier punto de vista de cámara capturado en el video. Si un video dura 90 segundos y se captura a 30 fotogramas por segundo, tenemos 2700 fotogramas etiquetados con el mismo esfuerzo que supone etiquetar solo 4.
¿Qué son la fotogrametría y el SFM?
El software de fotogrametría recibe muchas fotos del mismo objeto o escena vistos desde distintos ángulos y reconstruye un modelo 3D de esa escena.
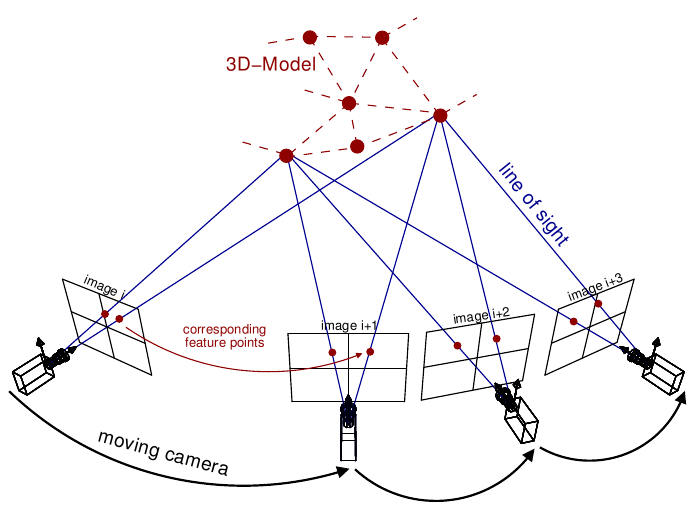
Fuente: Theia-sfm.org (2016)
Uno de los pasos de este proceso consiste en estimar la pose de cámara en 3D de cada foto. El resultado final de la fotogrametría es una malla 3D, pero nosotros solo necesitamos las poses de cámara utilizadas para crearla. También se podría usar el modelo 3D para renderizar infinitos puntos de vista del objeto, pero comprobamos que el realismo de un render 3D no igualaba la calidad de las fotos, aunque es algo que nos gustaría seguir explorando.
Software de fotogrametría
Hay muchas opciones de software de fotogrametría, desde gratuitas y de código abierto hasta productos de pago. Decidimos centrarnos en Alicevision meshroom (gratuito) y Reality Capture (de pago), principalmente por la facilidad de instalarlos y obtener un resultado rápido. Comprobamos que Reality Capture era mucho más rápido y generaba mejores poses de cámara y reconstrucciones que meshroom. Meshroom tiene, sin embargo, algunas ventajas: es gratuito, de código abierto y se puede automatizar con scripts. Reality Capture sí tiene una interfaz de línea de comandos, pero para usarla hay que contratar un nivel de precio más alto (la última vez que lo comprobamos; desde entonces han pasado a un modelo de pago por imagen que puede ser distinto)
NOTA: Si solo le interesa recuperar las poses de cámara y no una reconstrucción 3D, no necesariamente hace falta un pipeline de fotogrametría completo; podría bastar software como COLMAP, OpenSFM u OpenMVG.
Otra opción que probamos brevemente fue grabar videos usando ARKit para capturar las poses de cámara. Esta opción nos daría las poses de cámara gratis y sin ningún posprocesamiento. Comprobamos que la vibración y la acumulación de error eran excesivas para el tipo de videos que grabábamos. Si su aplicación tiene una escena bastante estática con muchas características visuales, junto con videos cortos, ARKit/ARCore podría ser una solución más sencilla. (Véase también el artículo reciente de Google sobre la recopilación de datos de entrenamiento con este método.)
Captura de datos
Primero extraemos imágenes sin procesar del video a una cierta tasa de FPS:
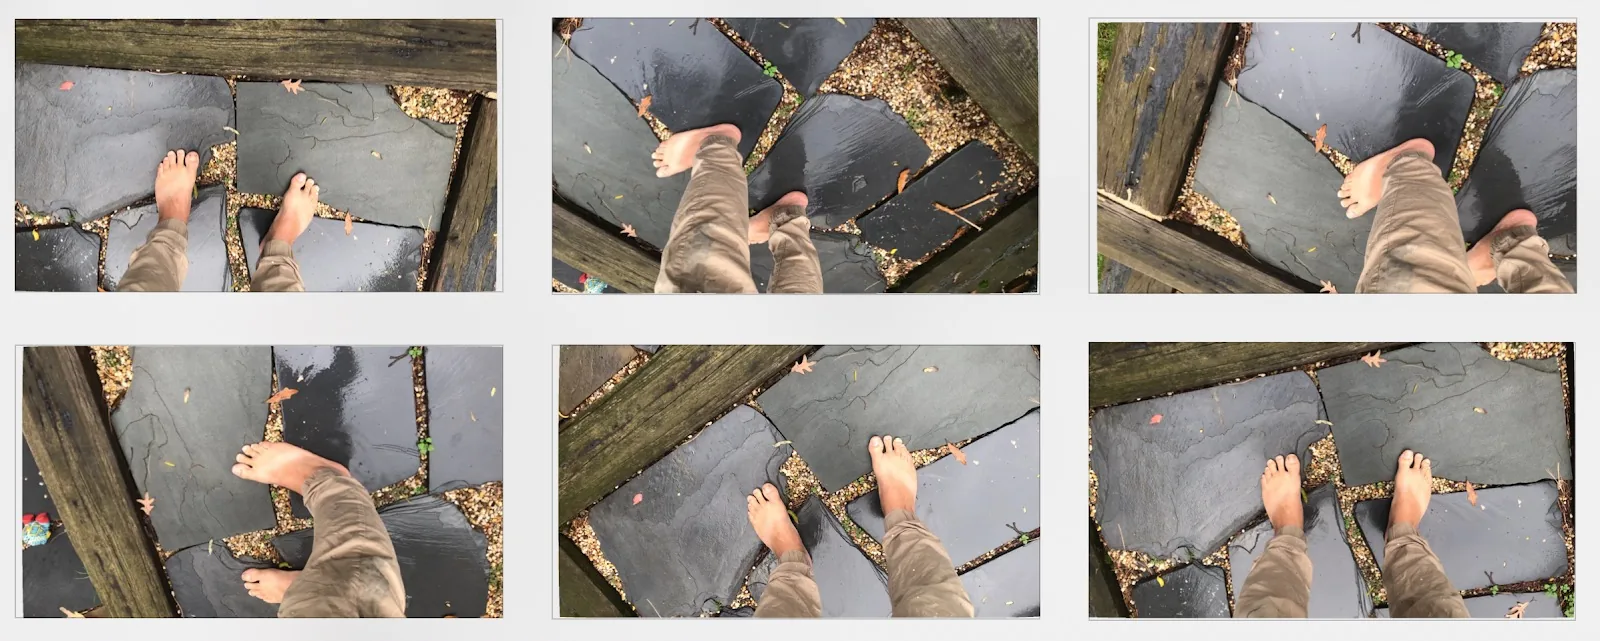
6 fotogramas de video de muestra de los 500 usados para la reconstrucción
Segundo, pasamos los fotogramas extraídos a Reality Capture, que genera la siguiente malla y las siguientes poses de cámara:
Poses de cámara junto con el modelo reconstruido
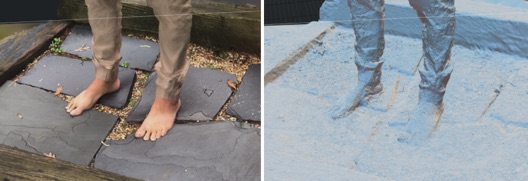
Reconstrucción con Reality Capture
Automatización de Reality Capture
Esto requirió algo de esfuerzo, ya que en ese momento la interfaz de línea de comandos no era una opción para nosotros. Terminamos escribiendo un script de automatización de Windows para cargar y procesar todos nuestros datos de video. Reality Capture permite exportar las poses de cámara en varios formatos.
Automatización de Alicevision Meshroom
Meshroom es bastante sencillo de usar desde la línea de comandos, aunque nos topamos con algunos obstáculos. Hemos publicado un notebook de Jupyter en este repositorio de GitHub que muestra cómo procesar un video para obtener una malla 3D, extraer las poses de cámara y, por último, volver a renderizar el video con la malla superpuesta, todo desde Python.
Generación de puntos clave del pie
Ahora que tenemos las poses de cámara de cada fotograma, necesitamos encontrar las ubicaciones de los puntos clave en cada uno. El objetivo es etiquetar solo un pequeño subconjunto del total de fotogramas del video. Los dos métodos que probamos para ello son la anotación 2D y la anotación 3D.
Anotación 3D
El resultado de la etapa de fotogrametría es una malla reconstruida, así que una opción es usar software de modelado 3D para colocar los puntos clave directamente sobre los pies en nuestra escena 3D. Combinado con las poses de cámara, podemos proyectar esas ubicaciones 3D de vuelta a cada fotograma del video. Creamos un pequeño script de Blender para ayudar a crear y exportar los puntos clave. Al principio este método parecía la mejor opción por dos razones:
- Solo hay que etiquetar cada video una vez
- Los puntos clave ocultos no son un problema, ya que basta con girar el modelo 3D hasta que el punto clave quede a la vista
Tras algunas pruebas comprobamos que este método consumía bastante tiempo y era más lento que la segunda opción, la anotación 2D que se describe a continuación. La lentitud probablemente tuvo que ver con las dificultades prácticas de conseguir algo funcional rápidamente en Blender. Al no ser usuarios avanzados de Blender, mover 14 esferas pequeñas en 3D llevaba más tiempo que hacer clic en una imagen 2D. Con más tiempo, una mejor experiencia de usuario para colocar los puntos clave 3D en Blender podría acelerar mucho las cosas. La configuración ideal sería en realidad virtual, donde se colocan los puntos clave directamente en 3D en lugar de usar un monitor 2D.
Anotación 2D
Finalmente optamos por el enfoque más aburrido: usar una interfaz gráfica para hacer clic en las ubicaciones 2D de la imagen de cada punto clave. Esto hay que hacerlo en varios fotogramas del video para poder triangular las posiciones 3D de los puntos clave.
Durante el proceso de anotación visualizamos un modelo 3D del pie usando la estimación actual de las ubicaciones 3D de los puntos clave; esto da información sobre la precisión de la anotación actual. Cuando la pose del pie se ve correcta en varios fotogramas, podemos dejar de anotar.
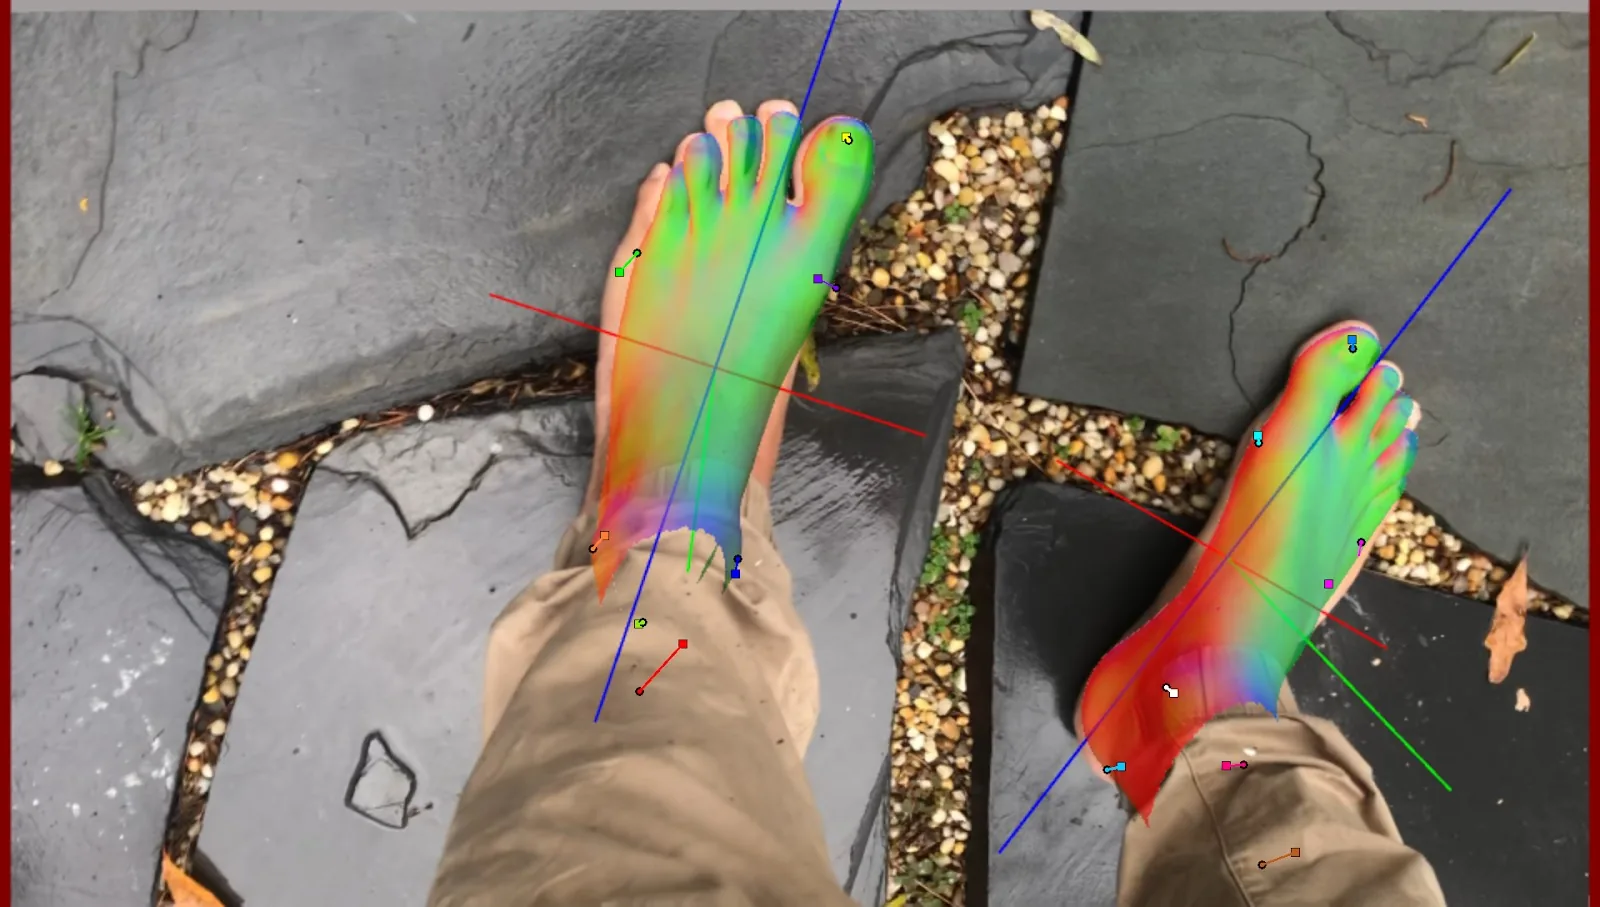
Resultado de la interfaz: superposición del modelo 3D
Con una buena estimación de las ubicaciones 3D de los puntos clave, usamos las matrices intrínseca y extrínseca de la cámara para reproyectar los puntos a ubicaciones de imagen 2D en cada fotograma del video:
Puntos clave 3D reproyectados en fotogramas de video 2D
Etiquetado semiautomático
Una forma de acelerar aún más el etiquetado sería no tener que etiquetar ningún fotograma. Un enfoque que exploramos brevemente fue usar una red neuronal para etiquetar automáticamente los videos a lo largo de varios ciclos de entrenamiento y etiquetado de los mismos datos.
¿Cómo se entrena una red antes de tener datos etiquetados? Lo hicimos partiendo de un modelo inicial de baja calidad entrenado únicamente con datos sintéticos de pies (puede leer más sobre esto aquí). Aunque las predicciones 2D individuales por fotograma son malas, podemos combinarlas todas y optimizar las ubicaciones 3D usando las poses de cámara conocidas. Las ubicaciones 3D resultantes deberían ser más precisas que las predicciones de cada fotograma, ya que optimizamos para obtener el menor error de reproyección teniendo en cuenta todas las predicciones por fotograma.
Una vez que tenemos un video etiquetado, podemos volver a entrenar la red original incorporando estos nuevos datos de entrenamiento etiquetados y, por último, repetir la estimación de puntos clave con la red recién entrenada. Hasta ahora solo hemos completado un ciclo de entrenamiento, etiquetado y reentrenamiento, pero los resultados son prometedores. Incluso en el primer ciclo, es fácil ver dónde se corrigen los errores por fotograma al optimizar sobre todos los fotogramas:
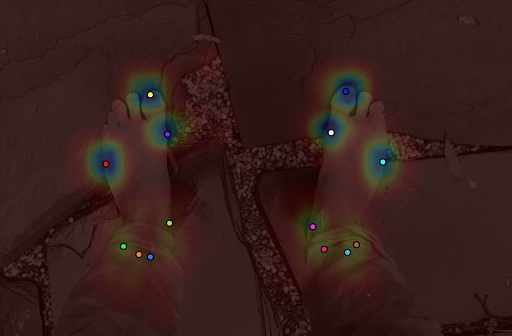
Predicciones correctas de una sola imagen + mapa de calor
En esta imagen se dibujan líneas desde las predicciones incorrectas de un solo fotograma hasta las predicciones optimizadas con múltiples vistas:
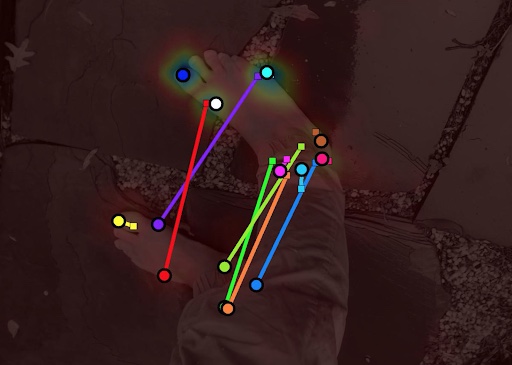
Predicción incorrecta en un solo fotograma
Aumento de datos con sustracción de fondo
Por último, una forma de aprovechar aún más nuestros datos es el aumento de datos. Además de los aumentos estándar (p. ej., rotación, traslación, escala), también experimentamos con la eliminación del fondo para establecer fondos aleatorios en las imágenes. En aras de la rapidez, usamos la API de remove.bg, pero existen varios enfoques de código abierto para este problema. Los resultados de estas pruebas fueron prometedores. Aunque a menudo quedan artefactos en el primer plano, debería haber variación de sobra para que la red aprenda.
Video procesado con remove.bg
Los videos con un fondo más uniforme se procesan mucho mejor:
Mejor video procesado con remove.bg
También debería ser posible usar la malla 3D, los mapas de profundidad y la coherencia temporal para orientar cómo se elimina el fondo.
Otras posibles ventajas de la reconstrucción 3D
- Mapas de profundidad (aunque se desconoce la escala absoluta)
- Otras anotaciones también se transfieren entre fotogramas
- Segmentación semántica mediante pintura sobre la malla
Reiluminación
La malla se puede usar para reiluminar las imágenes y obtener aún más variaciones:
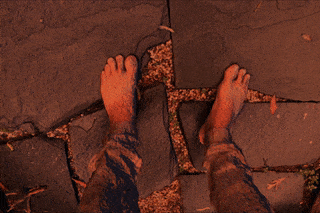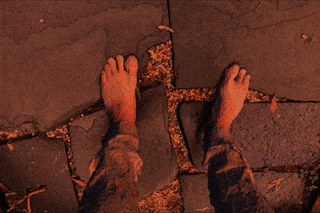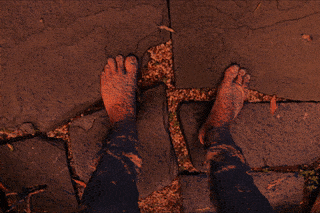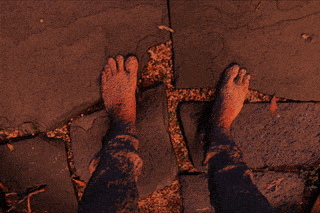
Reiluminación de imágenes a partir de la información de la malla
Trabaje con nosotros
Si necesita ayuda para aprovechar al máximo o generar datos, envíenos un correo electrónico.
Trabaje con Laan Labs
Desarrollo de visión por computador e IA
Visión por computador y aprendizaje automático a medida, de la prueba de concepto a la producción, en el dispositivo y en la nube.
Descargar este artículo
Obtenga el código fuente en Markdown para leerlo sin conexión