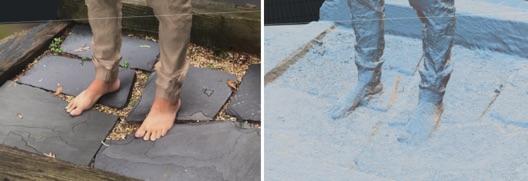
フォトグラメトリでデータアノテーションの効率を高める

概要
最近のプロジェクトで、ARによるバーチャル靴試着アプリのプロトタイプを作りました。そのためには、足の位置に対応する2Dキーポイントをアノテーションした画像で学習させた、姿勢推定ニューラルネットワークが必要でした。
こうしたラベル付き画像を作るには、通常、GUIを使って画像ごとにすべての点をクリックしていく作業が必要です。単純な物体であれば、時間はかかっても実現可能です。しかし、キーポイントの位置が隠れたり、正確に特定しにくかったりする複雑な3D物体では、目標が何千枚もの画像になると、この方法は現実的ではなくなります。そこで私たちは、今回の特殊な状況でラベル付けを高速化するために、フォトグラメトリのワークフローを活用することを検討しました。
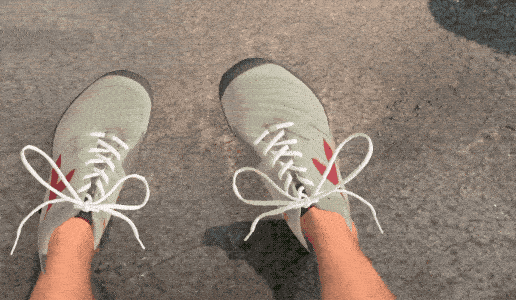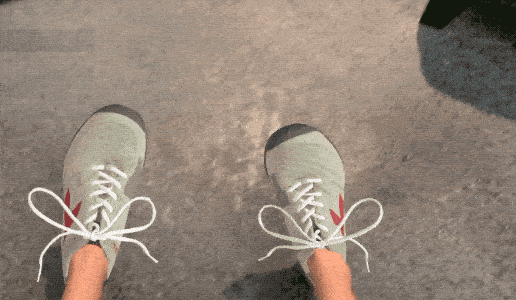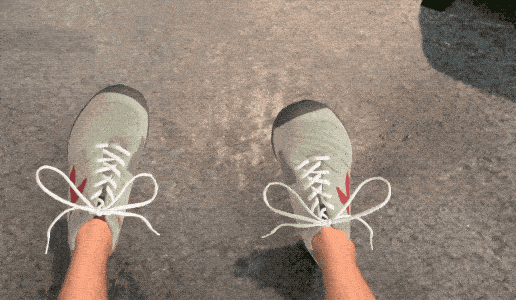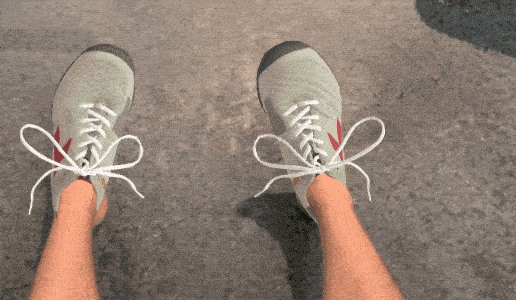
最終デモ
私たちのアプローチ
誰かの足の周りを何周かしながら、靴をスマートフォンのビデオで撮影しました。市販のフォトグラメトリソフトウェアを使い、ビデオの全フレームについて3Dのカメラポーズを推定し、シーンの3Dメッシュ表現を構築します。続いて、ビデオのうち数フレームについて、足の2Dキーポイントをアノテーションします。2Dのアノテーションと3Dのカメラポーズを組み合わせることで、再構築した3Dシーンにおけるこれらのキーポイントの3D位置を推定できます。
カメラポーズを使えば、ビデオに収められた任意のカメラ視点について、3Dキーポイントの位置を2D座標に再投影できます。30フレーム/秒で撮影した90秒のビデオなら、わずか4フレームにラベルを付ける手間で、2700枚のラベル付きフレームが得られます。
フォトグラメトリとSfMとは
フォトグラメトリソフトウェアは、同じ物体やシーンを異なる角度から撮影した大量の写真を入力として、そのシーンの3Dモデルを再構築します。
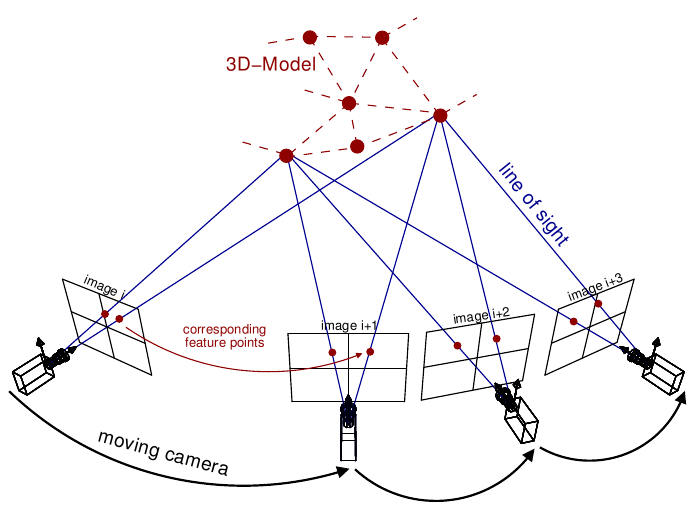
出典:Theia-sfm.org(2016)
この過程の1つのステップでは、写真ごとに3Dのカメラポーズを推定します。フォトグラメトリの最終的な成果物は3Dメッシュですが、私たちに必要なのは、そのメッシュの作成に使われたカメラポーズだけです。3Dモデルを使って、物体を任意の視点からいくらでもレンダリングすることもできますが、3Dレンダリングのリアリティは写真の品質には及ばないことがわかりました。ただし、これはさらに掘り下げてみたいテーマです。
フォトグラメトリソフトウェア
フォトグラメトリソフトウェアには、無料のオープンソースから有料製品まで、多くの選択肢があります。私たちは、インストールが簡単で素早く結果を得られるという理由から、Alicevision meshroom(無料)とReality Capture(有料)に絞って検討しました。Reality Captureのほうが処理がはるかに速く、meshroomよりも優れたカメラポーズと再構築結果が得られました。ただしmeshroomにも利点がいくつかあります。無料でオープンソースであること、そしてスクリプトで操作できることです。Reality Captureにもコマンドラインインターフェースはありますが、それを使うには上位の料金プランが必要です(最後に確認した時点の情報です。その後、画像単位の従量課金モデルに移行しており、状況が変わっている可能性があります)。
注記:3D再構築は不要でカメラポーズだけを復元したい場合は、必ずしも本格的なフォトグラメトリパイプラインは必要ありません。COLMAP、OpenSFM、OpenMVGなどのソフトウェアでも対応できる可能性があります。
もう1つ、短時間だけ試した方法として、ARKitでカメラポーズを取得しながらビデオを録画するやり方もあります。この方法なら、後処理なしでカメラポーズが手に入ります。ただ、私たちが録画していたようなビデオでは、ジッターと誤差の蓄積が大きすぎました。視覚的な特徴が豊富で、ほぼ静止したシーンを短いビデオで撮影するアプリケーションなら、ARKit/ARCoreのほうが簡単な解決策になるかもしれません。(この方法で学習データを収集するGoogleの最近の論文もあわせてご覧ください。)
データのキャプチャ
まず、ビデオから一定のFPSで生の画像を抽出します。
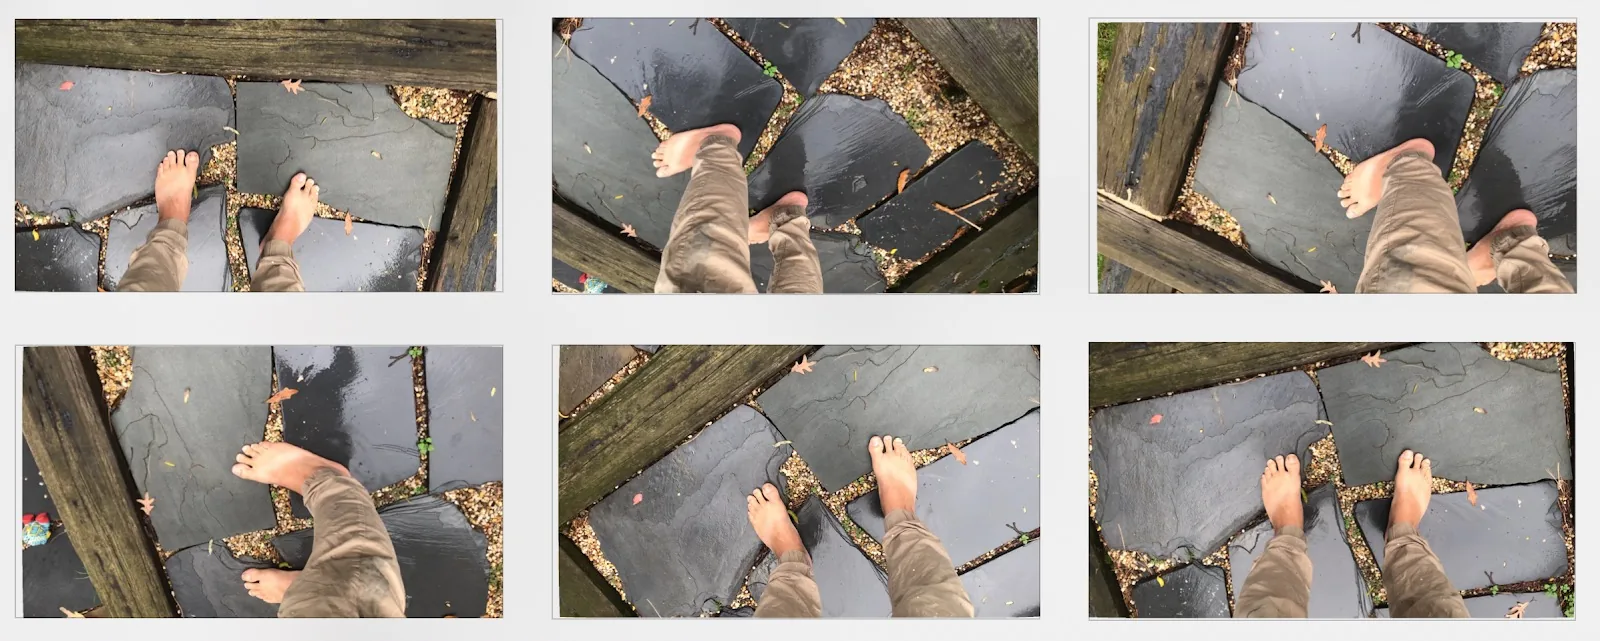
再構築に使った500フレームのうち、6フレームのサンプル
次に、抽出したフレームをReality Captureに渡し、次のようなメッシュとカメラポーズを得ます。
カメラポーズと再構築されたモデル
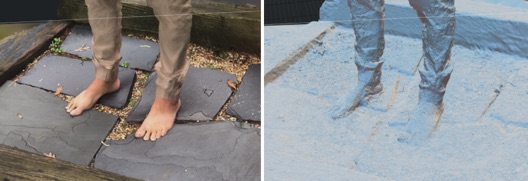
Reality Captureによる再構築
Reality Captureの自動化
当時はCLIが選択肢にならなかったため、これには多少の手間がかかりました。最終的に、すべてのビデオデータを読み込んで処理するWindowsの自動化スクリプトを書きました。Reality Captureは、カメラポーズをさまざまな形式でエクスポートできます。
Alicevision Meshroomの自動化
MeshroomはCLIで扱うのがかなり簡単ですが、いくつかつまずく点もありました。このGitHubリポジトリに、ビデオを3Dメッシュに処理し、カメラポーズを抽出し、最後にメッシュを重ねてビデオを再レンダリングするまでを、すべてPythonから行うJupyterノートブックを公開しています。
足のキーポイントの生成
これで全フレームのカメラポーズが得られたので、次はフレームごとのキーポイント位置を求める必要があります。ここでの目標は、ビデオ全体のうちごく一部のフレームだけにラベルを付けることです。そのために試した方法は、2Dアノテーションと3Dアノテーションの2つです。
3Dアノテーション
フォトグラメトリの段階でメッシュが再構築されるので、1つの選択肢は、3Dモデリングソフトウェアを使って、3Dシーン内の足に直接キーポイントを配置することです。カメラポーズと組み合わせれば、これらの3D位置をビデオの全フレームに投影し直せます。キーポイントの作成とエクスポートを補助する小さなBlenderスクリプトも作成しました。この方法は当初、次の2つの理由で最良の選択肢に思えました。
- ビデオごとに一度ラベルを付けるだけでよい
- 3Dモデルを回転させてキーポイントが見える位置にすればよいので、隠れたキーポイントが問題にならない
しばらく試してみると、この方法はかなり時間がかかり、後述する2Dアノテーションという2つ目の選択肢よりも遅いことがわかりました。速度が出なかったのは、おそらくBlenderで手早く何かを動かすための実際的な事情によるものでしょう。私たちはBlenderの熟練者ではないため、14個の小さな球を3Dで動かすほうが、2D画像をクリックするよりも時間がかかりました。時間をかければ、Blenderで3Dキーポイントを配置するためのUXを改善して、大幅に速くできるかもしれません。理想的な環境はVRで、2Dモニターではなく、3Dで直接キーポイントを配置できます。
2Dアノテーション
最終的には、より地味な方法を採用しました。キーポイントごとに、GUIで2D画像上の位置をクリックする方法です。キーポイントの3D位置を三角測量するために、ビデオ全体から数フレームについてこの作業を行う必要があります。
アノテーションの作業中は、3Dキーポイント位置の現在の推定値を使って3Dの足モデルを可視化します。これにより、現在のアノテーションの精度についてフィードバックが得られます。複数のフレームにわたって足のポーズが正しく見えたら、アノテーションを終えられます。
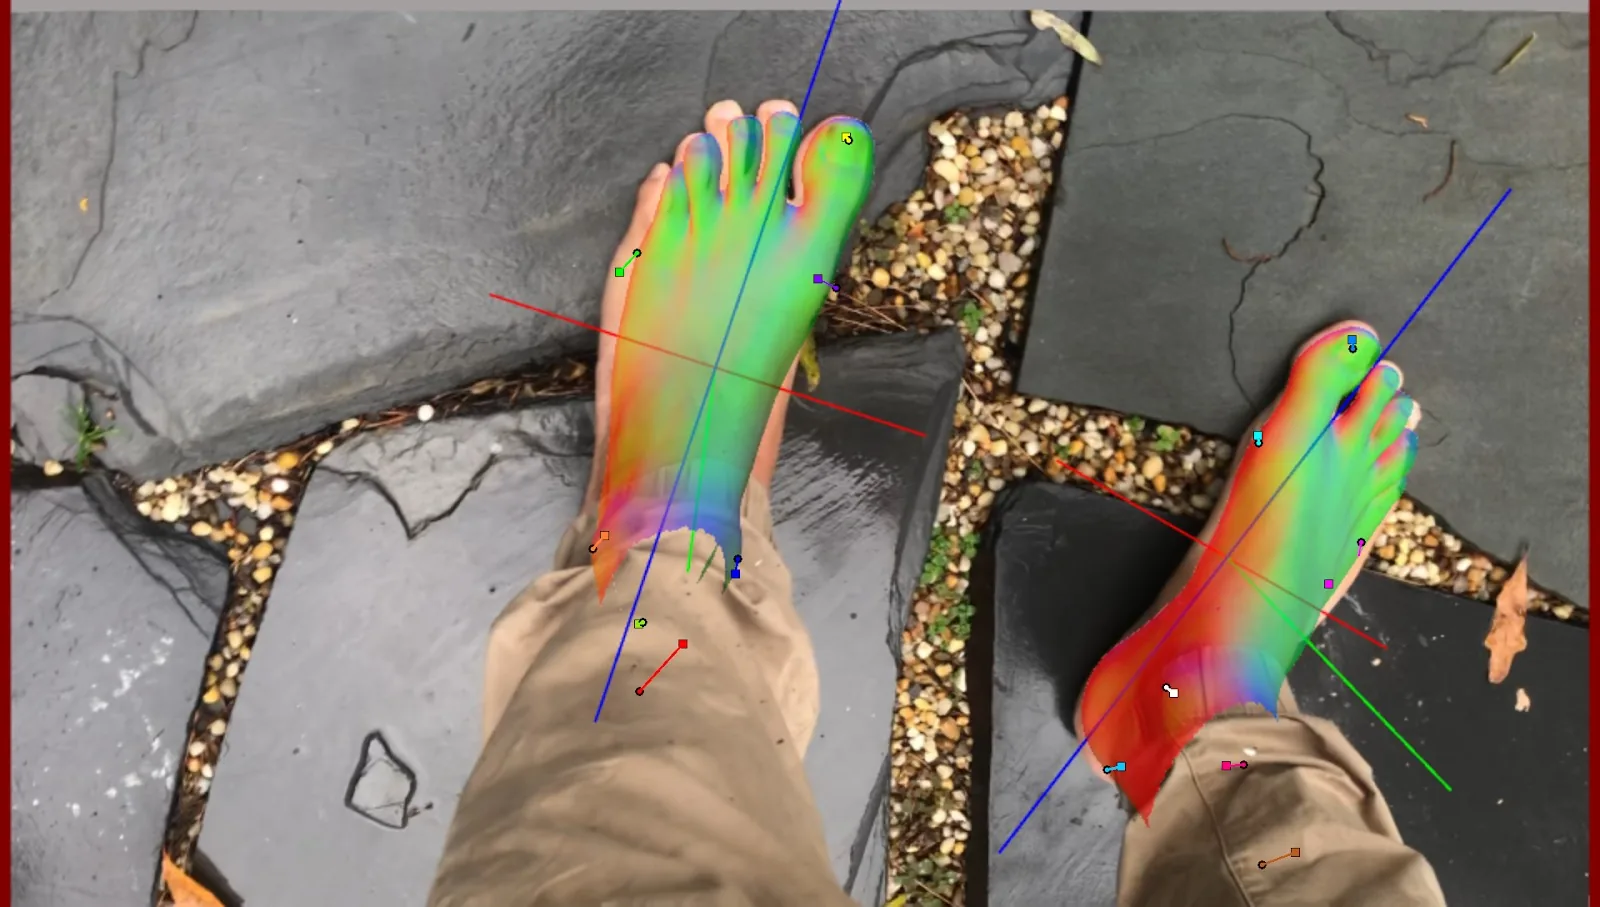
GUIの出力 - 3Dモデルのオーバーレイ
3Dキーポイント位置を適切に推定できたら、カメラの内部パラメータ行列と外部パラメータ行列を使って、ビデオの全フレームについて、それらの点を2D画像上の位置に再投影します。
3Dキーポイントを2Dビデオフレームに再投影したところ
半自動ラベリング
ラベル付けをさらに高速化する方法の1つは、フレームにまったくラベルを付けずに済ませることです。短時間だけ検討したアプローチとして、同じデータに対する学習とラベル付けを何サイクルか繰り返しながら、ニューラルネットワークでビデオに自動でラベルを付ける方法がありました。
ラベル付きデータがない状態で、どうやってネットワークを学習させるのでしょうか。私たちは、純粋に合成した足のデータだけで学習させた、初期の低品質なモデルでブートストラップしました(詳しくはこちらをご覧ください)。フレーム単位の2D予測は個々には不正確でも、それらをすべて組み合わせ、既知のカメラポーズを使って3D位置について最適化できます。フレームごとの予測すべてを考慮して再投影誤差が最小になるように最適化するため、得られる3D位置は、個々のフレームの予測よりも正確になるはずです。
ラベル付きのビデオができたら、この新しいラベル付き学習データを加えて元のネットワークを再学習し、新たに学習したネットワークでキーポイントの推定をやり直せます。これまでに完了したのは学習、ラベル付け、再学習のサイクル1回だけですが、結果は有望です。最初のサイクルでも、全フレームにわたる最適化によって、フレーム単位の誤りが補正される様子がはっきりとわかります。
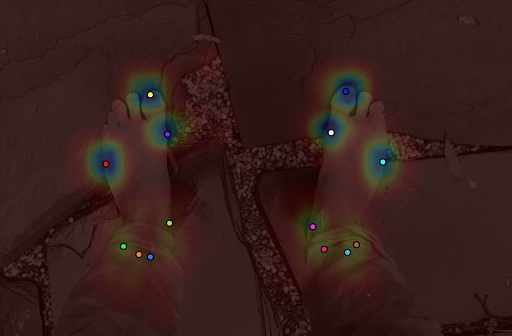
単一画像の正しい予測 + ヒートマップ
この画像では、単一フレームの誤った予測から、マルチビューで最適化した予測に向かって線が引かれています。
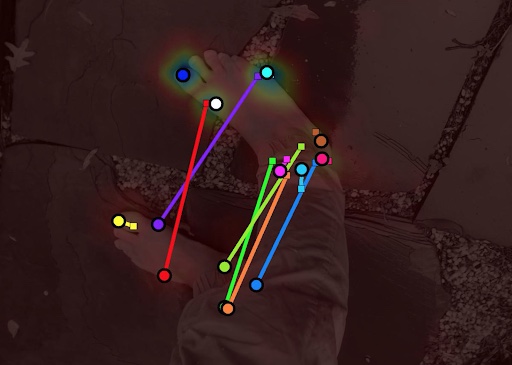
単一フレームでの誤った予測
背景除去によるデータ拡張
最後に、データをさらに活用する方法の1つがデータ拡張です。標準的な拡張(回転、平行移動、拡大縮小など)に加えて、背景除去を使って画像の背景をランダムなものに置き換える方法も試しました。手早く進めるためにremove.bg APIを使いましたが、この課題にはオープンソースのアプローチもいくつかあります。このテストの結果は有望でした。前景にアーティファクトが残ることが多くても、ネットワークが学習するのに十分なバリエーションは得られるはずです。
remove.bgで処理したビデオ
背景がより均一なビデオは、はるかにうまく処理されます。
より良好なremove.bgの処理結果
3Dメッシュや深度マップ、時間的な一貫性を、背景の除去方法の手がかりにすることも可能なはずです。
3D再構築から得られるその他の副産物
- 深度マップ(ただし絶対スケールは不明)
- その他のアノテーションもフレーム間で転用できる
- メッシュへのペイントによるセマンティックセグメンテーション
リライティング
メッシュを使って画像をリライティングすれば、さらに多くのバリエーションを作れます。
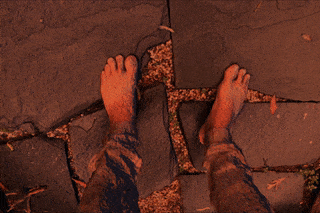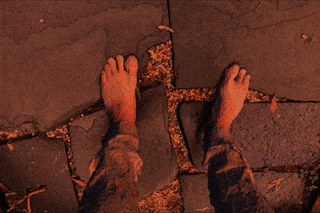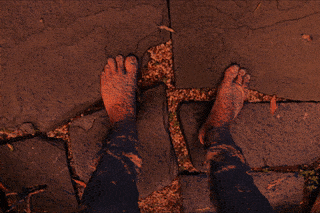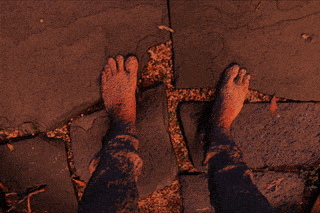
メッシュ情報を用いた画像のリライティング
ご相談ください
データの最大活用や生成についてお困りの場合は、メールをお送りください。
Laan Labs と協業する
コンピュータビジョン・AI開発
概念実証から本番運用まで、オンデバイスでもクラウドでも対応するカスタムのコンピュータビジョンと機械学習を提供します。
この記事をダウンロード
オフラインで読めるMarkdownソースを入手できます