Synthetische Daten zum Lösen eines fiesen CAPTCHAs

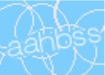
Beispiel-CAPTCHA
Im Verlauf eines Projekts stießen wir bei einer Software, für die wir bezahlen, auf ein Bild-CAPTCHA. Wir mussten die Software automatisieren, damit sie über Nacht läuft, und konnten die CAPTCHAs deshalb nicht jedes Mal von Hand ausfüllen. CAPTCHAs haben generell viele Nachteile, zum Beispiel sind sie für blinde und sehbehinderte Nutzer nicht barrierefrei. Außerdem gelten sie ohnehin nicht mehr als sehr wirksam.
Wir brauchten schnell eine Lösung, idealerweise nach wenigen Stunden Hacken. Das schien ein guter Anwendungsfall für synthetische Daten und Machine Learning zu sein.
Datengenerierung
Die offensichtliche Herausforderung beim Lösen eines solchen CAPTCHAs besteht darin, einige tausend Trainingsbilder zu beschaffen, bei denen wir die Antwort kennen. Unser Ansatz war, mit einer Grafikbibliothek zufällig so viele Bilder zu erzeugen, wie wir brauchen, die dem Original-CAPTCHA ähnlich genug sehen. Da wir die Zeichen, mit denen wir unsere gefälschten Bilder erzeugen, bereits kennen, können wir unser Modell darauf trainieren, diese Antworten vorherzusagen.
Ich habe das ImageDraw-Modul aus PIL verwendet, um ähnliche Bilder zu erzeugen, hier einige Beispiele:
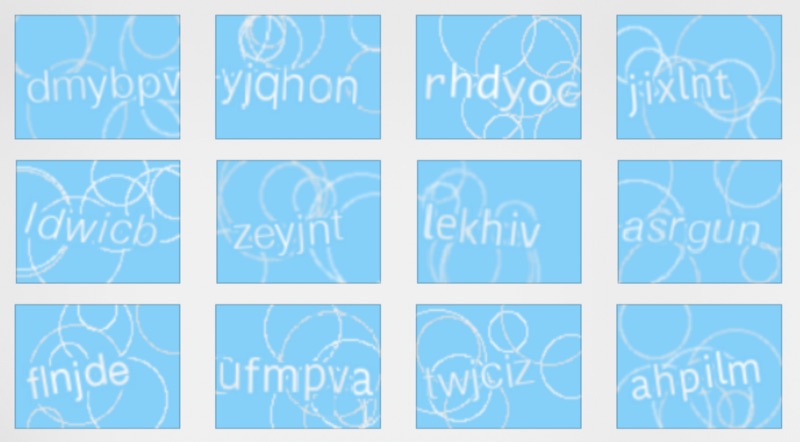
Künstliche CAPTCHAs
Es hat etwas Mühe gekostet, die Zufälligkeit gleich aussehen zu lassen, und zum Glück hatte das Ziel-CAPTCHA ziemlich begrenzte Eigenschaften. Ich habe ein paar zufällige Schriftarten gewählt und verschiedene Kreise um die Buchstaben gezeichnet. Als Nächstes ging es darum, die Modellarchitektur und die Ground-Truth-Labels festzulegen.
Modellarchitektur
Das einfachste Format für die Ground-Truth-Daten wäre, dass das Modell automatisch die gesamte Zeichenfolge ausgibt. Wenn wir zum Beispiel wissen, dass es immer nur sechs Buchstaben gibt, könnten wir das Modell mit sechs Ausgaben mit One-Hot-kodierten Buchstaben bauen. Alternativ könnte man eine Art rekurrente Struktur verwenden, die eine Buchstabenfolge ausgibt. Ich habe einen anderen Weg gewählt, da ich nicht sicher war, ob diskrete Ausgaben pro Buchstabe gut genug funktionieren würden, und der RNN-Ansatz für einen Nachmittag Arbeit etwas zu ambitioniert schien.
Ich beschloss, die Aufgabe in zwei Stufen aufzuteilen: Die erste Stufe führt eine semantische Segmentierung durch, um die Buchstaben vom verrauschten Hintergrund zu trennen, und die zweite führt eine Zeichenerkennung für jeden einzelnen Buchstaben durch.
Stufe 1 (Segmentierung)
Da das CAPTCHA 6 Buchstaben hat, habe ich ein Standard-Netz zur semantischen Segmentierung mit 7 Kategorien (Hintergrund und Zeichen 1 bis 6) auf etwa 20.000 künstlichen Bildern trainiert.
Hier ist ein Beispielbild zusammen mit den Segmentierungsmasken für das Training. Jeder Buchstabe hat sein eigenes Label.
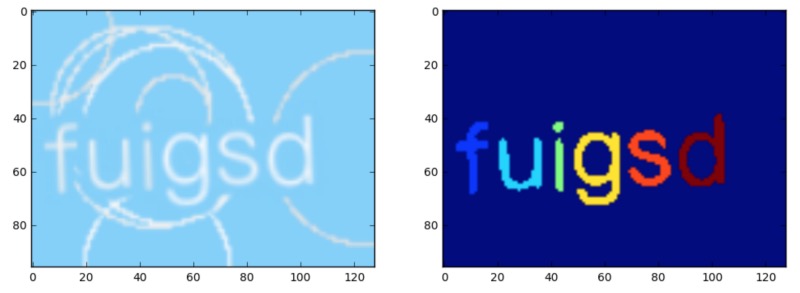
Beispiel-CAPTCHA mit Trainingsmasken
Für das Netz habe ich dieses praktische Repository verwendet: github.com/divamgupta/image-segmentation-keras, das eine einfache Trainings-API und viele Beispielarchitekturen zur Auswahl enthält. Schon nach wenigen Minuten Training sahen die Ergebnisse recht gut aus. Hier ist die Ausgabe des Netzes für das obige Originalbild:
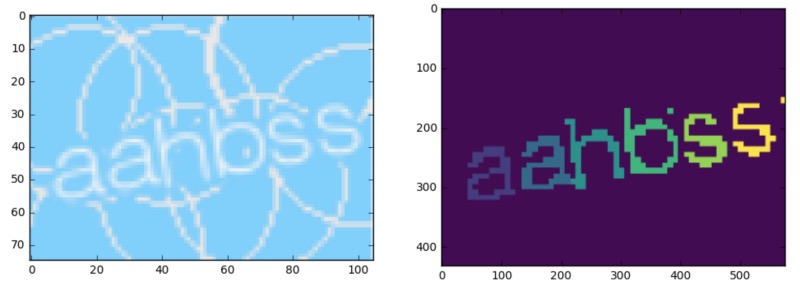
Vorhersageausgabe des Netzes
Stufe 2 (Klassifikation)
Die Ausgabe der ersten Stufe liefert für jeden Buchstaben eine eigene Pixelmaske. Mit dieser Maske können wir jeden Buchstaben einzeln verarbeiten, statt zu versuchen, das gesamte Bild auf einmal zu lösen. Für diese Stufe habe ich eine sehr einfache Keras-Architektur gewählt, die gegenüber diesem Artikel leicht abgewandelt wurde: medium.com/@ageitgey/how-to-break-a-captcha-system-in-15-minutes-with-machine-learning
Sie ist ziemlich einfach:
# Build the neural network!
model = keras.Sequential()

# First convolutional layer with max pooling
model.add(Conv2D(32, (5, 5), padding="same", input_shape=(32, 32, 2), activation="relu"))
model.add(MaxPooling2D(pool_size=(2, 2), strides=(2, 2)))

# Second convolutional layer with max pooling
model.add(Conv2D(50, (5, 5), padding="same", activation="relu"))
model.add(MaxPooling2D(pool_size=(2, 2), strides=(2, 2)))

# Hidden layer with 500 nodes
model.add(Flatten())
model.add(Dense(500, activation="relu"))

# Output layer for 26 characters
model.add(Dense(26, activation="softmax"))

# Ask Keras to build the TensorFlow model behind the scenes
model.compile(loss="categorical_crossentropy", optimizer="adam", metrics=["accuracy"])
Um dieses Netz zu trainieren, habe ich meine ursprünglichen Trainingsdaten durch mein trainiertes Netz der Stufe 1 laufen lassen, um Ausschnitte einzelner Buchstaben zusammen mit der Maske zu erzeugen, die mein Netz der Stufe 1 liefern würde. Indem ich dem Netz der Stufe 2 sowohl die Maske als auch den zugeschnittenen Graustufenausschnitt des Buchstabens gebe, hoffte ich, die Aufgabe der Buchstabenvorhersage gegenüber dem Buchstabenbild allein zu erleichtern.
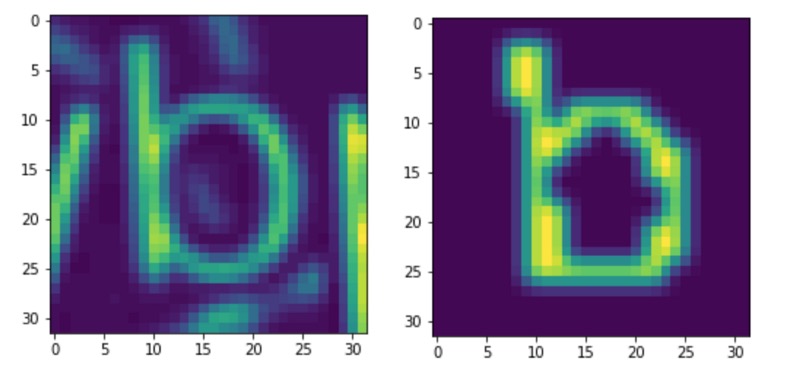
Graustufenausschnitt und Maskenausgabe aus Stufe 1
Die Eingabe des Netzes ist (32,32,2): Die zwei Eingabekanäle entsprechen dem ursprünglichen Bildausschnitt und der Ausgabemaske der Stufe 1 für einen einzelnen Buchstaben.
Fügt man beides zusammen, können wir einfach jeden Buchstaben durchlaufen und klassifizieren. Überraschenderweise funktionierte das Netz ziemlich gut. Das Netz muss auch nicht zu 100 % genau sein; wenn es scheitert, können wir es einfach erneut versuchen, bis es klappt (sofern die Anzahl der Versuche nicht begrenzt ist)
Zusammenarbeit mit Laan Labs
Computer-Vision- & KI-Entwicklung
Individuelle Computer Vision und maschinelles Lernen, vom Proof of Concept bis zur Produktion, auf dem Gerät und in der Cloud.
Diesen Artikel herunterladen
Markdown-Quelltext zum Offline-Lesen herunterladen