Des données synthétiques pour résoudre un CAPTCHA retors

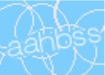
Exemple de CAPTCHA
Au cours d'un projet, nous avons rencontré un CAPTCHA d'image en utilisant un logiciel que nous payons. Nous devions automatiser ce logiciel pour qu'il tourne pendant la nuit, et nous ne pouvions donc pas remplir les CAPTCHA à la main à chaque fois. De façon générale, les CAPTCHA présentent de nombreux inconvénients, comme celui de ne pas être accessibles aux utilisateurs aveugles et malvoyants. Ils ne sont d'ailleurs plus considérés comme très efficaces.
Il nous fallait une solution rapidement, idéalement en quelques heures de bidouillage. Cela semblait un bon cas d'usage pour les données synthétiques et le machine learning.
Génération des données
Le défi évident, pour résoudre un CAPTCHA de ce genre, est de produire quelques milliers d'images d'entraînement dont on connaît la réponse. Notre approche a consisté à utiliser une bibliothèque graphique pour générer aléatoirement autant d'images que nécessaire, assez proches du CAPTCHA d'origine. Comme nous connaissons déjà les caractères utilisés pour générer nos fausses images, nous pouvons entraîner notre modèle à prédire ces réponses.
J'ai utilisé le module ImageDraw de PIL pour créer des images similaires ; en voici quelques exemples :
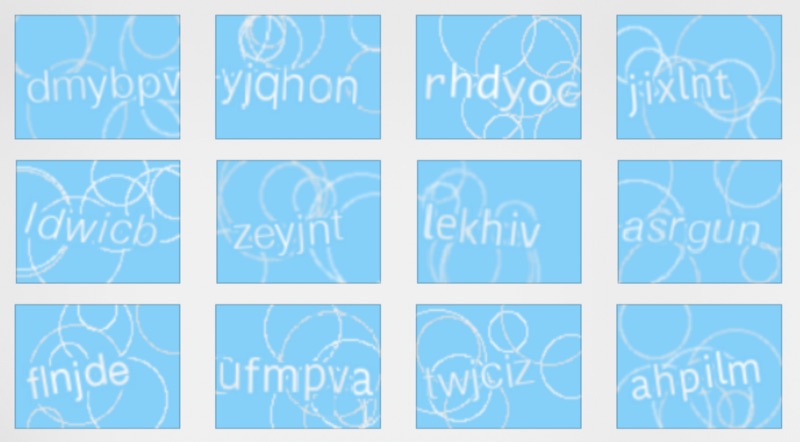
CAPTCHA artificiels
Il a fallu un certain effort pour que l'aspect aléatoire ressemble à l'original ; et, heureusement, le CAPTCHA visé avait des caractéristiques assez limitées. J'ai choisi quelques polices aléatoires et dessiné divers cercles autour des lettres. Reste ensuite à déterminer l'architecture du modèle et les étiquettes de vérité terrain.
Architecture du modèle
Le format le plus simple possible pour les données de vérité terrain serait que le modèle produise automatiquement la chaîne complète de lettres. Par exemple, si nous savons qu'il n'y aura jamais que six lettres, nous pourrions construire le modèle avec six sorties de lettres encodées en one-hot. On pourrait aussi utiliser une sorte de structure récurrente pour produire une séquence de lettres. J'ai choisi une autre voie, car je n'étais pas sûr que des sorties discrètes par lettre fonctionneraient assez bien, et l'approche par RNN me semblait un peu hors de portée pour un après-midi de travail.
J'ai décidé de scinder la tâche en deux étapes : la première réaliserait une segmentation sémantique pour séparer les lettres de l'arrière-plan bruité, et la seconde effectuerait la reconnaissance de caractères sur chaque lettre individuelle.
Étape 1 (segmentation)
Comme le CAPTCHA comporte 6 lettres, j'ai entraîné un réseau de segmentation sémantique standard avec 7 catégories (l'arrière-plan et les caractères 1 à 6) sur environ 20 000 images artificielles.
Voici une image exemple avec les masques de segmentation d'entraînement. Chaque lettre a sa propre étiquette.
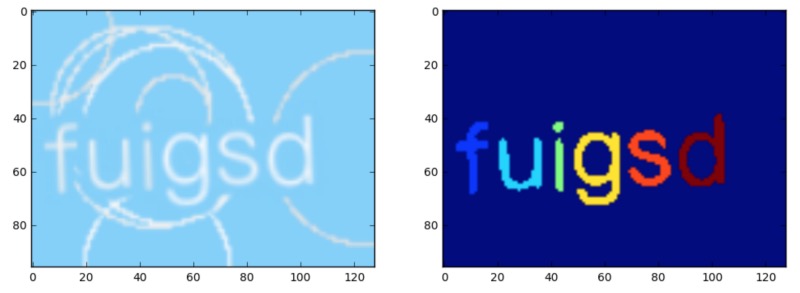
Exemple de CAPTCHA avec masques d'entraînement
Pour le réseau, j'ai utilisé ce bon dépôt : github.com/divamgupta/image-segmentation-keras, qui contient une API d'entraînement simple et de nombreux exemples d'architectures de réseaux au choix. Après seulement quelques minutes d'entraînement, les résultats étaient plutôt bons. Voici la sortie du réseau sur l'image d'origine ci-dessus :
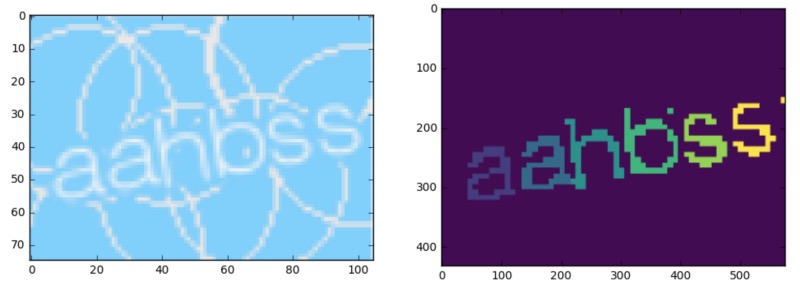
Sortie de la prédiction du réseau
Étape 2 (classification)
La sortie de l'étape 1 nous permet d'obtenir un masque de pixels distinct pour chaque lettre. Avec ce masque, nous pouvons traiter les lettres une à une plutôt que d'essayer de résoudre l'image entière d'un coup. Pour cette étape, j'ai choisi une architecture keras très simple, légèrement modifiée à partir de cet article : medium.com/@ageitgey/how-to-break-a-captcha-system-in-15-minutes-with-machine-learning
C'est assez simple :
# Build the neural network!
model = keras.Sequential()

# First convolutional layer with max pooling
model.add(Conv2D(32, (5, 5), padding="same", input_shape=(32, 32, 2), activation="relu"))
model.add(MaxPooling2D(pool_size=(2, 2), strides=(2, 2)))

# Second convolutional layer with max pooling
model.add(Conv2D(50, (5, 5), padding="same", activation="relu"))
model.add(MaxPooling2D(pool_size=(2, 2), strides=(2, 2)))

# Hidden layer with 500 nodes
model.add(Flatten())
model.add(Dense(500, activation="relu"))

# Output layer for 26 characters
model.add(Dense(26, activation="softmax"))

# Ask Keras to build the TensorFlow model behind the scenes
model.compile(loss="categorical_crossentropy", optimizer="adam", metrics=["accuracy"])
Pour entraîner ce réseau, j'ai fait passer mes données d'entraînement d'origine dans mon réseau d'étape 1 entraîné, afin de produire des recadrages de lettres isolées avec le masque que mon réseau d'étape 1 générerait. En donnant au réseau de l'étape 2 à la fois le masque et le recadrage en niveaux de gris de la lettre, j'espérais faciliter la prédiction de la lettre par rapport à l'utilisation de la seule image de la lettre.
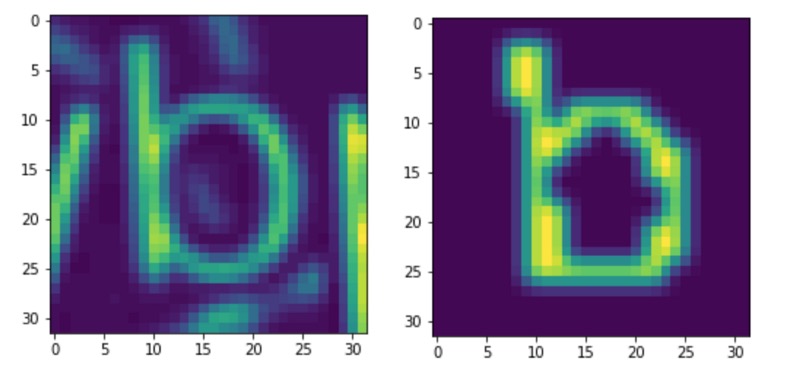
Recadrage en niveaux de gris et masque en sortie de l'étape 1
L'entrée du réseau est de dimension (32,32,2) : les deux canaux d'entrée correspondent au recadrage de l'image d'origine et au masque de sortie de l'étape 1 pour une seule lettre.
En assemblant les deux, il suffit de boucler sur chaque lettre et de la classer. Étonnamment, le réseau a plutôt bien fonctionné. Il n'a d'ailleurs pas besoin d'être précis à 100 % ; en cas d'échec, on peut simplement réessayer jusqu'à ce que cela marche (en supposant qu'il n'y ait pas de limite de tentatives)
Travailler avec Laan Labs
Développement de vision par ordinateur et d’IA
De la vision par ordinateur et du machine learning sur mesure, de la preuve de concept à la production, sur l’appareil comme dans le cloud.
Télécharger cet article
Récupérez la source Markdown pour le lire hors ligne