악명 높은 CAPTCHA를 푸는 합성 데이터

CAPTCHA 샘플
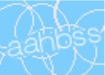
어떤 프로젝트를 진행하던 중, 비용을 내고 사용하는 소프트웨어에서 이미지 CAPTCHA를 만났습니다. 이 소프트웨어를 자동화해 밤새 실행해야 했기 때문에 매번 CAPTCHA를 직접 입력할 수는 없었습니다. 일반적으로 CAPTCHA에는 시각 장애인과 저시력 사용자가 접근할 수 없다는 등 단점이 많습니다. 게다가 이제는 그다지 효과적이라고 여겨지지도 않습니다.
우리는 빠른 해법이 필요했고, 이상적으로는 몇 시간 안에 해킹으로 끝내고 싶었습니다. 합성 데이터와 머신러닝을 활용하기 좋은 사례로 보였습니다.
데이터 생성
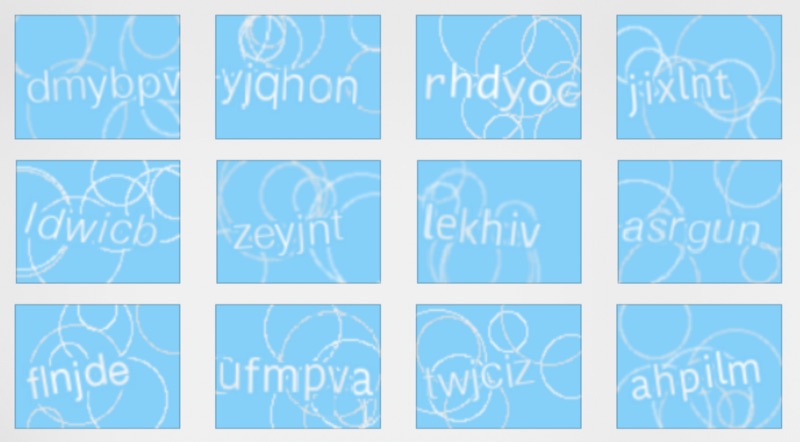
이런 CAPTCHA를 푸는 데 있어 가장 분명한 과제는 정답을 아는 학습 이미지 수천 장을 마련하는 것입니다. 우리의 접근 방식은 그래픽스 라이브러리를 사용해 원본 CAPTCHA와 충분히 비슷한 이미지를 필요한 만큼 무작위로 생성하는 것이었습니다. 가짜 이미지를 만들 때 사용한 문자를 이미 알고 있으므로, 모델이 그 정답을 예측하도록 학습시킬 수 있습니다.
PIL의 ImageDraw 모듈로 비슷한 이미지를 만들었으며, 샘플은 다음과 같습니다.
인공 CAPTCHA
무작위성이 원본과 같아 보이도록 만드는 데 약간의 노력이 들었습니다. 다행히 대상 CAPTCHA의 특성은 꽤 제한적이었습니다. 임의의 글꼴 몇 가지를 고르고, 글자 주위에 여러 가지 원을 그렸습니다. 다음 문제는 모델 아키텍처와 정답 레이블을 정하는 것입니다.
모델 아키텍처
정답 데이터의 가장 단순한 형식은 모델이 글자 전체 문자열을 자동으로 출력하게 하는 것입니다. 예를 들어 글자가 항상 여섯 개뿐이라는 것을 안다면, 원-핫 인코딩된 글자를 출력하는 출력 여섯 개를 가진 모델을 만들 수 있습니다. 또는 순환 구조를 사용해 글자 시퀀스를 출력하게 할 수도 있습니다. 저는 글자마다 개별 출력을 두는 방식이 충분히 잘 동작할지 확신이 없었고, RNN 접근법은 오후 한나절 작업으로는 무리라고 판단해 다른 길을 택했습니다.
작업을 두 단계로 나누기로 했습니다. 첫 번째 단계에서는 시맨틱 분할로 노이즈가 많은 배경에서 글자를 분리하고, 두 번째 단계에서는 각 글자에 대해 문자 인식을 수행합니다.
1단계(분할)
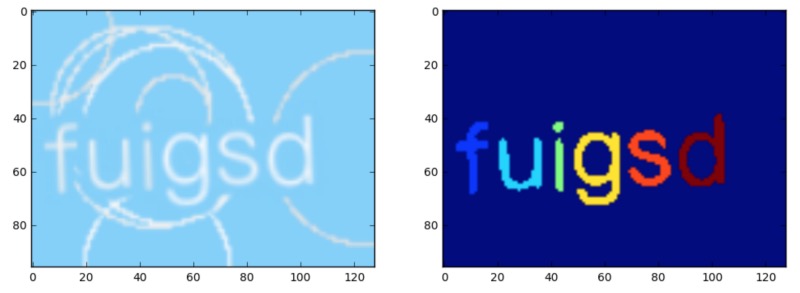
CAPTCHA의 글자는 6개이므로, 기성 시맨틱 분할 네트워크를 7개 카테고리(배경과 1~6번 문자)로 약 20,000장의 인공 이미지에 학습시켰습니다.
다음은 샘플 이미지와 학습용 분할 마스크입니다. 각 글자에는 고유한 레이블이 있습니다.
학습 마스크가 있는 CAPTCHA 샘플
네트워크로는 간단한 학습 API와 선택 가능한 여러 샘플 네트워크 아키텍처를 갖춘 훌륭한 저장소 github.com/divamgupta/image-segmentation-keras를 사용했습니다. 몇 분만 학습했는데도 결과가 꽤 좋았습니다. 위의 원본 이미지에 대한 네트워크 출력은 다음과 같습니다.
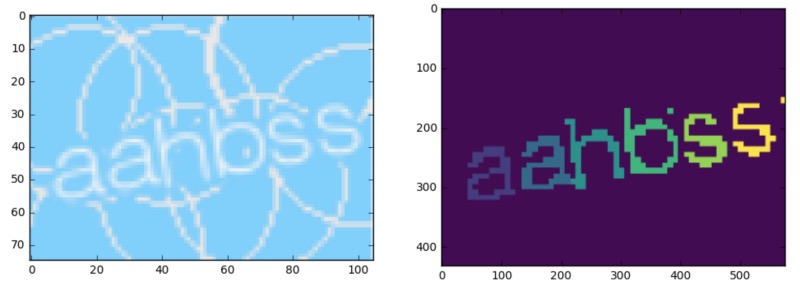
네트워크 예측 출력
2단계(분류)
1단계의 출력으로 각 글자의 픽셀 마스크를 따로 얻을 수 있습니다. 이 마스크를 이용하면 이미지 전체를 한꺼번에 풀려고 하지 않고 글자를 하나씩 처리할 수 있습니다. 이 단계에는 다음 글을 약간 변형한 아주 간단한 keras 아키텍처를 선택했습니다: medium.com/@ageitgey/how-to-break-a-captcha-system-in-15-minutes-with-machine-learning
꽤 단순합니다.
# Build the neural network!
model = keras.Sequential()

# First convolutional layer with max pooling
model.add(Conv2D(32, (5, 5), padding="same", input_shape=(32, 32, 2), activation="relu"))
model.add(MaxPooling2D(pool_size=(2, 2), strides=(2, 2)))

# Second convolutional layer with max pooling
model.add(Conv2D(50, (5, 5), padding="same", activation="relu"))
model.add(MaxPooling2D(pool_size=(2, 2), strides=(2, 2)))

# Hidden layer with 500 nodes
model.add(Flatten())
model.add(Dense(500, activation="relu"))

# Output layer for 26 characters
model.add(Dense(26, activation="softmax"))

# Ask Keras to build the TensorFlow model behind the scenes
model.compile(loss="categorical_crossentropy", optimizer="adam", metrics=["accuracy"])
이 네트워크를 학습시키기 위해 원본 학습 데이터를 학습된 1단계 네트워크에 통과시켜, 글자 하나씩 잘라낸 크롭 이미지와 1단계 네트워크가 만든 마스크를 얻었습니다. 2단계 네트워크에 글자의 그레이스케일 크롭 이미지와 함께 마스크도 주면, 글자 이미지만 사용할 때보다 글자를 예측하는 일이 쉬워지기를 기대했습니다.
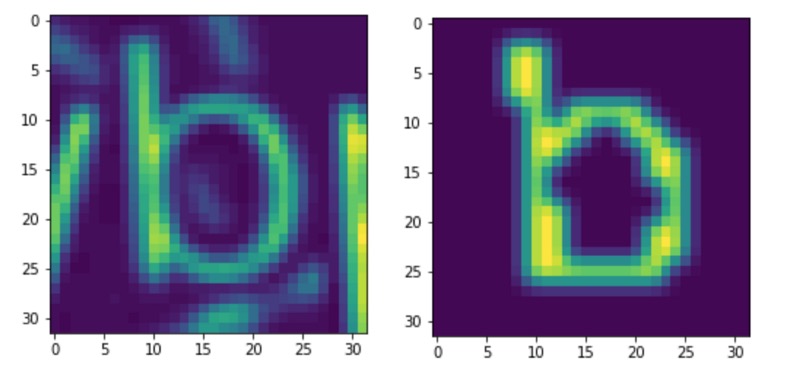
1단계의 그레이스케일 크롭과 마스크 출력
네트워크의 입력은 (32,32,2)입니다. 두 입력 채널은 글자 하나에 대한 원본 이미지 크롭과 1단계 출력 마스크에 해당합니다.
이 두 가지를 합치면 각 글자를 순회하며 분류할 수 있습니다. 놀랍게도 네트워크는 꽤 잘 동작했습니다. 네트워크가 100% 정확할 필요도 없습니다. 실패하면 성공할 때까지 다시 시도하면 되기 때문입니다(재시도 횟수에 제한이 없다고 가정할 때).
Laan Labs와 함께하기
컴퓨터 비전 및 AI 개발
개념 증명부터 상용화까지, 기기 내와 클라우드에서 동작하는 맞춤형 컴퓨터 비전 및 머신러닝을 제공합니다.
이 글 다운로드
오프라인에서 읽을 수 있는 마크다운 원본을 받으십시오