合成データでやっかいなCAPTCHAを解く

CAPTCHAのサンプル
あるプロジェクトの最中に、私たちが料金を払って使っているソフトウェアで、画像のCAPTCHAに遭遇しました。このソフトウェアを自動化して一晩中動かす必要があり、毎回手動でCAPTCHAを入力するわけにはいきませんでした。CAPTCHAには一般に多くの欠点があり、たとえば視覚障害のあるユーザーにとってアクセシブルではありません。そもそもあまり効果的とは考えられなくなっています。
私たちは、できれば数時間のハッキングで済むような、素早い解決策を求めていました。これは、合成データと機械学習の好適なユースケースに思えました。
データ生成
このようなCAPTCHAを解くうえでの明らかな課題は、答えがわかっている数千枚の学習用画像を用意することです。私たちのアプローチは、グラフィックスライブラリを使い、元のCAPTCHAと十分によく似た画像を必要な数だけランダムに生成するというものでした。偽の画像を生成するのに使った文字はすでにわかっているので、モデルにその答えを予測させるよう学習させられます。
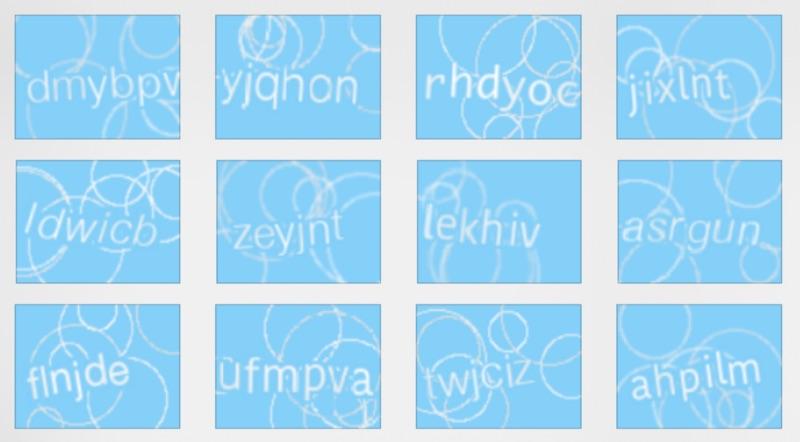
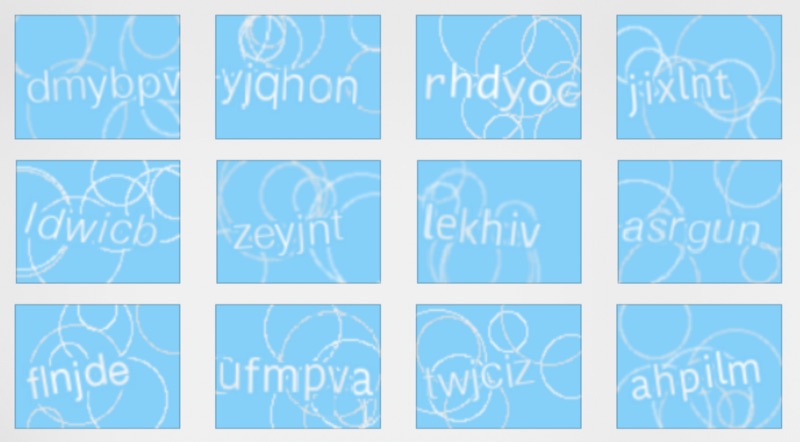
PILのImageDrawモジュールを使って似た画像を作成しました。いくつかのサンプルを紹介します。
人工的に作ったCAPTCHA
ランダム性を同じように見せるにはある程度の労力が必要でしたが、幸い、対象のCAPTCHAの特徴はかなり限られていました。ランダムなフォントをいくつか選び、文字の周りにさまざまな円を描きました。次の課題は、モデルのアーキテクチャと正解ラベルをどうするかです。
モデルのアーキテクチャ
正解データの形式として最も単純なのは、モデルに文字列全体を自動的に出力させることでしょう。たとえば、文字が常に6文字だけだとわかっているなら、one-hotエンコードした文字を6つ出力するモデルを作れます。あるいは、何らかの再帰構造を使って文字列を出力させる方法もあります。私は別の道を選びました。文字ごとに離散的な出力を持たせて十分にうまくいくか確信が持てなかったうえ、RNNのアプローチは、午後1回の作業で扱うには少し手に余るように思えたからです。
そこで、このタスクを2段階に分けることにしました。第1段階では、セマンティックセグメンテーションを行って、文字をノイズの多い背景から切り離し、第2段階では、個々の文字に対して文字認識を行います。
第1段階(セグメンテーション)
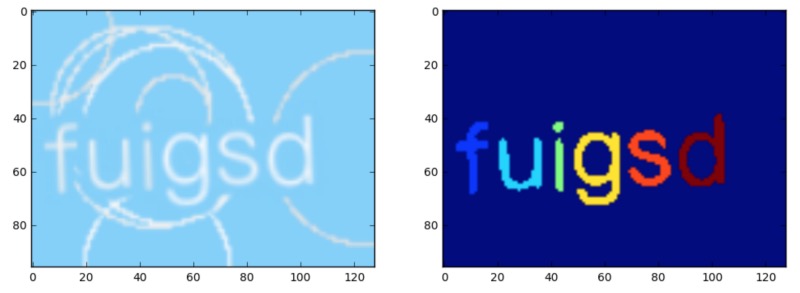
CAPTCHAには6文字あるため、既製のセマンティックセグメンテーションネットワークを、7つのカテゴリ(背景と、1〜6番目の文字)で、約2万枚の人工画像を使って学習させました。
学習用のマスクとともに、サンプル画像を示します。各文字には、それぞれ固有のラベルがあります。
学習用マスク付きのCAPTCHAサンプル
ネットワークには、こちらの優れたリポジトリを使いました。github.com/divamgupta/image-segmentation-keras シンプルな学習APIと、選べる多数のサンプルネットワークアーキテクチャが含まれています。わずか数分の学習で、結果はかなり良さそうに見えました。上の元の画像に対するネットワークの出力は次のとおりです。
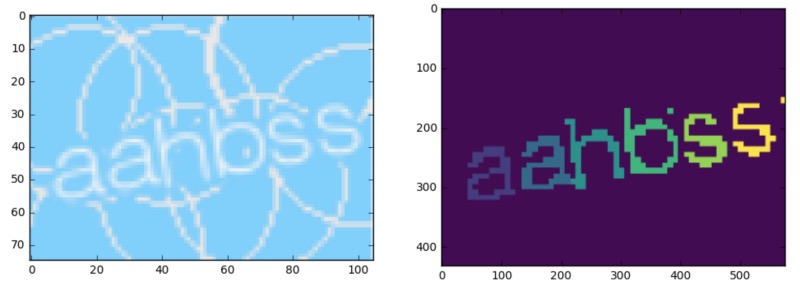
ネットワークの予測出力
第2段階(分類)
第1段階の出力から、文字ごとに別々のピクセルマスクが得られます。このマスクを使えば、画像全体を一度に解こうとするのではなく、1文字ずつ処理できます。この段階では、この記事を少し改変した、非常にシンプルなkerasのアーキテクチャを選びました。medium.com/@ageitgey/how-to-break-a-captcha-system-in-15-minutes-with-machine-learning
とてもシンプルです。
# Build the neural network!
model = keras.Sequential()

# First convolutional layer with max pooling
model.add(Conv2D(32, (5, 5), padding="same", input_shape=(32, 32, 2), activation="relu"))
model.add(MaxPooling2D(pool_size=(2, 2), strides=(2, 2)))

# Second convolutional layer with max pooling
model.add(Conv2D(50, (5, 5), padding="same", activation="relu"))
model.add(MaxPooling2D(pool_size=(2, 2), strides=(2, 2)))

# Hidden layer with 500 nodes
model.add(Flatten())
model.add(Dense(500, activation="relu"))

# Output layer for 26 characters
model.add(Dense(26, activation="softmax"))

# Ask Keras to build the TensorFlow model behind the scenes
model.compile(loss="categorical_crossentropy", optimizer="adam", metrics=["accuracy"])
このネットワークを学習させるために、元の学習データを、学習済みの第1段階のネットワークに通し、1文字ずつの切り出し画像と、第1段階のネットワークが生成するマスクを作りました。第2段階のネットワークに、マスクと、文字を切り出したグレースケール画像の両方を与えることで、文字の画像だけを使う場合よりも、文字の予測を簡単にできることを狙いました。
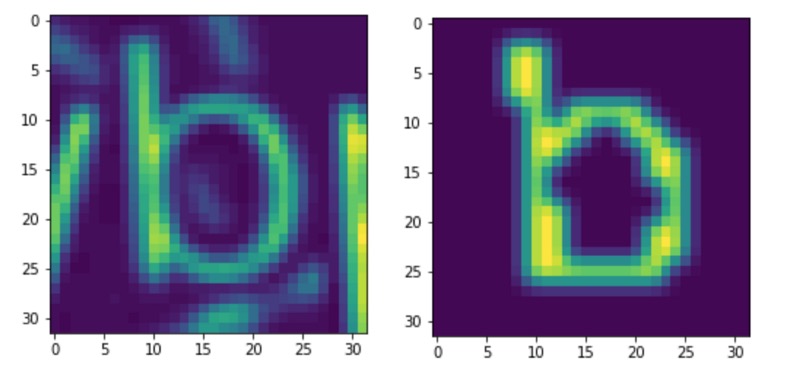
第1段階から出力されたグレースケールの切り出し画像とマスク
ネットワークへの入力は(32,32,2)で、2つの入力チャンネルは、元画像の切り出しと、1文字分の第1段階の出力マスクに対応します。
この2つを組み合わせれば、1文字ずつループして分類するだけです。驚いたことに、ネットワークはかなりうまく機能しました。ネットワークの精度が100%である必要もありません。失敗した場合は、うまくいくまで再試行すればよいのです(再試行の回数に制限がない場合に限りますが)。
Laan Labs と協業する
コンピュータビジョン・AI開発
概念実証から本番運用まで、オンデバイスでもクラウドでも対応するカスタムのコンピュータビジョンと機械学習を提供します。
この記事をダウンロード
オフラインで読めるMarkdownソースを入手できます