用合成数据破解一个讨厌的验证码

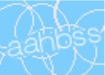
验证码样例
在一个项目中,我们在使用一款付费软件时遇到了图像验证码。我们需要让这个软件自动运行一整夜,所以没法每次都手动填写验证码。总的来说,验证码有很多缺点,比如对盲人和视障用户而言无法使用。而且它们也不再被认为是很有效的手段了。
我们需要尽快拿出解决方案,最好在几个小时的折腾之内搞定。这看起来是合成数据与机器学习的一个好用例。
数据生成
破解这样的验证码,最明显的难题是要弄出几千张已知答案的训练图像。我们的做法是使用图形库,随机生成任意多的图像,让它们看起来与原版验证码足够相似。由于我们已经知道生成这些假图像所用的字符,就可以训练模型去预测这些答案。
我用 PIL 的 ImageDraw 模块来创建类似的图像,下面是几个样例:
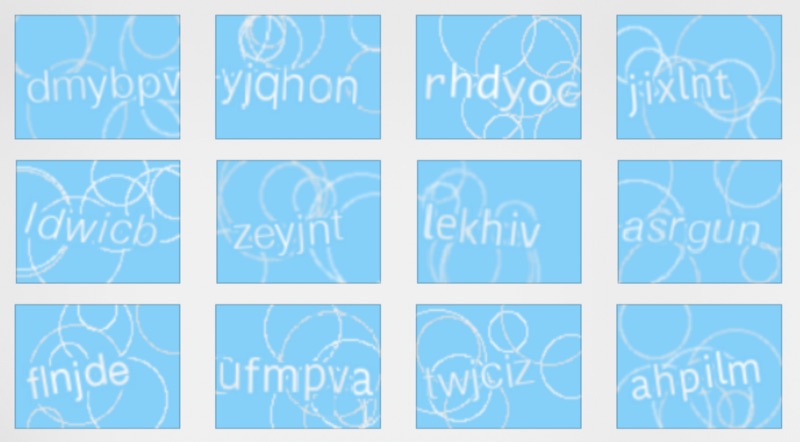
人工合成的验证码
要让随机性看起来与原版一致,需要花一些功夫;好在目标验证码的特征相当有限。我挑选了几种随机字体,并在字母周围画上各种圆圈。接下来的问题是确定模型架构和真值标签。
模型架构
我们能想到的最简单的真值数据格式,是让模型自动输出完整的字母串。例如,如果知道永远只有六个字母,就可以把模型做成有六个输出,每个输出是 one-hot 编码的字母。或者,你也可以使用某种循环结构来输出字母序列。我选择了另一条路,因为我不确定为每个字母设置离散输出是否足够有效,而 RNN 的方案对于一个下午的工作量来说似乎有点够不着。
我决定把任务拆成两个阶段:第一阶段做语义分割,把字母从嘈杂的背景中分离出来;第二阶段对每个单独的字母做字符识别。
第 1 阶段(分割)
由于验证码有 6 个字母,我在大约 20,000 张人工合成图像上,训练了一个现成的语义分割网络,包含 7 个类别(背景,以及第 1 到第 6 个字符)。
下面是一张样例图像,以及用于训练的分割遮罩。每个字母都有自己的标签。
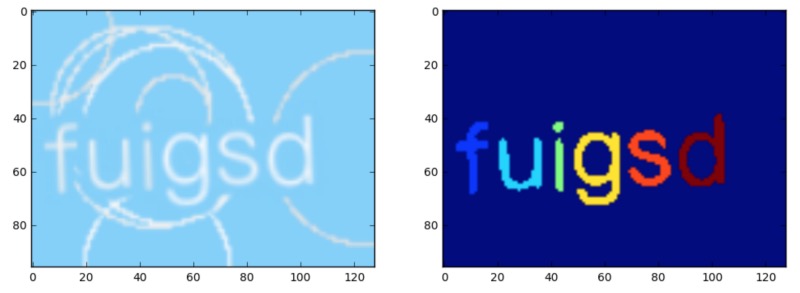
带训练遮罩的验证码样例
网络方面,我使用了这里一个很棒的仓库:github.com/divamgupta/image-segmentation-keras,它提供了简单的训练 API,以及许多可供选择的示例网络架构。仅仅训练了几分钟,结果就看起来相当不错。下面是网络在上面那张原始图像上的输出:
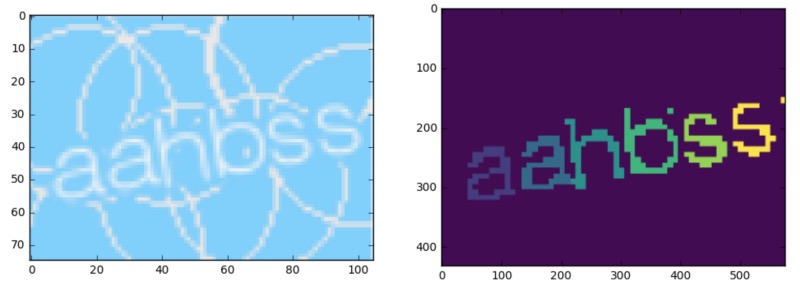
网络预测输出
第 2 阶段(分类)
第一阶段的输出让我们能为每个字母得到单独的像素遮罩。有了这个遮罩,我们就可以逐个处理每个字母,而不是试图一次解决整张图像。这一阶段,我选择了一个非常简单的 keras 架构,稍微修改自这篇文章:medium.com/@ageitgey/how-to-break-a-captcha-system-in-15-minutes-with-machine-learning
它非常简单:
# Build the neural network!
model = keras.Sequential()

# First convolutional layer with max pooling
model.add(Conv2D(32, (5, 5), padding="same", input_shape=(32, 32, 2), activation="relu"))
model.add(MaxPooling2D(pool_size=(2, 2), strides=(2, 2)))

# Second convolutional layer with max pooling
model.add(Conv2D(50, (5, 5), padding="same", activation="relu"))
model.add(MaxPooling2D(pool_size=(2, 2), strides=(2, 2)))

# Hidden layer with 500 nodes
model.add(Flatten())
model.add(Dense(500, activation="relu"))

# Output layer for 26 characters
model.add(Dense(26, activation="softmax"))

# Ask Keras to build the TensorFlow model behind the scenes
model.compile(loss="categorical_crossentropy", optimizer="adam", metrics=["accuracy"])
为了训练这个网络,我把原始训练数据送入已训练好的第 1 阶段网络,得到单个字母的裁剪图,以及第 1 阶段网络会产生的遮罩。同时给第 2 阶段网络提供遮罩和裁剪出的字母灰度图,我希望这样比只使用字母图像本身,能让预测字母的任务更轻松。
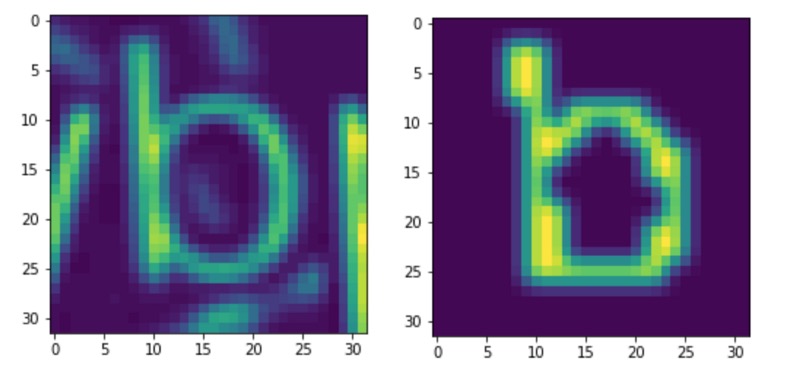
第 1 阶段输出的灰度裁剪图与遮罩
网络的输入是 (32,32,2):两个输入通道分别对应原始图像裁剪图,以及单个字母在第 1 阶段输出的遮罩。
把这两者合在一起,我们就可以遍历每个字母并对其分类。出人意料的是,这个网络效果相当不错。网络也不需要 100% 准确;如果失败了,我们只要重试到成功为止即可(假设重试次数没有限制)
与 Laan Labs 合作
计算机视觉与 AI 开发
定制计算机视觉与机器学习,从概念验证到正式投产,支持设备端与云端。
下载本文
获取 Markdown 源文件,方便离线阅读