Datos sintéticos para resolver un CAPTCHA endiablado

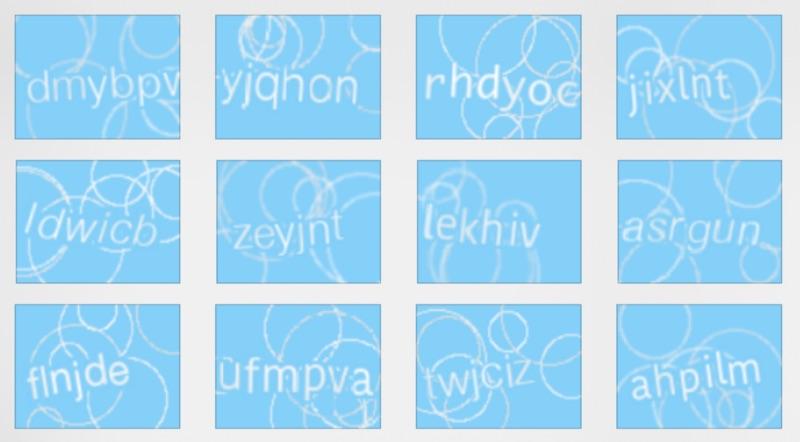
CAPTCHA de ejemplo
En el transcurso de un proyecto nos topamos con un CAPTCHA de imagen al usar un programa por el que pagamos. Necesitábamos automatizar el programa para que se ejecutara durante la noche, así que no podíamos rellenar los CAPTCHA a mano cada vez. En general los CAPTCHA tienen muchos inconvenientes, como no ser accesibles para usuarios ciegos o con discapacidad visual. Además, ya no se consideran muy eficaces.
Necesitábamos una solución rápida, idealmente en unas pocas horas de trabajo. Parecía un buen caso de uso para los datos sintéticos y el machine learning.
Generación de datos
El reto evidente al resolver un CAPTCHA como este es conseguir unos miles de imágenes de entrenamiento de las que conozcamos la respuesta. Nuestro enfoque fue usar una biblioteca gráfica para generar aleatoriamente tantas imágenes como necesitáramos, lo bastante parecidas al CAPTCHA original. Como ya conocemos los caracteres con los que generamos nuestras imágenes falsas, podemos entrenar el modelo para que prediga esas respuestas.
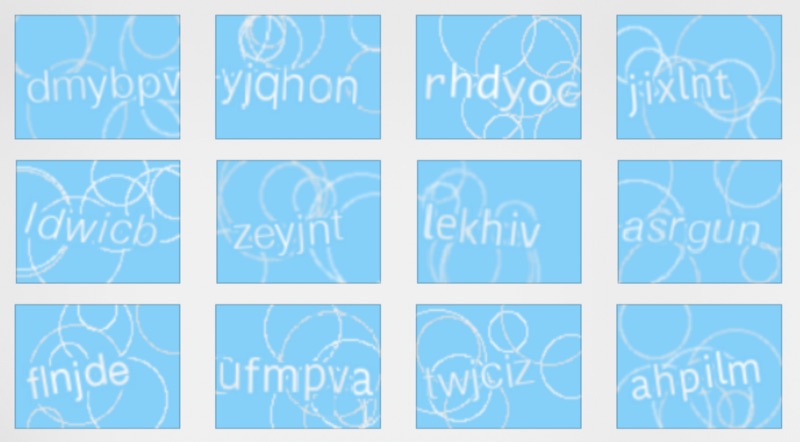
Usé el módulo ImageDraw de PIL para crear imágenes similares; aquí hay algunas muestras:
CAPTCHA artificiales
Costó cierto esfuerzo lograr que la aleatoriedad se pareciera; por suerte, el CAPTCHA objetivo tenía un conjunto de características bastante limitado. Elegí algunas fuentes al azar y dibujé círculos variados alrededor de las letras. El siguiente problema es decidir la arquitectura del modelo y las etiquetas de referencia (ground truth).
Arquitectura del modelo
El formato más sencillo posible para los datos de referencia sería que el modelo devolviera automáticamente la cadena completa de letras. Por ejemplo, si sabemos que siempre habrá seis letras, podríamos construir el modelo con seis salidas con las letras codificadas en one-hot. Otra alternativa sería usar algún tipo de estructura recurrente para generar una secuencia de letras. Opté por otro camino, porque no estaba seguro de que tener salidas discretas por letra funcionara lo bastante bien, y el enfoque con RNN parecía fuera de alcance para una tarde de trabajo.
Decidí dividir la tarea en dos etapas: la primera realizaría segmentación semántica para separar las letras del fondo ruidoso, y la segunda realizaría el reconocimiento de caracteres de cada letra por separado.
Etapa 1 (segmentación)
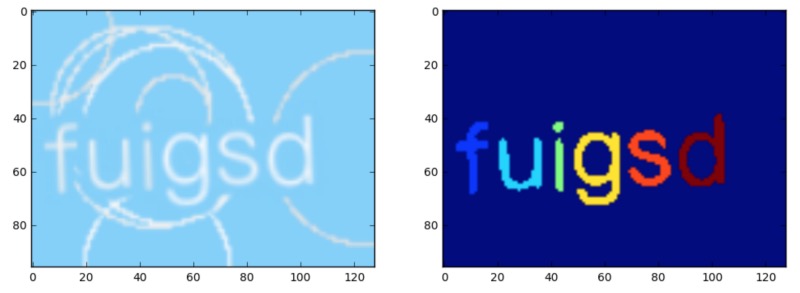
Como el CAPTCHA tiene 6 letras, entrené una red de segmentación semántica estándar con 7 categorías (el fondo y los caracteres del 1 al 6) con unas 20 000 imágenes artificiales.
Aquí hay una imagen de ejemplo junto con las máscaras de segmentación para el entrenamiento. Cada letra tiene su propia etiqueta.
CAPTCHA de ejemplo con máscaras de entrenamiento
Para la red usé este estupendo repositorio: github.com/divamgupta/image-segmentation-keras, que contiene una API de entrenamiento sencilla y muchas arquitecturas de red de ejemplo entre las que elegir. Tras solo unos minutos de entrenamiento, los resultados tenían buena pinta. Esta es la salida de la red sobre la imagen original de arriba:
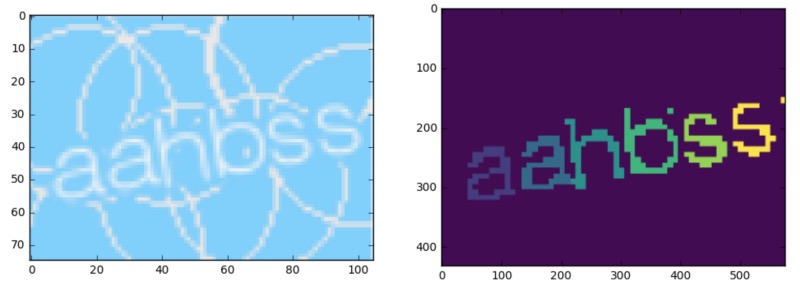
Resultado de la predicción de la red
Etapa 2 (clasificación)
La salida de la primera etapa nos permite obtener una máscara de píxeles independiente para cada letra. Con esta máscara podemos procesar cada letra una por una en lugar de intentar resolver la imagen completa de una vez. Para esta etapa elegí una arquitectura de Keras muy sencilla, ligeramente modificada a partir de este artículo: medium.com/@ageitgey/how-to-break-a-captcha-system-in-15-minutes-with-machine-learning
Es bastante simple:
# Build the neural network!
model = keras.Sequential()

# First convolutional layer with max pooling
model.add(Conv2D(32, (5, 5), padding="same", input_shape=(32, 32, 2), activation="relu"))
model.add(MaxPooling2D(pool_size=(2, 2), strides=(2, 2)))

# Second convolutional layer with max pooling
model.add(Conv2D(50, (5, 5), padding="same", activation="relu"))
model.add(MaxPooling2D(pool_size=(2, 2), strides=(2, 2)))

# Hidden layer with 500 nodes
model.add(Flatten())
model.add(Dense(500, activation="relu"))

# Output layer for 26 characters
model.add(Dense(26, activation="softmax"))

# Ask Keras to build the TensorFlow model behind the scenes
model.compile(loss="categorical_crossentropy", optimizer="adam", metrics=["accuracy"])
Para entrenar esta red pasé mis datos de entrenamiento originales por mi red de la etapa 1 ya entrenada, para producir recortes de letras individuales junto con la máscara que generaría mi red de la etapa 1. Al darle a la red de la etapa 2 tanto la máscara como el recorte en escala de grises de la letra, esperaba facilitar la tarea de predecir la letra respecto a usar solo la imagen de la letra.
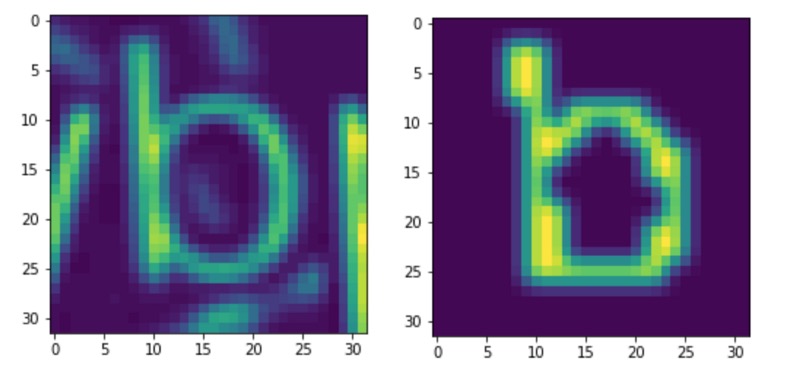
Recorte en escala de grises y máscara de salida de la etapa 1
La entrada de la red es (32,32,2): los dos canales de entrada corresponden al recorte de la imagen original y a la máscara de salida de la etapa 1 para una sola letra.
Al combinar ambas cosas, basta con recorrer cada letra y clasificarla. Sorprendentemente, la red funcionó bastante bien. Tampoco hace falta que la red sea precisa al 100 %; si falla, podemos volver a intentarlo hasta que funcione (suponiendo que no haya límite de reintentos)
Trabaje con Laan Labs
Desarrollo de visión por computador e IA
Visión por computador y aprendizaje automático a medida, de la prueba de concepto a la producción, en el dispositivo y en la nube.
Descargar este artículo
Obtenga el código fuente en Markdown para leerlo sin conexión